Weaver
企业专属模型训练平台
基于企业数据训练专属模型,支持通过 Tinker API 进行 SFT、RL、LoRA、Jev 与 Embedding 训练,权重归企业所有。
- 领域训练基于企业数据与业务验收标准开展领域训练,覆盖生成模型、Jev 与 Embedding 模型;支持 LoRA、全量微调与 NexRL 强化学习,按任务选择训练方式。训练效果以企业业务评测为准。
- 托管训练提供 Python 原语级训练接口,数据、损失函数与评估逻辑由算法团队定义;GPU 调度、并行训练与故障恢复由平台承担,企业无需自建训练集群;Multi-LoRA 共享基座,同等 GPU 可服务 30 个以上 LoRA 模型。
- 模型管理集中记录模型、指标、检查点与资源用量,支持中断恢复与实验对比;通过评测的模型权重可导出,由企业自行保存和部署。
专属模型归企业所有
训练任务、数据与验收标准由企业确定,新数据可通过训练接口持续进入迭代;通过评测的模型权重可导出,由企业自行保存和部署。
企业数据领域训练
业务经验无需交给模型厂商,企业即可拥有适配自身业务的模型。企业专业任务有特定的流程、术语与标准。基于企业数据开展生成模型、Jev 与 Embedding 模型的领域训练:生成模型适配业务流程与任务,Embedding 模型适配企业语义检索与匹配;具体训练目标与验收标准在项目中共同确定。训练后的模型可部署于企业自有环境。
DeepSWE v1.1
ProNex
MaxDeep
SeekGLM-5.3Kimi-K3GPT-5.6
SolClaude
Opus 5
Nex-N2.5 Pro / Max;其余模型沿用原材料版本。
SWE-Bench Pro
ProNex
MaxDeep
SeekKimi-K3GPT-5.6
SolGLM-5.3Claude
Opus 5
Nex-N2.5 Pro / Max;其余模型沿用原材料版本。
Terminal-Bench 2.1
ProNex
MaxDeep
SeekGLM-5.3Kimi-K3GPT-5.6
SolClaude
Opus 5
Nex-N2.5 Pro / Max;其余模型沿用原材料版本。
Toolathlon Verified
ProNex
MaxGLM-5.3Deep
SeekGPT-5.6
SolClaude
Opus 5Kimi-K3
Nex-N2.5 Pro / Max;其余模型沿用原材料版本。
AutomationBench v1.0.6
ProNex
MaxDeep
SeekGPT-5.6
SolKimi-K3GLM-5.3Claude
Opus 5
Nex-N2.5 Pro / Max;其余模型沿用原材料版本。
GDPval-AA v2
ProNex
MaxDeep
SeekKimi-K3GPT-5.6
SolGLM-5.3Claude
Opus 5
Nex-N2.5 Pro / Max;其余模型沿用原材料版本。
Mini · 35B / A3B;Pro · 397B / A17B;Max · 1.6T / A49B。覆盖软件工程、搜索研究与长程任务,Mini / Pro 支持视觉反馈与计算机操作。
LoRA、全量微调、NexRL 强化学习;企业标准与数据 → 训练与验证 → 模型服务接入。支持超过 1,000 steps 的 RL 长稳训练;训练与生产推理资源分别规划。
以业务评测为准的训练流程
训练是否成功,以企业的业务验收标准衡量。先确定任务与验收标准,再完成数据准备、训练与验证,通过评测的模型接入模型服务。训练效果以业务评测结果为准。
面向不同任务的模型训练
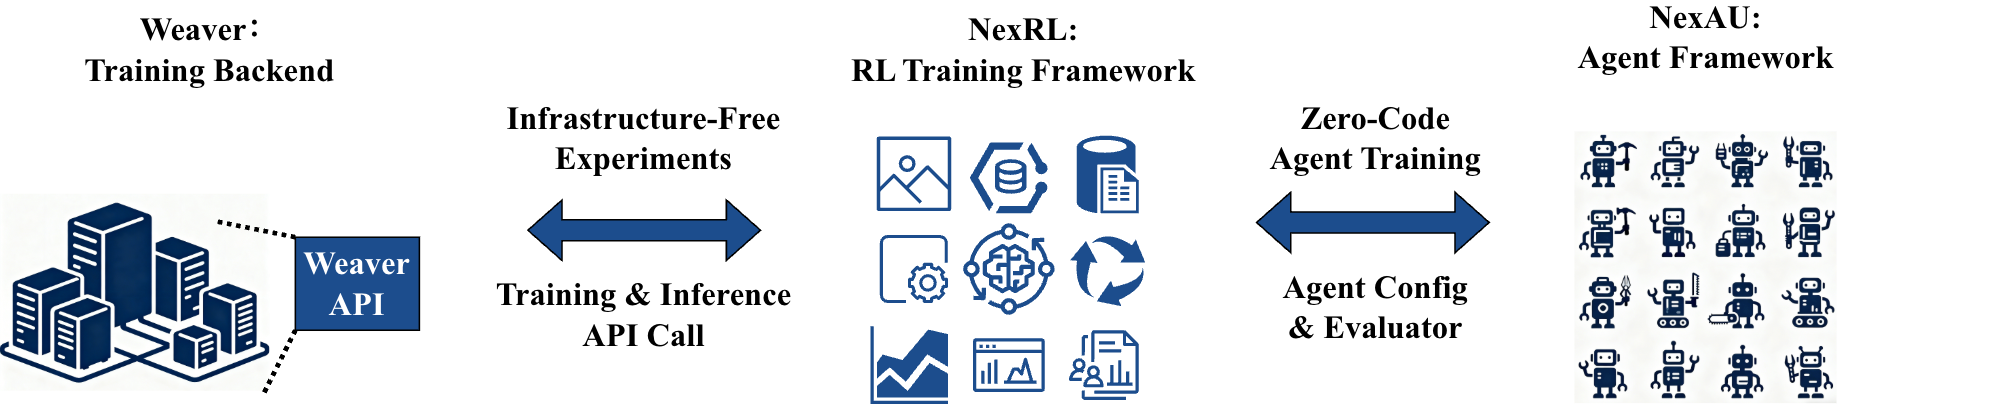
按业务目标选择模型类型与训练方式。领域训练支持 Jev 与 Embedding 模型训练,Embedding 训练用于适配企业语义检索与匹配。生成模型训练可采用 LoRA 快速实验与频繁更新,复杂任务可采用全量微调;提升工具调用与多步推理能力可采用 NexRL 强化学习,支持超过 1,000 步的长时稳定训练。
可编程训练接口与托管集群
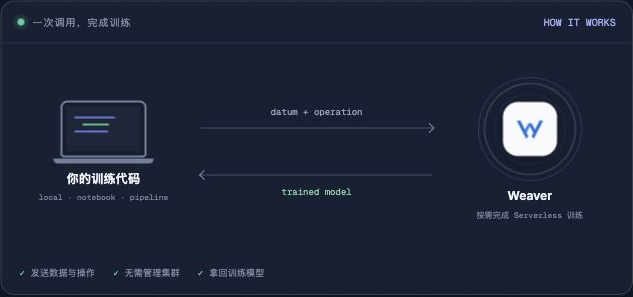
算法团队专注数据与算法,分布式训练的基础设施由平台承担。提供 Python 原语级接口,数据、损失函数、采样与评估逻辑由算法团队定义;GPU 调度、并行策略、故障恢复与弹性伸缩由平台负责,企业无需自建训练集群。
实验追踪与模型权重导出
每一次训练都可追溯、可对比,训练成果由企业保存。集中记录模型、指标、采样、检查点与资源用量;支持检查点中断恢复与实验横向对比,通过评测的模型权重可导出,由企业自行保存和部署。
Multi-LoRA 共享基座
同等算力可承载更多专属模型。多个 LoRA 任务共享同一基座模型。北坡测试中,同等 GPU 可同时服务 30 个以上 LoRA 模型,两个 LoRA 任务并行训练效率提升 30% 以上。
只训练低秩矩阵 A、B;计算量由 d² 降至 2dr(r ≪ d)。
在特定场景下,LoRA 与全量微调表现相当;原材料示例为 GSM8K。
共享基座权重,Adapter 独立计算;通过 batch GEMM 同时处理多个请求。
共享基座,同时选用各自 Adapter 计算;反向传播较复杂,原理一致。
原材料:单个 LoRA 训练约为 Full FT 计算量的 2/3,可节省约 30% 算力。
原材料:同等 GPU 可同时 serving 30+ 模型;2 个 LoRA 训练任务效率提升 30% 以上。
领域训练效果
以下结果来自各项目的业务评测,展示较小模型经领域训练后的任务表现与模型规模变化。
部署与交付
- 训练资源与生产推理资源分别规划,可按项目提供托管训练或部署在企业环境中。
- 支持基于开源模型的训练,模型选择不绑定单一厂商。
- 训练完成的模型可接入 NorthGate 统一提供服务,并与 NAC、小北中的智能体配合使用。
- 训练效果以双方约定的业务评测为准,项目启动时共同确定任务、数据与验收标准。