Weaver 深度解析 —— 大模型后训练基础设施的演进之路
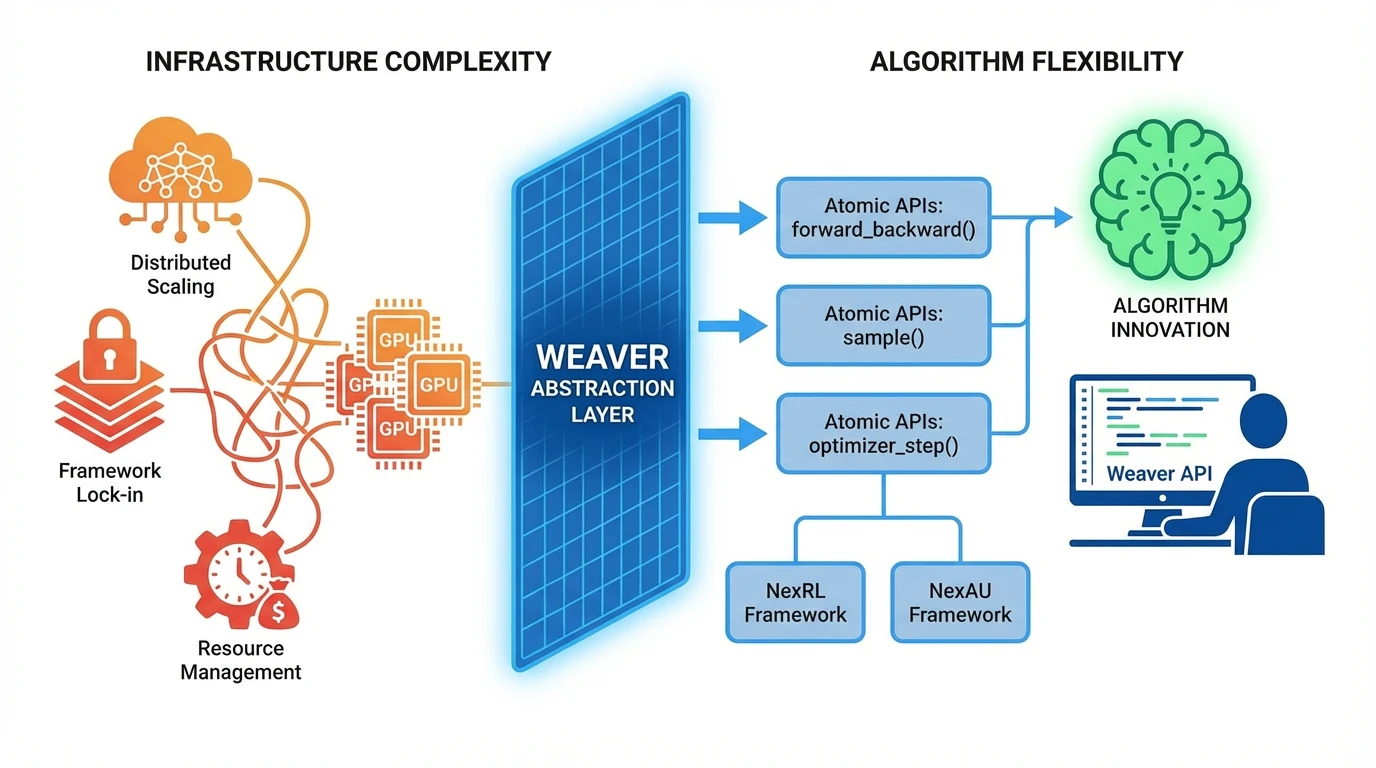
我们近期发布了全新的能动性模型微调服务 Weaver,它通过暴露模型训练过程中 GPU 相关的原子化操作(例如 forward_backward、sample)来屏蔽底层模型训练基础设施的细节,从而让算法开发者、应用开发者可以灵活快捷地进行模型微调。此外,我们还发布了一系列生态库(包括强化学习训练框架 NexRL 和智能体开发框架 NexAU),来帮助开发者更容易的使用此服务。
本文将首先介绍 Weaver 的设计理念与技术架构,阐述服务化训练系统面临的独特挑战。随后回顾 Weaver 如何从后训练领域的技术痛点出发,经历架构重构与设计迭代,最终演进到当前的系统形态。通过这些实践经验的梳理,期望能为相关领域的探索提供一定的参考价值。
Weaver 快速上手
为了更好地理解后续的讨论,我们先以一个最小化的 PyTorch 模型训练代码为例,体验 Weaver 的使用方式。
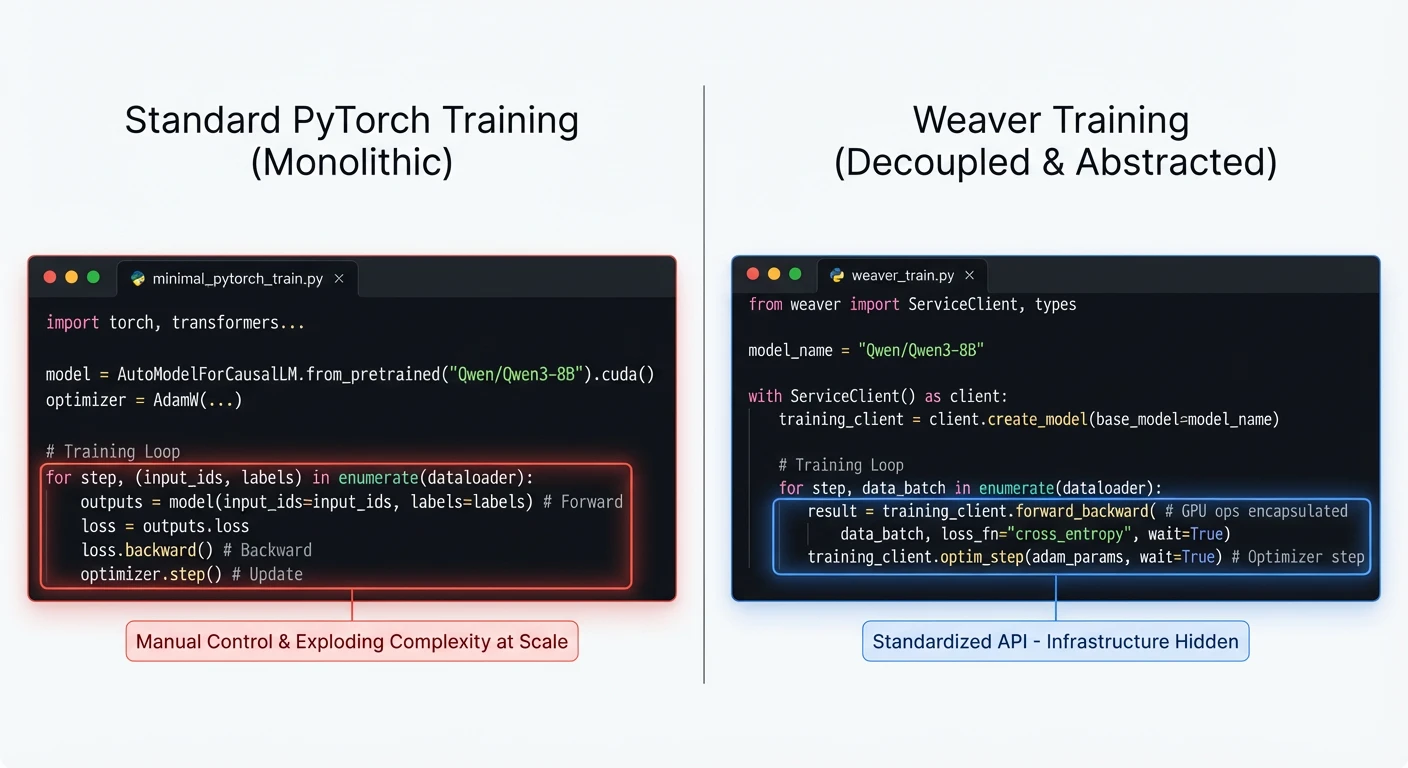
上图中左侧代码展示了一个标准的模型训练流程:加载模型、准备数据、执行前向传播计算损失、反向传播更新参数。这个流程简洁直观,对于单机单卡的场景运行良好。然而,当我们面对实际的大模型训练需求时,这种方式会遇到一些问题:
-
规模化的复杂性。当模型参数量从几十亿增长到数千亿甚至万亿级别时,单卡已无法容纳完整的模型。需要引入各种并行策略等分布式训练技术。这意味着要深入理解 Megatron-LM、FSDP 等框架的使用细节,配置复杂的并行策略参数,处理跨节点通信、梯度同步等底层问题。原本简洁的训练代码会膨胀的比较复杂。
-
框架绑定的困境。不同的训练框架有着不同的编程范式和 API 设计。如果你基于某个框架实现了训练代码,切换到另一个框架往往需要大量的重写工作。更糟糕的是,算法研究人员的核心关注点(比如数据、reward 等)与底层框架的实现细节紧密耦合在一起,难以独立演进和优化。
-
资源管理的负担。需要手动管理 GPU 资源的申请、分配和释放,处理资源不足、节点故障等各种异常情况。对于算法研究而言,这些基础设施层面的问题是不必要的认知负担。
仔细审视上述挑战,会发现这些复杂度大多与算法逻辑无关。无论是并行策略的配置、框架 API 的适配,还是资源的管理调度,本质上都是工程实现层面的问题,并不改变训练的核心逻辑。
换句话说,训练过程可以清晰地划分为两个层次:
- 算法层:数据处理、训练流程控制、损失函数、奖励函数设计等,这是研究人员应该关注的核心
- 执行层:GPU 上的模型计算(forward/backward)、分布式通信、资源调度等,这些是系统实现细节
基于这个层次划分,Weaver 的做法是将 GPU 相关的计算过程抽象为标准化的 API 接口。 算法研究人员不需要关心模型如何在多卡上分布,不需要配置并行策略,也不需要管理 GPU 资源,这些都由 Weaver 的后端服务处理。研究人员只需要通过 forward_backward、optimizer_step 等几个简单的 API 调用,就能完成原本需要数百行代码才能实现的分布式训练功能。
基于 Weaver,你可以快速重写上面的整个流程,如上图右侧代码所示。通过这个例子,我们可以看到 Weaver 如何解决前面提到的三个问题:
-
应对规模化的复杂性:无论模型是 8B 还是 671B,无论需要单卡还是多节点训练,算法流程的代码逻辑保持不变。只需要在
create_model时指定模型名称,Weaver 会自动选择合适的并行策略和资源配置。如果要替换更大的模型,只需要修改一个字符串。 -
摆脱框架绑定的困境:训练代码只依赖 Weaver 的 API,而不与任何底层框架绑定。Weaver 的后端可以使用 Megatron-LM、FSDP 或其他框架实现,但这对用户是透明的。框架的升级和优化不会影响你的代码。
-
消除资源管理的负担:你不需要编写任何资源相关配置文件,不需要申请和管理 GPU 资源,也不需要处理节点故障和重启。这些都由 Weaver 的服务端自动处理,你只需要关注算法本身。
通过将 GPU 计算抽象为服务化的 API,Weaver 让算法研究回归本质,这是使用 Weaver 最核心的好处。
使用限制
虽然 Weaver 为算法研究、Agent 开发提供了很大的灵活性,但我们发现实际用户使用时,还会有几个需要说明的限制:
-
模型架构探索:Weaver 针对现有部分大语言模型的微调和后训练工作流进行了优化(支持模型清单),如果您的工作涉及探索新颖的模型架构或修改基础模型结构,Weaver 当前的形态不太适合。根据我们的观察,80% 以上的工作不需要进行模型架构的探索,因此我们认为这种设计取舍是合理的。
-
输入 Token,输出 Token:Weaver 训练和推理 API 的输入输出都是 Token ID,而非原始文本,这样可以最大程度避免训练推理反复 Tokenize 带来的数据偏差问题,从而最大程度保证训练精度。但这意味着需要在客户端完成分词等预处理工作。为了简化这一流程,我们的生态库如 NexRL 已经内置了对这些操作的支持,提供了便捷的封装来处理文本与 token ID 之间的转换、数据预处理等工作。
深入 Weaver
接下来,我们以 LoRA 训练为例,介绍 Weaver 为支持这一功能而设计的系统架构与核心机制。
可扩展架构
Weaver的整体架构如下图所示:
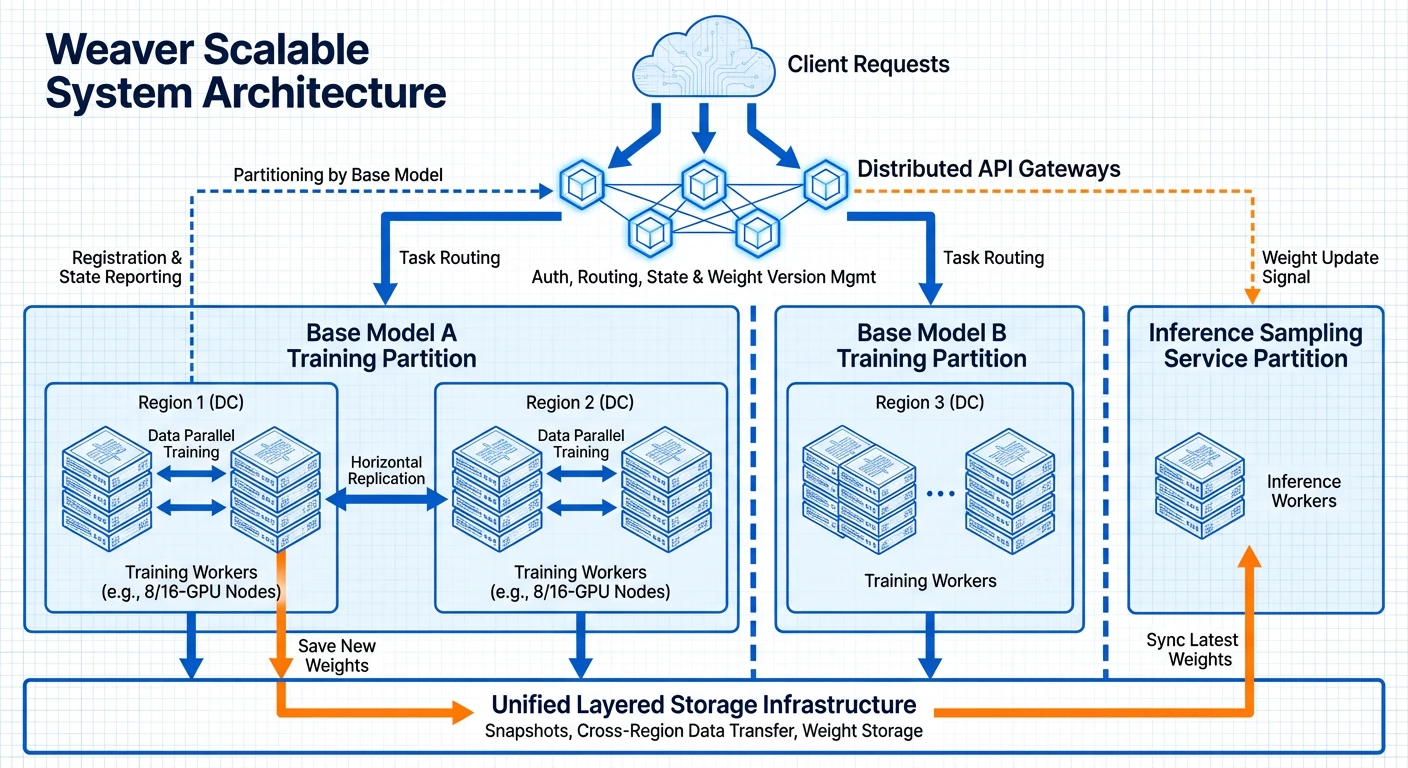
整个系统采用网关-工作节点的架构。API 网关负责请求接入、身份验证和任务路由分发。具体模型的训练和推理任务则有 Worker 节点负责。Worker 在启动时向网关注册,声明支持的模型类型和资源状态。网关根据请求的目标模型,将任务路由到对应的 Worker 池,由 Worker 池内部完成负载均衡。
整个服务的瓶颈在 Worker 上,扩展性也主要围绕 Worker 设计。这里采用两层扩展策略:
-
第一层:按基座模型分区。不同的基座模型(如 Nex-N1-671B、Qwen3-8B)有各自独立的服务资源池。这样做的原因很直接:相同基座模型的 LoRA 任务共享模型权重,可以复用加载的模型权重和计算资源。推理服务同样也可以基于 Multi-Lora Serving 的方案共享基座模型资源。
-
第二层:资源水平复制。对于每个基座模型,部署多组训练 Worker 来处理并发请求。一组 Worker 的规模可以根据实际需求灵活配置,每个模型启动多少组 Worker 可以根据任务队列的情况动态调整。这样既能支撑大模型训练,又保持部署灵活性。这种水平扩展使得系统能够适应从小规模到大规模的各种算力资源。
系统的状态管理依赖分层存储基础设施:训练过程中的状态快照、Checkpoint 的跨地域传输、权重在训练和推理节点间的同步与复制,都通过统一的存储抽象完成,保证数据一致性的同时支持灵活的部署拓扑。网关层负责管理 Checkpoint 的版本和分发,确保推理请求能够使用到正确版本的模型权重。
执行模型与时序控制
进一步分析 Weaver 后端推理和训练任务 Worker 的设计。
-
训练服务采用持续运行的训练循环作为核心执行模型。每轮循环包含固定阶段:从任务队列拉取训练请求、加载模型与优化器状态、执行前向/反向传播、更新优化器参数、保存状态。我们将这样一个完整的循环过程定义为一个 Cycle。
-
推理服务的执行模式有所不同。每个推理请求都与特定的模型 Checkpoint 绑定。客户端在发起推理请求时,会指定使用哪个 Checkpoint 进行推理。推理服务加载对应的权重,执行采样生成,返回结果。推理服务为了吞吐考虑没有固定 Cycle,而是采用在线服务通用的连续 batch 的处理方式。
两大组件不同的执行模式,带来了一个关键挑战:时序控制的复杂性。
对于推理服务,时序问题相对简单。推理请求只依赖于权重版本——只要使用了正确的 Checkpoint,推理结果就是确定的。不同推理请求之间可以并发执行,无需严格的顺序约束。唯一需要保证的是,推理使用的 Checkpoint 是由之前的训练步骤产生的,这通过 Checkpoint 版本号机制即可实现。
而对于训练服务,时序问题至关重要。训练本质上是严格的串行流程——每个训练步骤都依赖于前一步的梯度更新结果,必须保证执行顺序的正确性。但在服务化场景下,客户端发送的多个训练请求可能被动态组织成 Batch,或分散到不同的 Cycle 中执行,这就引发了复杂的时序依赖问题。
为了解决训练服务的时序问题,我们设计了一套基于客户端生成自增序列号的时序控制协议。客户端发送每个训练操作请求时,携带一个单调递增且连续的序列号,服务端严格按照序列号顺序执行。这种设计既保证了训练的正确性,又赋予了服务端足够的调度灵活性,在不违反时序约束的前提下,服务端可以自主决定如何组织 Batch、何时执行任务。
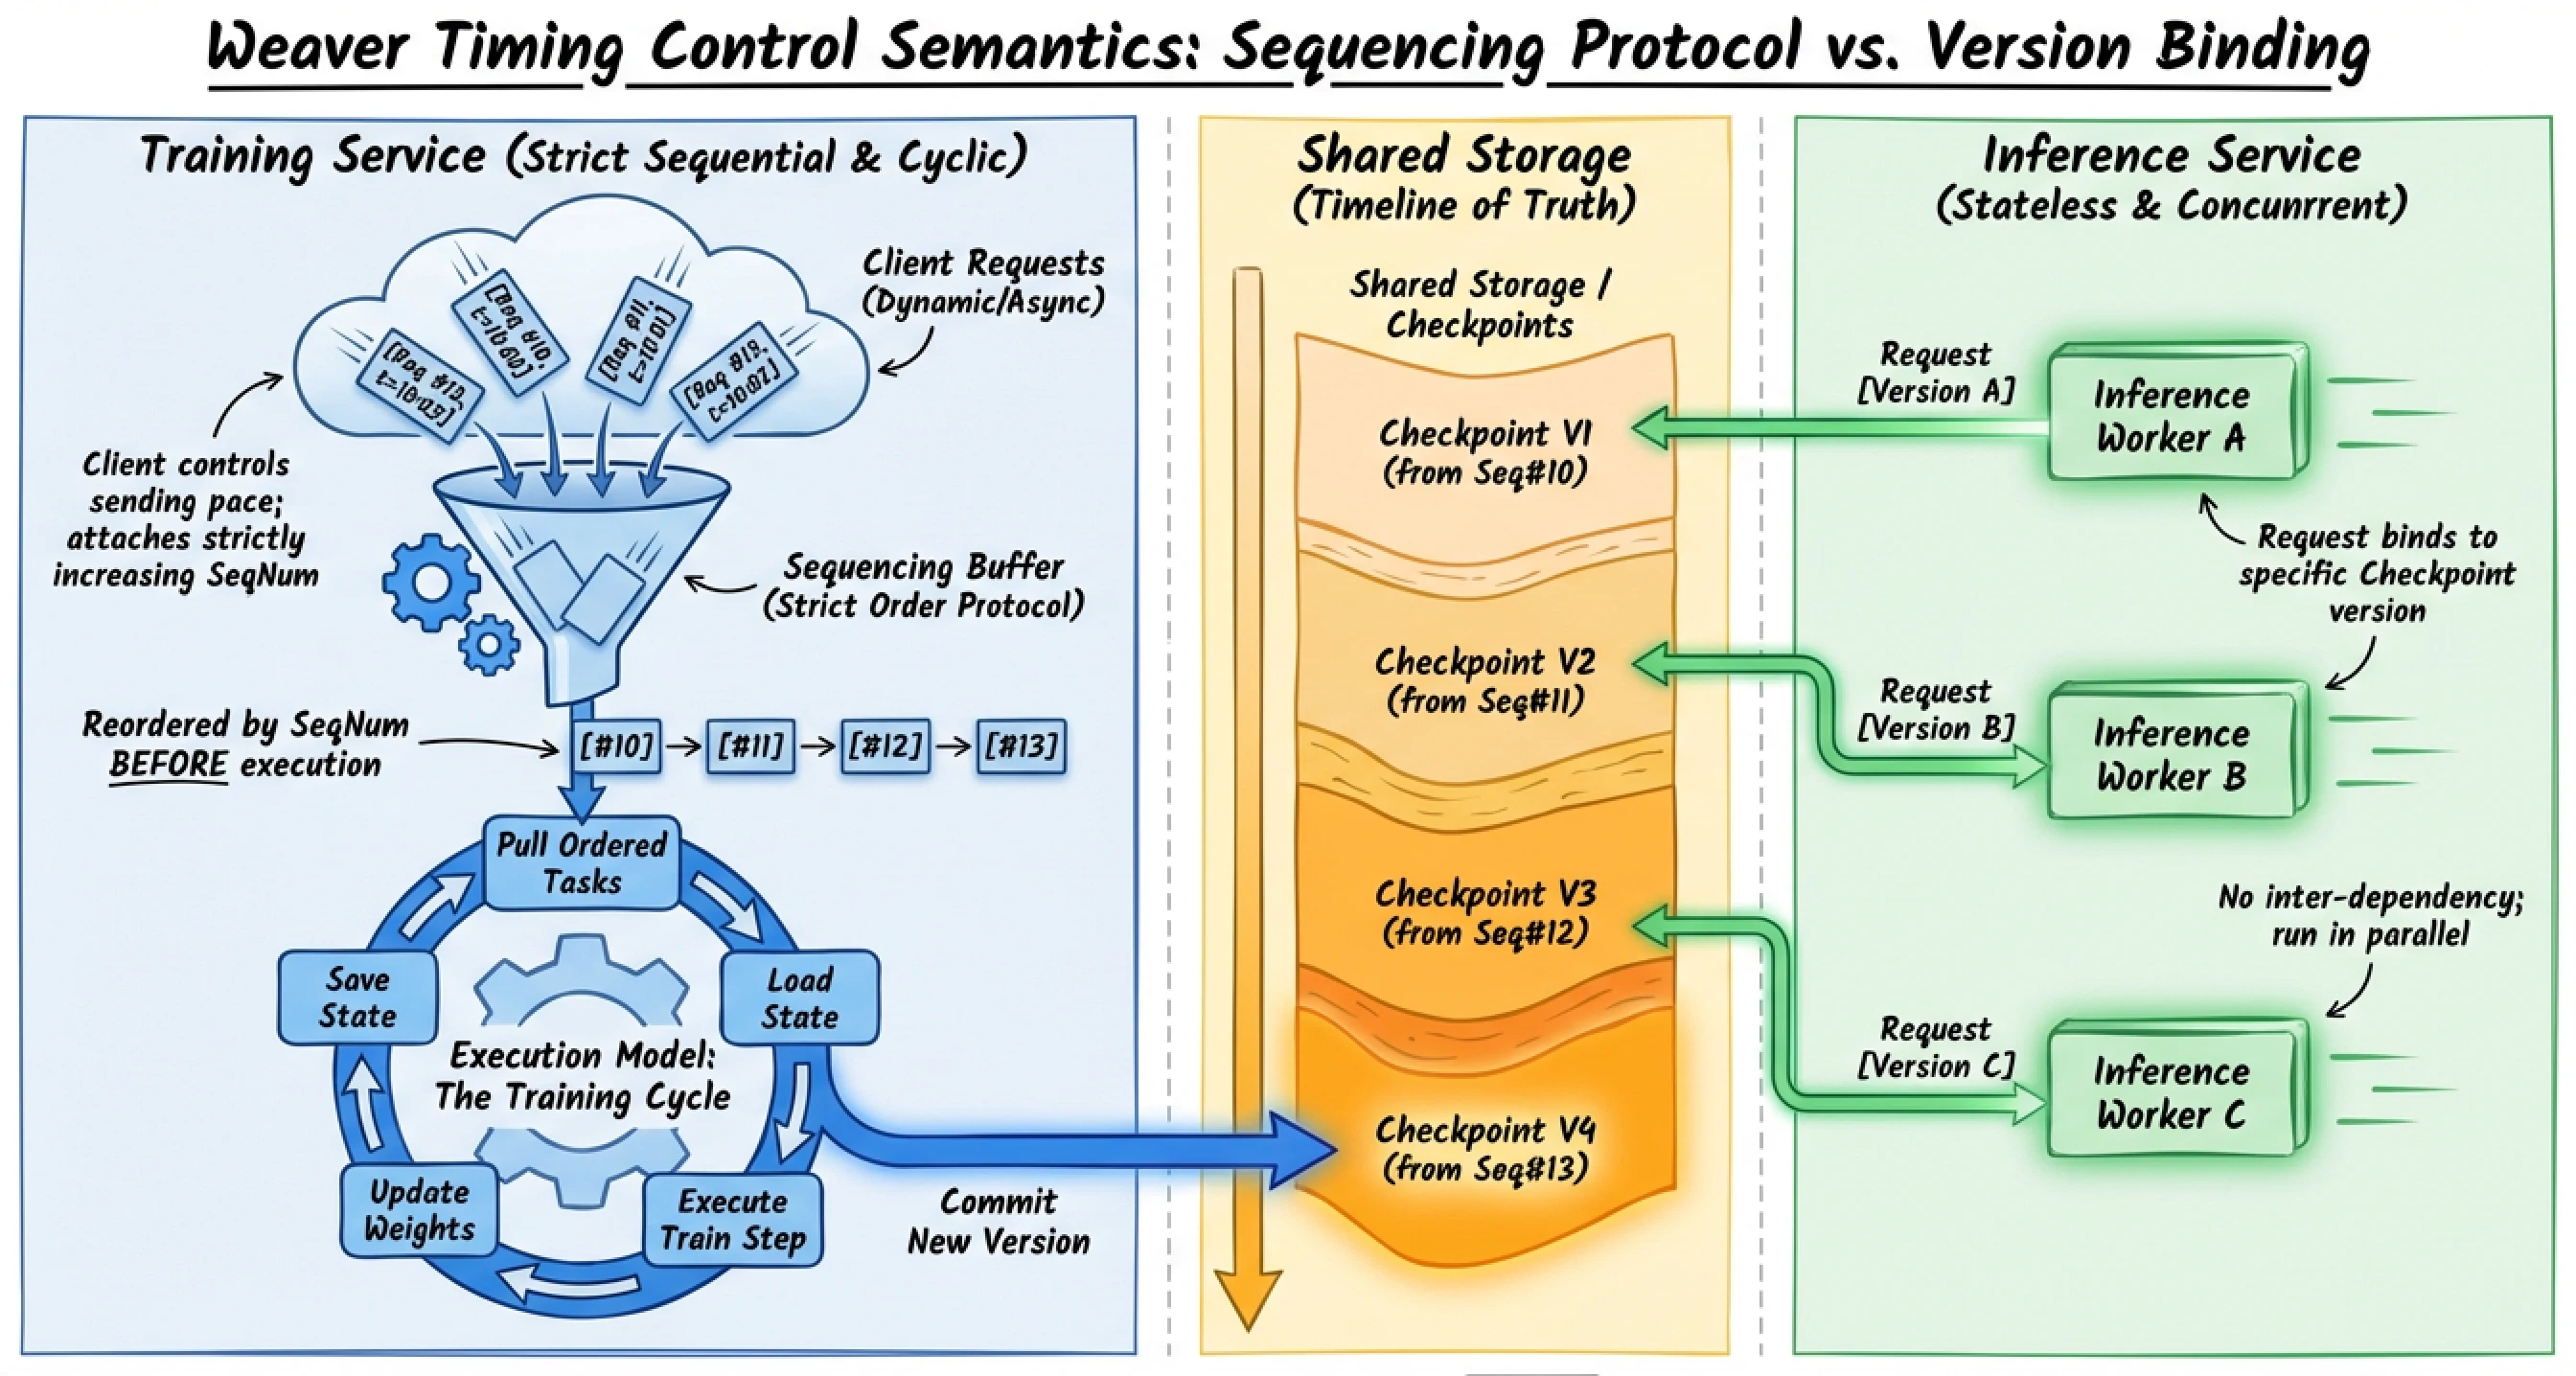
通过这种客户端控制的时序机制,算法用户能够灵活支持多种训练模式:从完全同步的传统训练,到允许一定延迟的异步更新,再到样本级细粒度的异步控制,这些模式都可以通过在客户端调整请求发送节奏和等待策略来实现,保证了极大的灵活性。
系统性优化的机会和挑战
建立了这套服务化训练架构后,如何最大化算力利用效率成为关键问题。
一方面,我们可以进行训练和推理系统的深度优化,比如之前分享过的 FP8 训练优化(Grouped FP8 Quant, Blockwise FP8 ZeRO)、投机式推理来加速采样生成(ReSpec)等。另一方面,服务化架构本身也带来了一些新的挑战和优化机会。这里我们选取几个代表性的问题进行讨论。
微观任务调度策略
微观任务调度策略分为宏观资源调度与微观任务分配两层:宏观层需权衡新训练请求时启动新资源(降延迟但增成本)与现有资源排队(可能降用户体验)的成本效益;微观层需综合性能(优先加载相关模型状态的Worker避免冷启动)、负载均衡(分散任务防节点过载)、局部性(就近选择状态数据存储节点减传输时间)多维度分配任务。初期的调度策略可采用一些简单有效的启发式规则:比如基于任务负载感知调度、基于缓存亲和性调度、基于地域的就近调度等。随着系统的运行,可以收集更多的性能数据,逐步引入更智能的调度算法,比如基于历史表现的预测性调度、考虑多目标优化的调度策略等。调度系统的可演进性是设计的一个重要考量。也可以从一些相关的 Serverless 的系统研究中寻找一些参考的经验。
多 LoRA 训练及高效切换
LoRA 训练面临一个有趣的性能挑战:由于只训练少量的低秩适配器参数,相比全参数微调,其计算强度(Arithmetic Intensity)显著降低。服务化架构为解决这个问题提供了独特的机会。当系统同时服务多个用户的 LoRA 训练请求时,可以将这些训练任务在同一个 Cycle 内合并执行。具体来说,多个 LoRA 的数据可以组织成一个更大的 Batch,在前向和反向传播时一次性处理。由于不同 LoRA 共享相同的基座模型,只是适配器参数不同,这种合并不会带来额外的模型加载开销。实现该优化需算子层面专门设计,保障Batch内不同样本使用不同LoRA参数的计算正确性与高效性。业界已经有一些优秀的解决方案(如 mLora)。而在服务化场景下,由于负载的动态性和不确定性,我们发现有一些新的优化空间。
全参数微调的挑战
当前 Weaver 对外的服务只提供了 LoRA 训练方法,但我们内部的 Nex 模型训练都是全参数微调(Full Fine-Tuning),这类功能预计在未来几个月会逐步放开。然而,从 LoRA 迁移到全参数微调会带来一系列新的技术挑战,这些挑战在量级上是本质差距的。切换开销上,LoRA任务切换仅需毫秒级切换少量适配器参数,而全参数微调需数秒至数十秒加载保存完整模型权重副本,严重影响多租户场景资源利用率与响应延迟;数据量上,72B参数模型的LoRA适配器仅数百MB,全参数微调的优化器状态加模型权重可达数百GB,对存储容量、带宽及状态管理提出更高要求。需通过更智能的调度减少切换、高效状态压缩传输、引入权重增量更新等多层面优化。在大模型时代之前有不少相关研究,比如 Gandiva 提出了一些基于可预测小批量阶段的 GPU 时间片划分与训练任务迁移技术,为降低切换开销提供了思路。在大模型全量训练场景下,也有一些类似的模式可以加以利用。
后训练基础设施的演进之路
作为一家聚焦后训练的公司,我们在实践中面临着独特的挑战:强化学习后训练需要频繁的训练-推理-再训练循环,这种模式对基础设施的要求与传统预训练截然不同。如何在保证算法灵活性的同时提升资源利用率,一直是我们探索的核心问题。
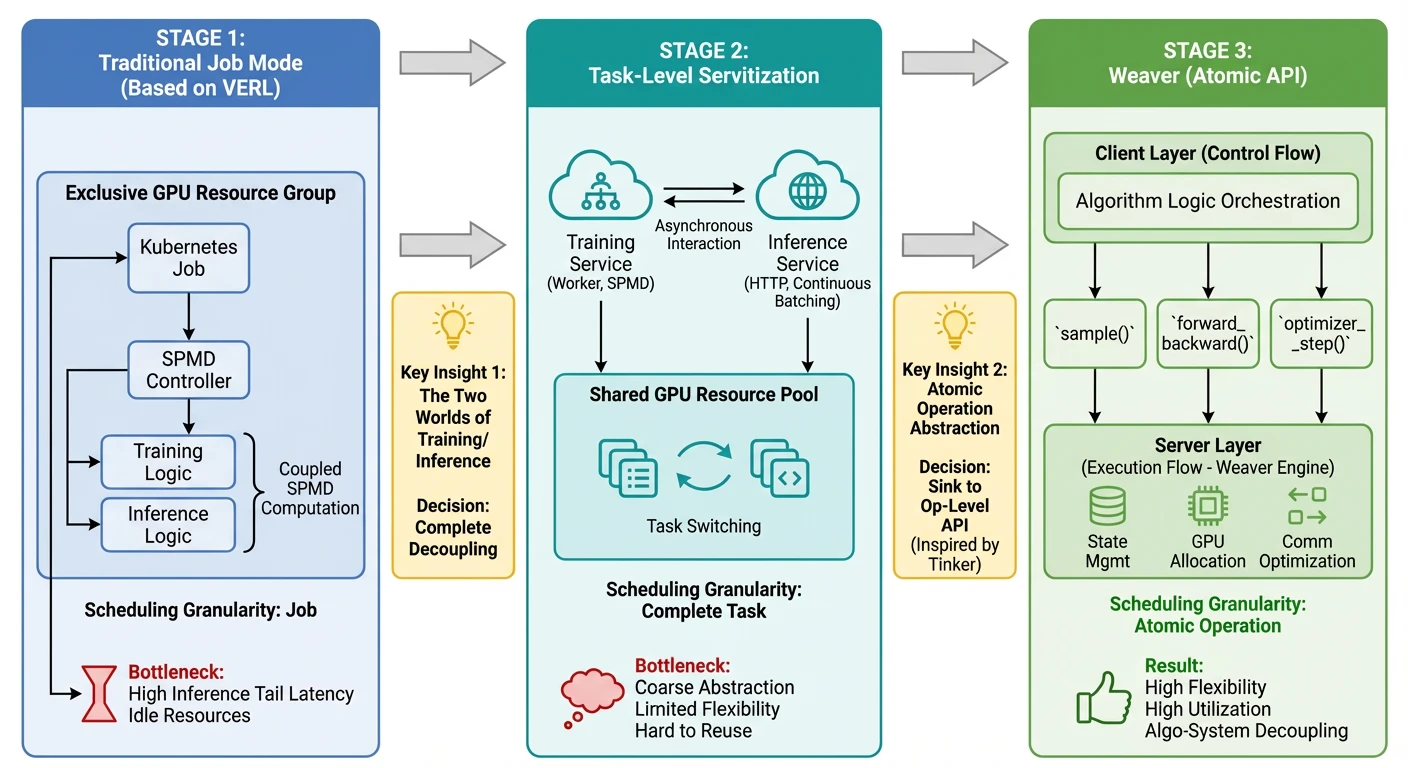
Weaver 作为我们目前的后训练系统,它的形态并非一蹴而就,而是我们内部经过三个大版本迭代逐步演进而来,接下来我们将回顾这段演进历程。
第一阶段:基于任务提交的传统模式
我们的后训练基础设施最初是基于 VERL 框架构建的,采用传统的作业提交模式。VERL 是一个设计优雅的强化学习训练框架,它精妙的混合了 Single-Controller 和 Multi-Controller 范式,在保持性能的同时极大的增强了易用性。基于这个训练框架,算法研究人员通过提交 Kubernetes 作业来启动训练任务,每个作业独占一组 GPU 资源,训练完成后释放。
随着我们进行更多面向Agent 的训练,核心问题显现: SPMD(Single Program Multiple Data)这一计算范式存在局限性。该范式要求所有计算节点执行相同逻辑,适配训练阶段的同步计算与并行加速,但不适用于Agent环境推理。不同的 Agent 会产生不同长度的输出甚至不同轮次数的交互。在 SPMD 的约束下,所有节点必须等待最慢的那个样本完成,这导致了大量的计算资源闲置和等待。更糟糕的是,随着批次大小增加,这种尾延迟(tail latency)问题会被放大,严重限制了系统的吞吐量和效率。
虽然可以通过 VERL 中的一些数据抽象(DataProto)来打通推理和训练的差异,但从系统设计的角度上来说,这引入了一些额外的复杂度(需要实现一些类似 strip_left_and_right_padding 之类的方法)。这个认知成为了我们后续架构演进的起点。
*** 注:VERL 社区后续也进行了很多架构上的改造,我们当时使用的是 2025 年 2-3 月份的版本。 ***
强化学习后训练中的两个世界
稍微分析下强化学习后训练的计算特征,会发现整个流程可以清晰地划分为两个截然不同的"世界",它们有着完全不同的数据分布特点和计算强度:
第一个世界是训练侧,包括策略梯度计算、价值函数更新等过程。这部分计算非常适合 SPMD 范式:
- 所有样本的序列长度是确定的,可预知的
- 计算模式高度规则,适合数据并行和模型并行
- 计算密集型任务,GPU 利用率通常很高
- 前向传播甚至推理的 Prefill 过程也属于这一类,因为它同样是对确定长度输入进行规则化的运算
第二个世界是推理采样侧,这里的情况完全不同:
- Decode 阶段是典型的访存密集型(Memory-Bound)任务,GPU 的计算单元大量空闲,瓶颈在于内存带宽。更关键的是,不同样本的输出长度是动态的、不可预测的,有些可能生成几个 Token 就结束,有些可能长达几万 Token
- 尤其是考虑 Agent 跟环境交互,或者多轮 Agent 交互场景,这个不确定性会更加放大
- 这种动态性使得 SPMD 的同步模式极其低效,而 Continuous Batching 这种动态批处理技术才是最优选择
这两个世界的差异不仅体现在计算特性上,也体现在对延迟的敏感度上。训练阶段追求的是整体吞吐量,可以容忍一定的调度延迟;而推理采样阶段,特别是在交互式 Agent 场景下,低延迟和高并发能力至关重要。
基于这个深刻的认知,我们认为 从系统设计的视角看,训练和推理应该彻底解耦,使用不同的技术栈来优化各自的性能。
在这个思路的指导下,我们开始了架构重构。第一个版本的实现相对保守,我们在 VERL 的基础上,将训练器(Trainer)和采样器(Rollout)两个模块分离。训练器继续使用 SPMD 模式,专注于高效的训练;而采样器模块完全服务化。训练程序不再直接调用推理逻辑,而是通过 HTTP 接口向推理服务发起请求。这样的解耦带来了多个好处:推理服务可以使用推理引擎最擅长的能力(如 Continuous Batching),可以独立扩缩容,也可以在多个训练任务之间共享。
基于这套解耦的架构,我们能够实现各种复杂的异步训练策略。传统的同步强化学习要求每一轮采样完成后才能进行训练更新,这导致了严重的资源空闲——采样时训练卡闲置,训练时推理卡闲置。通过异步化设计,我们可以让采样和训练 overlap 执行,显著提升资源利用率。我们在之前的博客 BAPO 中详细分析了这种异步训练的算法特性和工程实现,在保证收敛性的同时实现了很好的训练加速效果。
第二阶段:任务级服务化的探索
将采样器服务化看似是个自然而直接的优化,但当我们实际运行大规模实验时,发现了一个更深层的资源利用问题。即使采用了 1-Step Async 的异步训练策略,训练在前一批数据上更新参数的同时,推理已经开始用新模型采样下一批数据——系统的整体效率仍然不够理想。
问题的根源在于训练和推理的伸缩特性存在本质差异。当我们增加 GPU 卡数时,训练的墙上时间(Wall-Clock Time)可以近乎线性地缩短,数据并行和模型并行都能带来良好的加速比。但采样过程由于自回归推理的特点,很难随 GPU 数量线性加速。
这种不对称性导致了一个尴尬的局面:在大规模训练场景下(比如 1024 卡训练),推理采样往往成为整个系统的瓶颈(Bottleneck),而训练资源则出现大量的空闲期(Bubble)。我们实测发现,在某些配置下,GPU 卡的利用率(GPU Utils)都只有 10%-20%,这在成本高昂的大规模训练中是完全不可接受的。
为了解决这个核心矛盾,我们提出了一个大胆的想法:能否让训练 GPU 资源在空闲期间执行其他训练任务。 在我们的场景下,当一个训练任务在等待新的采样数据时,训练 GPU 可以切换去处理其他满足条件的训练任务。
这个想法的可行性源于一个关键洞察:模型训练本质上是一个无状态的纯函数。函数的输入是当前模型权重、优化器状态(如 Adam 的动量和方差)、训练批次数据、损失函数和一些随机数状态;函数自身进行前向传播、反向传播和参数更新,函数的输出是新的模型权重和优化器状态。这个过程不依赖任何外部状态,具有完美的确定性和可重复性。
Forward_Backward_Optim(weights_t, optimizer_state_t, batch, loss_fn)
    → (weights_{t+1}, optimizer_state_{t+1})
这种函数式特性意味着,只要我们能够保存和恢复训练状态(权重 + 优化器状态),就可以在任意时刻暂停一个训练任务,切换到另一个任务,之后再无缝恢复。任务之间的切换不会影响训练的正确性,实现的关键在于状态管理的效率。
为了验证训练资源共享的可行性,我们进行了定量化的通信与计算分析。对于 671B 参数的模型,即使采用 FP8 量化训练,任务切换需要传输的状态数据(模型权重 + Adam 优化器状态)约为数 TB。在现代数据中心 RDMA 网络(带宽达每秒数百 GB)支持下,结合分层缓存策略(利用 GPU HBM/CPU 内存存放热数据、本地 NVMe SSD 存放温数据、分布式存储归档),可以将任务切换时间控制在秒级。
基于这一可行性分析,我们重新设计了系统抽象,将训练进程从作业绑定模式转变为服务化模式。算法研究人员不再提交独占资源的 Kubernetes 作业,而是提交业务层面的训练任务。这些任务被动态调度到共享的训练资源池中执行,训练进程作为长期运行的 Worker 在不同任务之间切换。
在这个演进过程中,我们逐渐认识到控制流与执行层解耦的重要性。这个理念催生了我们的另一个项目 NexRL,它是一个松耦合的后训练框架,我们计划在后续的博客中讨论这个项目。
第三阶段:原子化操作的 API 抽象
虽然任务级服务化显著提升了资源利用率,但仍存在一个问题,抽象粒度不够。用户虽然不需要管理资源,但提交的仍然是完整的训练任务,任务中对 GPU 的使用的细粒度的逻辑从系统层面很难感知到,系统只能整体调度,无法灵活调配。
直到我们看到了 Thinking Machine Labs 发布的 Tinker,它的 API 设计提供了关键启发。Tinker 将抽象粒度从"训练任务"下沉到"GPU 操作",用户不是提交完整训练任务,而是调用 forward_backward、optimizer_step、sample 等原子化 API 来组合训练流程。
这种原子化操作的设计实现了完美的平衡,具体体现在:
- 灵活性与易用性兼顾:粒度足够细以支持各种训练模式,每个 API 对应完整的 GPU 计算过程,用户无需关心内部实现
- 权责边界清晰:客户端负责控制流(何时采样、训练、如何组织数据),服务端负责执行流(GPU 分配、通信优化、状态管理)
- 通用性强:支持从监督学习(SFT)到强化学习、从 LoRA 到全参数微调的各种场景
这一理念与我们的实践认知高度契合。基于 Tinker 的设计思想,我们将整个训练基础设施重构为 Weaver,通过将调度粒度从任务级别细化到操作级别,实现了算法逻辑与系统实现的彻底解耦。
总结
有了这样一个清晰的抽象,对后训练系统来说带来了多方面的价值:
-
对算法研究者而言,他们可以用熟悉的 Python 代码表达任何复杂的训练逻辑——从简单的监督微调到复杂的多智能体强化学习——而无需关心底层的分布式实现。这大大加速了算法创新的迭代速度。
-
对系统优化者而言,他们可以专注于提升 GPU 利用率、优化通信效率、改进调度策略,而不用担心破坏上层的算法逻辑。API 的稳定性保证了系统可以持续演进而不影响用户。
-
对资源管理者而言,服务化的架构使得资源可以在多个用户、多个任务之间灵活共享,显著提升了 GPU 集群的整体利用率和经济性。
但我们也深知,Weaver 还远未完美,仍然有许多值得深入研究的问题和场景。我们将持续探索面向新时代的大规模后训练基础设施,追求极致的性能、灵活性以及易用性。如果你对这些问题同样充满热情,欢迎加入我们。
@misc{2026-deep-dive-weaver,
  title   = {Deep Dive Weaver},
  author  = {Peng Sun in collaboration with others at Dawning Road},
  year    = {2026},
  url     = {/blog/deep-dive-weaver/},
  note    = {Blog post},
  urldate = {2026-10-24},
}