BAPO:增强 Off-Policy 强化学习中的稳定与效率
引言
在语言模型与智能体的后训练阶段,强化学习已经成为主流的优化算法。传统的 On-Policy RL 因为行为策略(Behavior Policy)与目标策略(Target Policy)一致而以稳定著称,但由于其同步、阻塞式的设计,常常在数据与训练效率上受限。于是,研究者们转向允许行为策略与训练策略不同的 Off-Policy RL。它更高效,也能容忍数据的“陈旧度”,非常适合超长序列与高难度场景,同时也更贴合现代 AI 基础设施(比如 Partial Rollout 场景)。不过,在实践中,Off-Policy训练会遇到两大难题:优化不稳定,以及熵崩塌。
为理解这种不稳定性,我们进行了系统的理论与实证分析,得到两个关键洞察:优化失衡,以及在广泛使用的基于Clip的优化函数的“Entropy-Clip Rule”。基于这些观察,我们提出了一种稳定且有效的 Off-Policy 强化学习方法——BAlanced Policy Optimization with Adaptive Clipping(BAPO,平衡策略优化)。在多种Off-Policy的设置下,BAPO 都展现出更稳定的训练动态与更好的下游表现。
核心挑战:Off-Policy RL 引发的训练不稳定
我们从在 deepseek-distill-qwen2.5-7B 上的实验开始,采用 PPO/GRPO 常用的 Clip-based Surrogate 优化目标进行训练:
我们考察“陈旧度”(即行为策略与训练策略之间的偏离程度)如何影响训练动态:
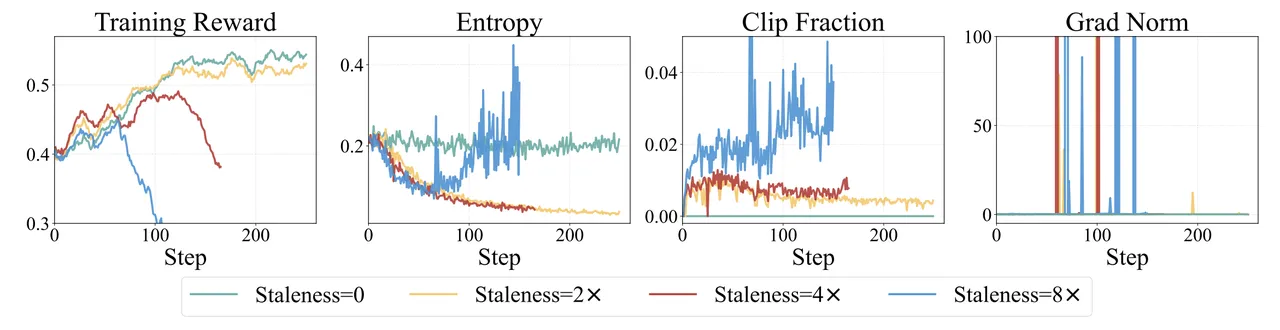
如图所示,陈旧度越大,训练越不稳定,“熵塌缩”(探索能力下降)越明显。相比之下,在线训练则相对稳定。
非对称裁剪(Asymmetric Clipping)
为了寻找可能的缓解手段,我们还做了先前工作提出的“非对称裁剪”的消融实验,结果如下。
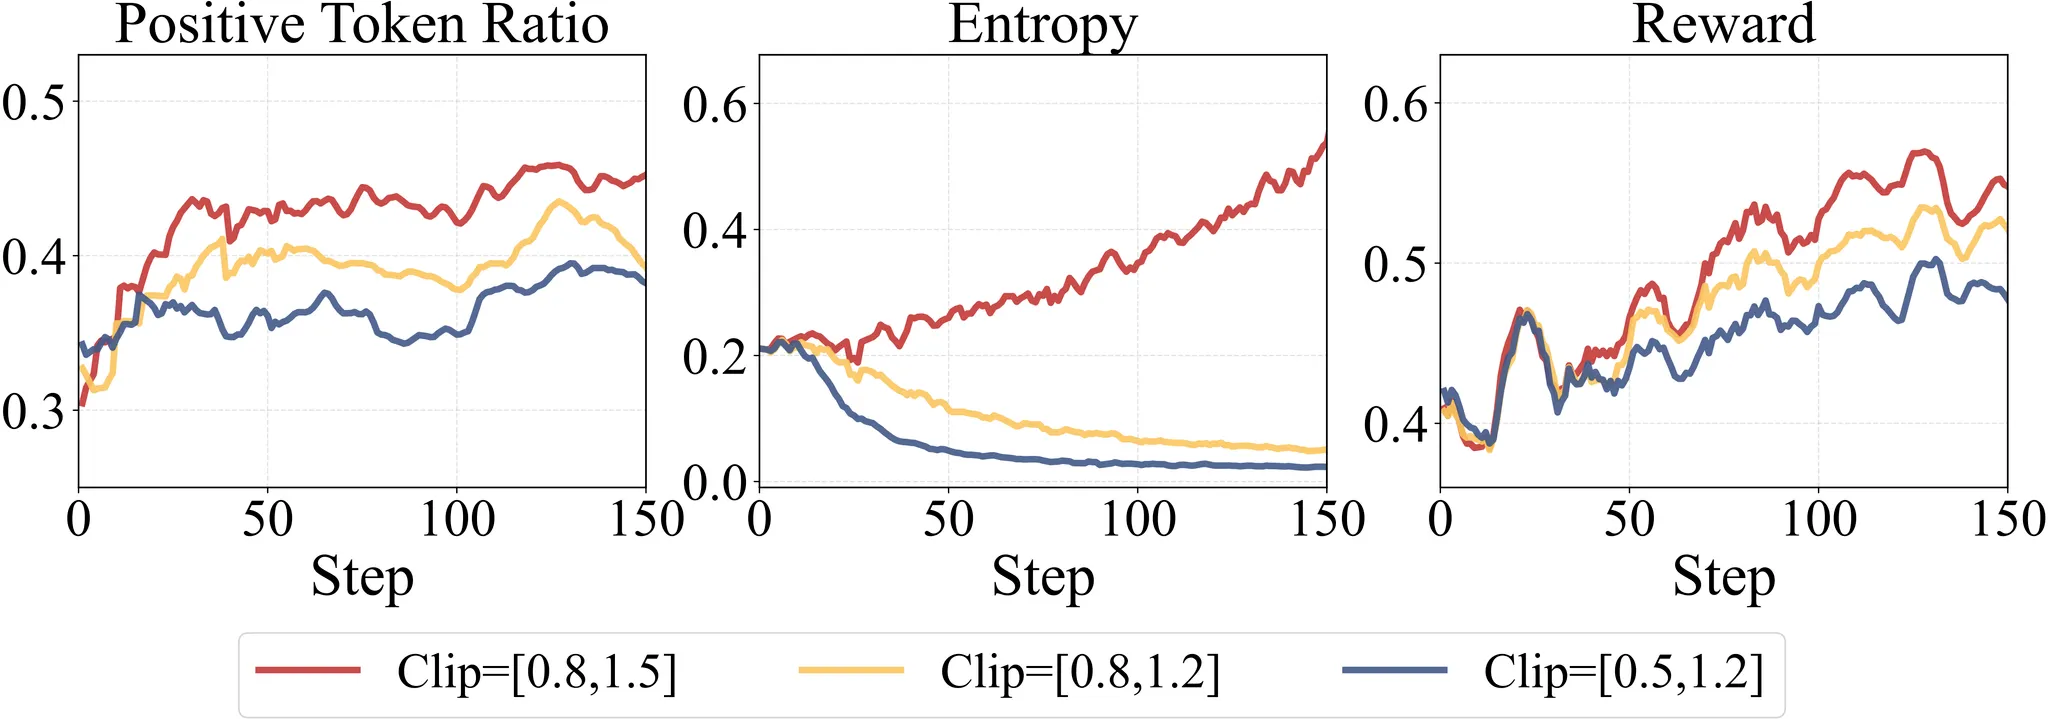
可以看到:降低下界会增加“负样本 token”的比例,使策略熵下降更快;提高上界会让更多“正样本 token”参与优化,从而阻止熵继续降低。这些选择也会不同程度地影响训练时的奖励。综合起来看,调节裁剪阈值确实会显著影响训练动态,并带来一定正面作用。但非对称剪裁策略依然依赖参数的设置,缺乏足够的灵活与自适应。
深入 Off-Policy RL 的优化过程
既然陈旧度会破坏稳定,非对称裁剪又能一定程度缓解,那么两者之间的关系,或者其内在机制是什么?
我们分析了在陈旧数据下 PPO/GRPO 使用的目标。更新可以拆解为两个相互独立的部分:针对“正样本 token”(需要奖励的行为)与“负样本 token”(需要惩罚的行为)。在这一拆解下,策略梯度可重写为:
这种“解耦”视角有助于理解 Off-Policy 训练如何塑造优化过程。
要点一:优化失衡(Imbalanced Optimization)
为了量化影响,我们分别统计正、负优势 token。下图(图 4)呈现了它们在损失中的贡献以及数量占比。
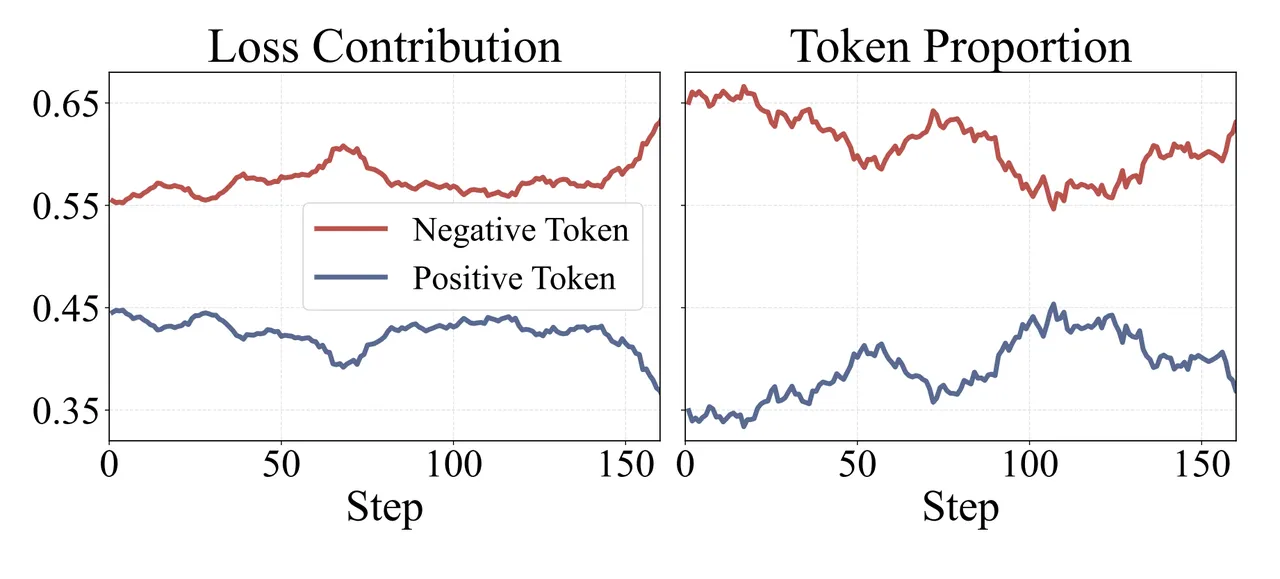
一个显著的不平衡出现了:无论是数量占比还是损失贡献,负样本都持续大幅超过正样本。为什么会这样?我们认为可能有两个原因。第一,困难的查询往往生成更长的轨迹,使负样本里包含更多 token;第二,训练早期模型能力不足,负样本占比更高。
之前不少工作指出,在大模型的强化学习中,强化正样本往往比压制大量负样本更高效。 因此先前工作会通过“提高上界”的非对称裁剪来放大正信号(见图 3)。但仅仅放宽上界并不能抑制负样本的影响,导致它们仍然主导优化过程。而且如式(2)所示,大量“低概率的负 token”(即 ,令对数项趋近 )可能触发梯度爆炸,进一步破坏稳定性。
要点二:熵—裁剪规则(The Entropy-Clip Rule)
接下来,正负样本是如何影响模型的熵? PPO论文里面的基于裁剪的代理目标的最初的思想是:为了稳定训练,重要性采样 (Importance Sampling) 比值过高或过低的 token 要被“裁剪”,不参与梯度计算。但是在大模型的强化学习中,这会带来额外的问题。
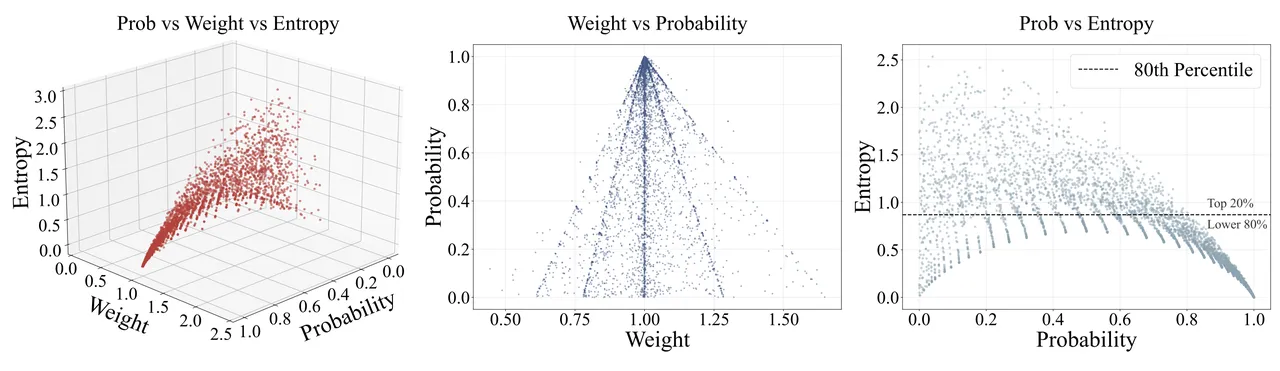
我们跟踪不同概率与重要性采样比率的 token,观察哪些最常被裁剪。图 5 显示了一个一致的现象:被裁剪的大多是“低概率”的 token。
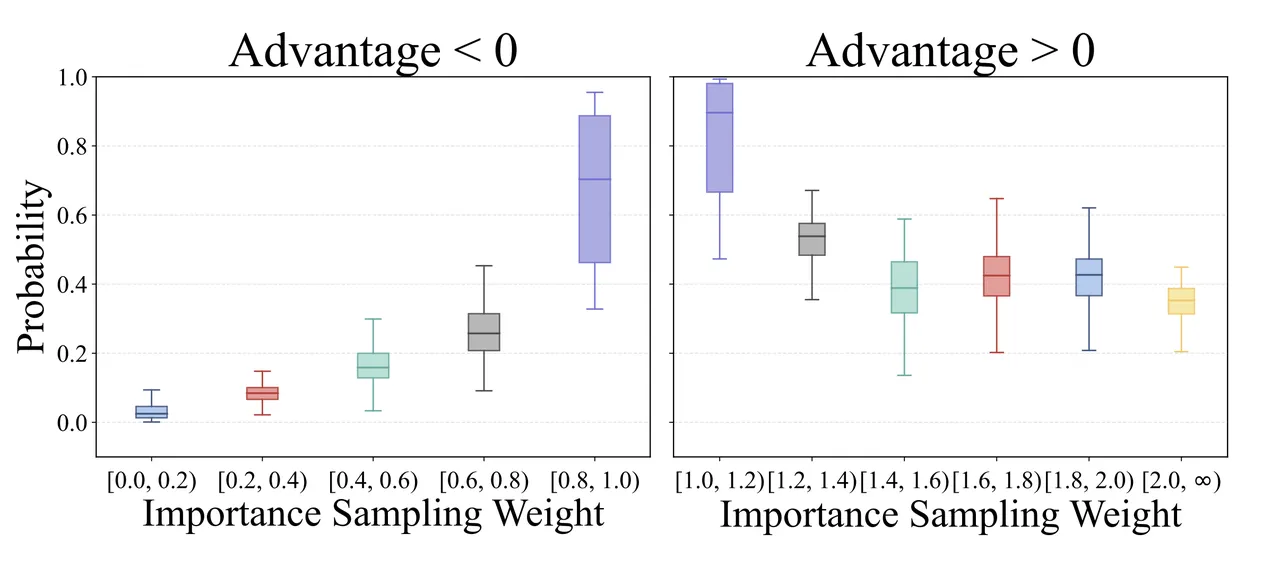
这恰是理解“熵”的关键。 我们受到之前许多工作的启发(例如清华的 The Entropy Mechanism),在论文中推导了 Clip-based Surrogate Loss 的熵更新的理论,熵的变化()主要由下式驱动(详细推导见论文):
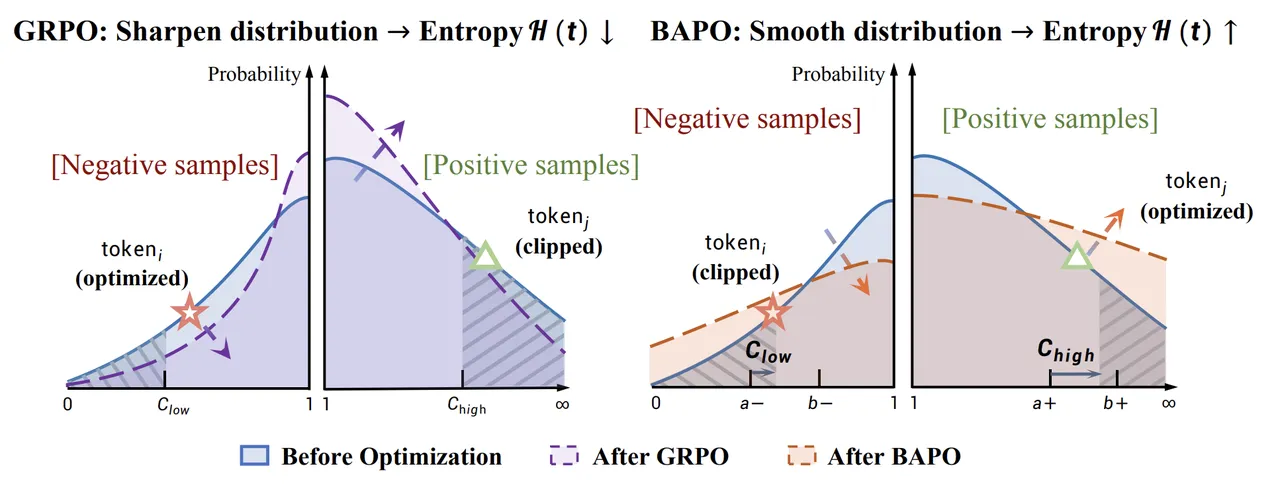
一句话概括:对于 Clip-based Surrogate Loss 而言模型的熵变化由“未被裁剪的 token”所主导,它取决于这些 token 的对数概率与优势的协方差。我们把这称为 The Entropy-Clip Rule。 图 1 左侧示意了不同 token 的优化如何改变概率分布,从而影响熵。具体来说,用“高概率正样本”和“低概率负样本”更新,会让分布更尖锐、熵下降;而用“高概率负样本”和“低概率正样本”更新,会让分布更平滑、熵上升(证明见论文附录 B.4.2)。基于这些发现,我们可以有的放矢地在训练中调控熵。
BAPO:动态平衡的自适应裁剪
有了上面的机制,我们就能更直接地把问题与解决方法关联起来:
- 平衡正负样本对优化的贡献,同时避免梯度爆炸。
- 依据“熵—裁剪规则”稳定策略熵,防止探索塌缩。
据此,我们提出 BAPO:一种面向 LLM 的稳定、快速的强化学习优化方法(算法细节见论文)。
与固定裁剪区间不同,BAPO 会对每个 batch 动态确定裁剪上下界( 与 ),其目标很简单:让正样本的贡献在 batch 级别上不低于阈值比例 。
这种动态调节带来两种相互促进的效果:
- 下界 自动抬高。 更紧的下界能裁掉极端“过度惩罚”信号,矫正优化失衡,恢复稳定。
- 上界 自动抬高。 更宽的上界会纳入更多正样本,尤其是此前被丢弃但“低概率、高优势”的宝贵 token,从而稳定策略熵。
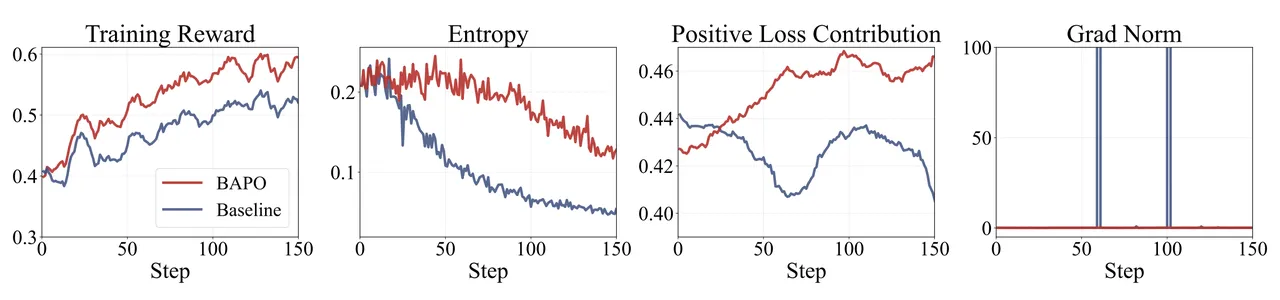
总之,这一过程无需复杂的外部正则,就能同时解决优化失衡与熵塌缩。
BAPO 的实证表现与其在多种设置下的通用性
在多项评测中,BAPO 都展现出优异的下游表现。
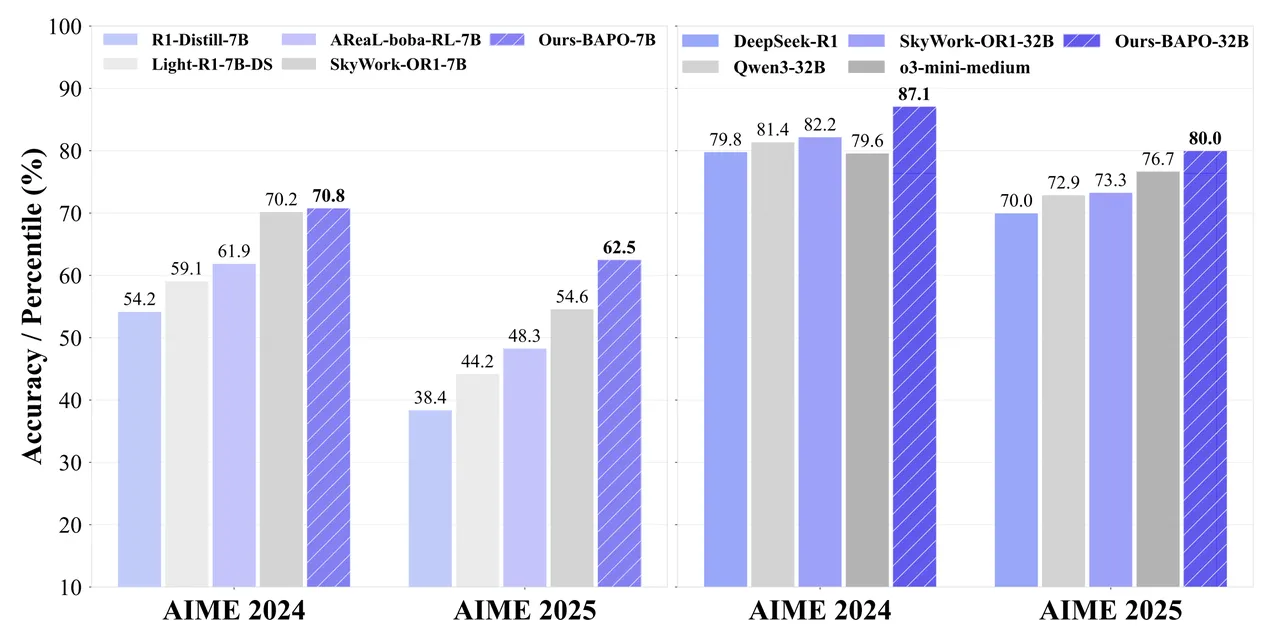
在 AIME 基准上,BAPO 训练的 7B 模型超过了同类开源模型。更进一步,32B 模型在某些指标上甚至超过了顶级闭源模型 o3-mini。
不仅限于单一模型族,一系列更具挑战的场景也体现了通用性:
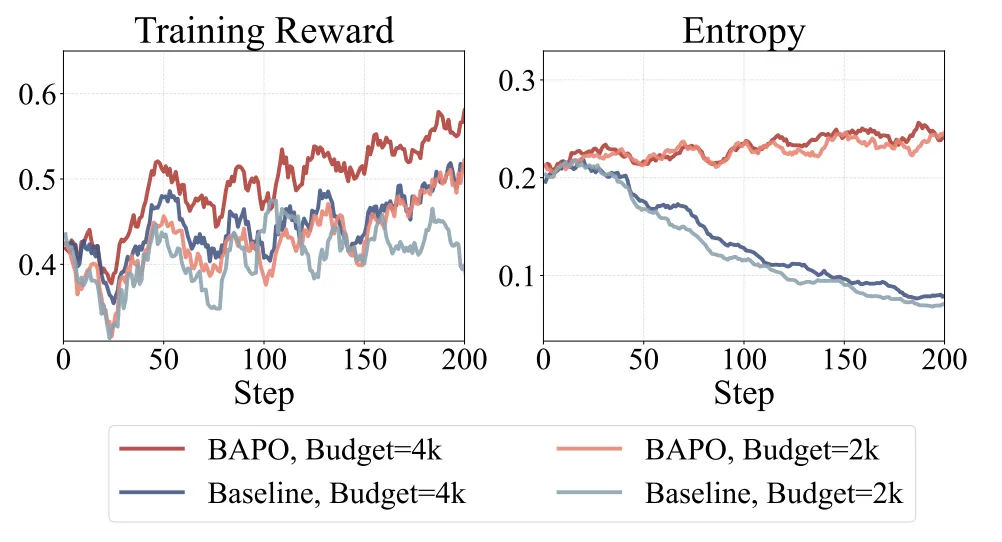
- Partial Rollout 场景。 为加速 LLM 的 rollout,现代系统会把长轨迹切成片段。当 rollout 超过固定 token 预算时,未完成的部分会放入回放缓冲区,之后继续而非重生成。这种做法虽然更高效,但会引入 Off-Policy,因为这些片段可能来自多个过去的策略模型。在这个设置下,BAPO 比标准 GRPO 更稳定、鲁棒。
- 不同基座模型。 为验证通用性,在 Llama 基座上(我们采用经过 Mid-Train 的 OctoThinker 模型)也能看到一致增益:用 BAPO 训练的 Llama 显著优于 GRPO。
| Method | AIME 2024 | AIME 2025 | MATH |
|---|---|---|---|
| GRPO | 2.5% | 2.9% | 58.4% |
| BAPO | 5.4% | 5.8% | 66.0% |
- 对数据陈旧度的鲁棒性。 基于 R1-Distill 模型与 SkyWork-OR1-RL 数据集,在不同陈旧度下,BAPO 都稳定优于基线与“提高上界”的策略,展现出更强的鲁棒性。
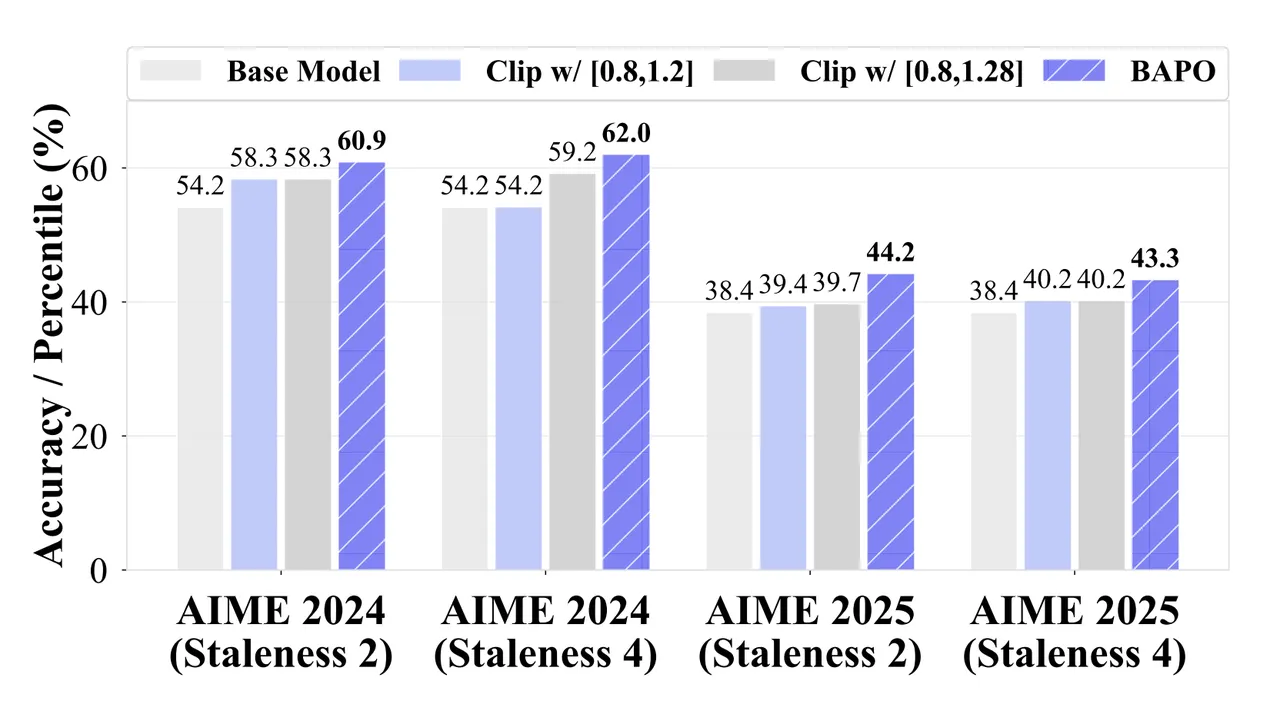
综合来看,BAPO 在不同模型与训练条件下都具备稳健性、稳定性与高性能。
结论与讨论
本研究揭示了策略熵、token 生成概率与重要性采样之间的内在联系,也可以解释若干既有方法的机理。例如,字节Seed团队的“Clip Higher”会纳入更多“低概率正样本”,从而稳定熵;千问团队的“80/20 Rule”在训练中只保留最高熵的前 20% token,用以稳定熵并维持探索;SkyWork 团队的“Target-Entropy”也有相近作用。
总而言之,BAPO 让 Off-Policy RL 在训练 LLM 时更稳定、更高效。通过识别正负样本间的优化失衡,并提出支配探索行为的“熵—裁剪规则”,BAPO 动态调节裁剪边界,在平衡样本贡献的同时守住探索能力。大量跨模型、跨设置的实验验证了这一方法,我们希望我们的方法可以为 LLM 强化学习社区提供一些新的见解。