基于推测性解码的强化学习训练
引言
针对大型语言模型的**强化学习 Reinforcement Learning (RL)**通常通过三阶段迭代进行:生成、推理和训练。在生成阶段,Actor 模型为一批 prompt 生成 rollout 轨迹。该阶段包含 prefill 步骤,随后通过自回归 decode tokens 直至终止。在 inference 阶段,辅助模型(reference 模型、reward 模型、critic 模型)通过前向传播评估生成的轨迹,生成用于更新的标量信号。最后在训练阶段,Actor 模型利用这些信号计算损失函数并执行参数更新。
在这三个阶段中,生成阶段,被一致认为是主导性瓶颈。因为大型语言模型(LLM)的推理通常需要使用自回归采样。它们的推理过程相当缓慢,需要逐个token地进行串行解码。因此大型模型的推理过程往往受制于访存速度,生成每个标记都需要将所有参数从存储单元传输到计算单元,因此内存访问带宽成为严重的瓶颈。
如表1所示,对于最大响应长度为8K token的LLM,在数学和代码模型的训练中,生成阶段分别占据了高达86%和75%的单次迭代时间。
| 模型类型 | 生成阶段耗时占比 | 推断阶段耗时占比 | 训练阶段耗时占比 |
|---|---|---|---|
| 数学模型 | 86% | 10% | 4% |
| 代码模型 | 75% | 15% | 10% |
**推测解码 Speculative Decoding(SD)**是一种可以从根本上解码计算访存比的方法,保证和使用原始 Target 模型的采样分布完全相同。它使用两个模型:一个是原始 Target model,另一个是比原始模型小得多的近似模型 Draft model。Draft model 用于进行自回归串行采样,而大型 Target 模型则用于评估采样结果。解码过程中,某些token的解码相对容易,某些token的解码则很困难。因此,简单的token生成可以交给小型模型处理,而困难的token则交给大型模型处理。 过程如下:
- 用 Draft model 做自回归采样连续生成 n 个tokens。
- 把生成的 n 个tokens 和前缀拼接一起送进 Target model 执行一次forwards。和自回归相比,尽管计算量一样,但是 n 个tokens可以同时参与计算,计算访存比显著提升。
- 使用 Target,Draft model 的 logits 结果做比对,如果发现某个 token,Draft model 生成的不好,重新采样这个 token。重复步骤1。
- 如果 Draft model 生成结果都满意,则用 Target model 采样下一个token。重复步骤1。
SD已在诸多LLM Serving 系统(如SGLang, TensorRT-LLM)和商业平台(如OpenAI, AWS SageMaker)中得到广泛应用。在众多无损SD变体中,EAGLE-3 代表了当前最高水平,在同类方法中取得了最高的加速比报告。因此,在我们的分析、实现与实验中,均以EAGLE-3作为默认SD算法。
现有研究的不足
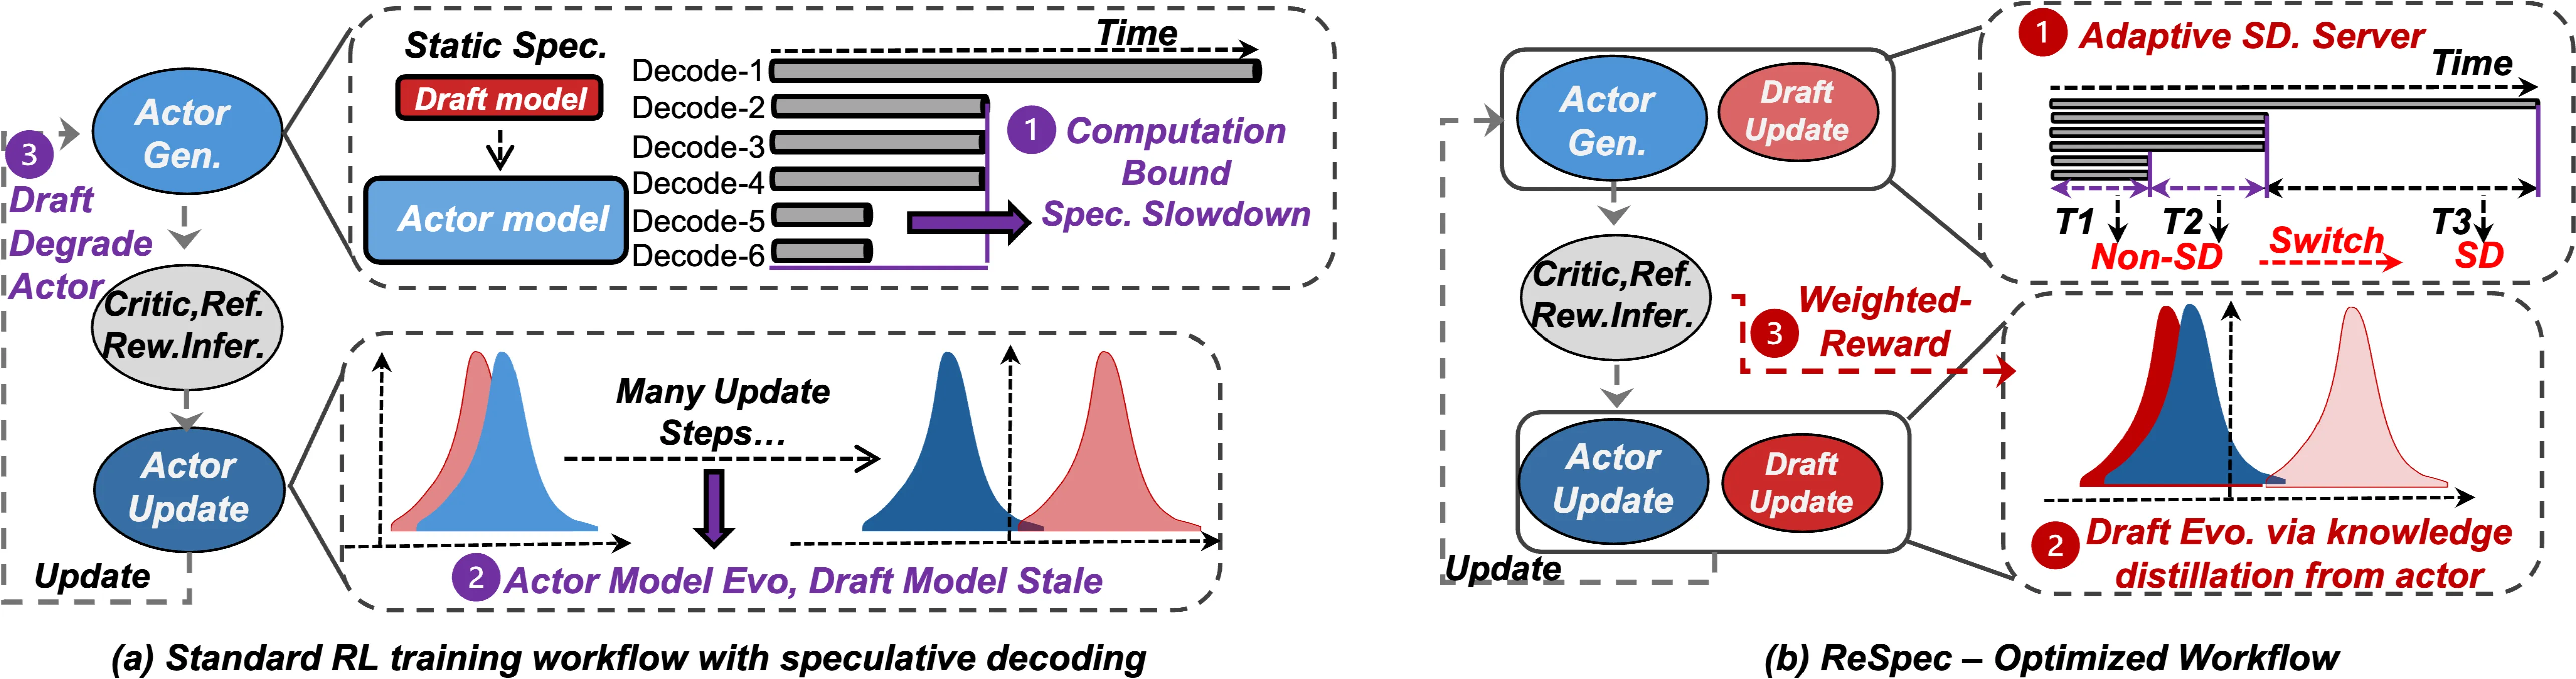
尽管 Speculative Decoding 在 LLM Serving 系统中取得了普遍成功,但其在 RL 训练环境下的行为从未被系统性地审视过。通过对 RL 工作流的分析及将 Speculative Decoding 的原型集成到 RL 生成阶段的实践,我们识别出三个根本性的 GAPs,这些 GAPs 解释了为何简单套用 Speculative Decoding 无法在RL训练中带来持续稳定的收益(如图1(a)所示)。
-
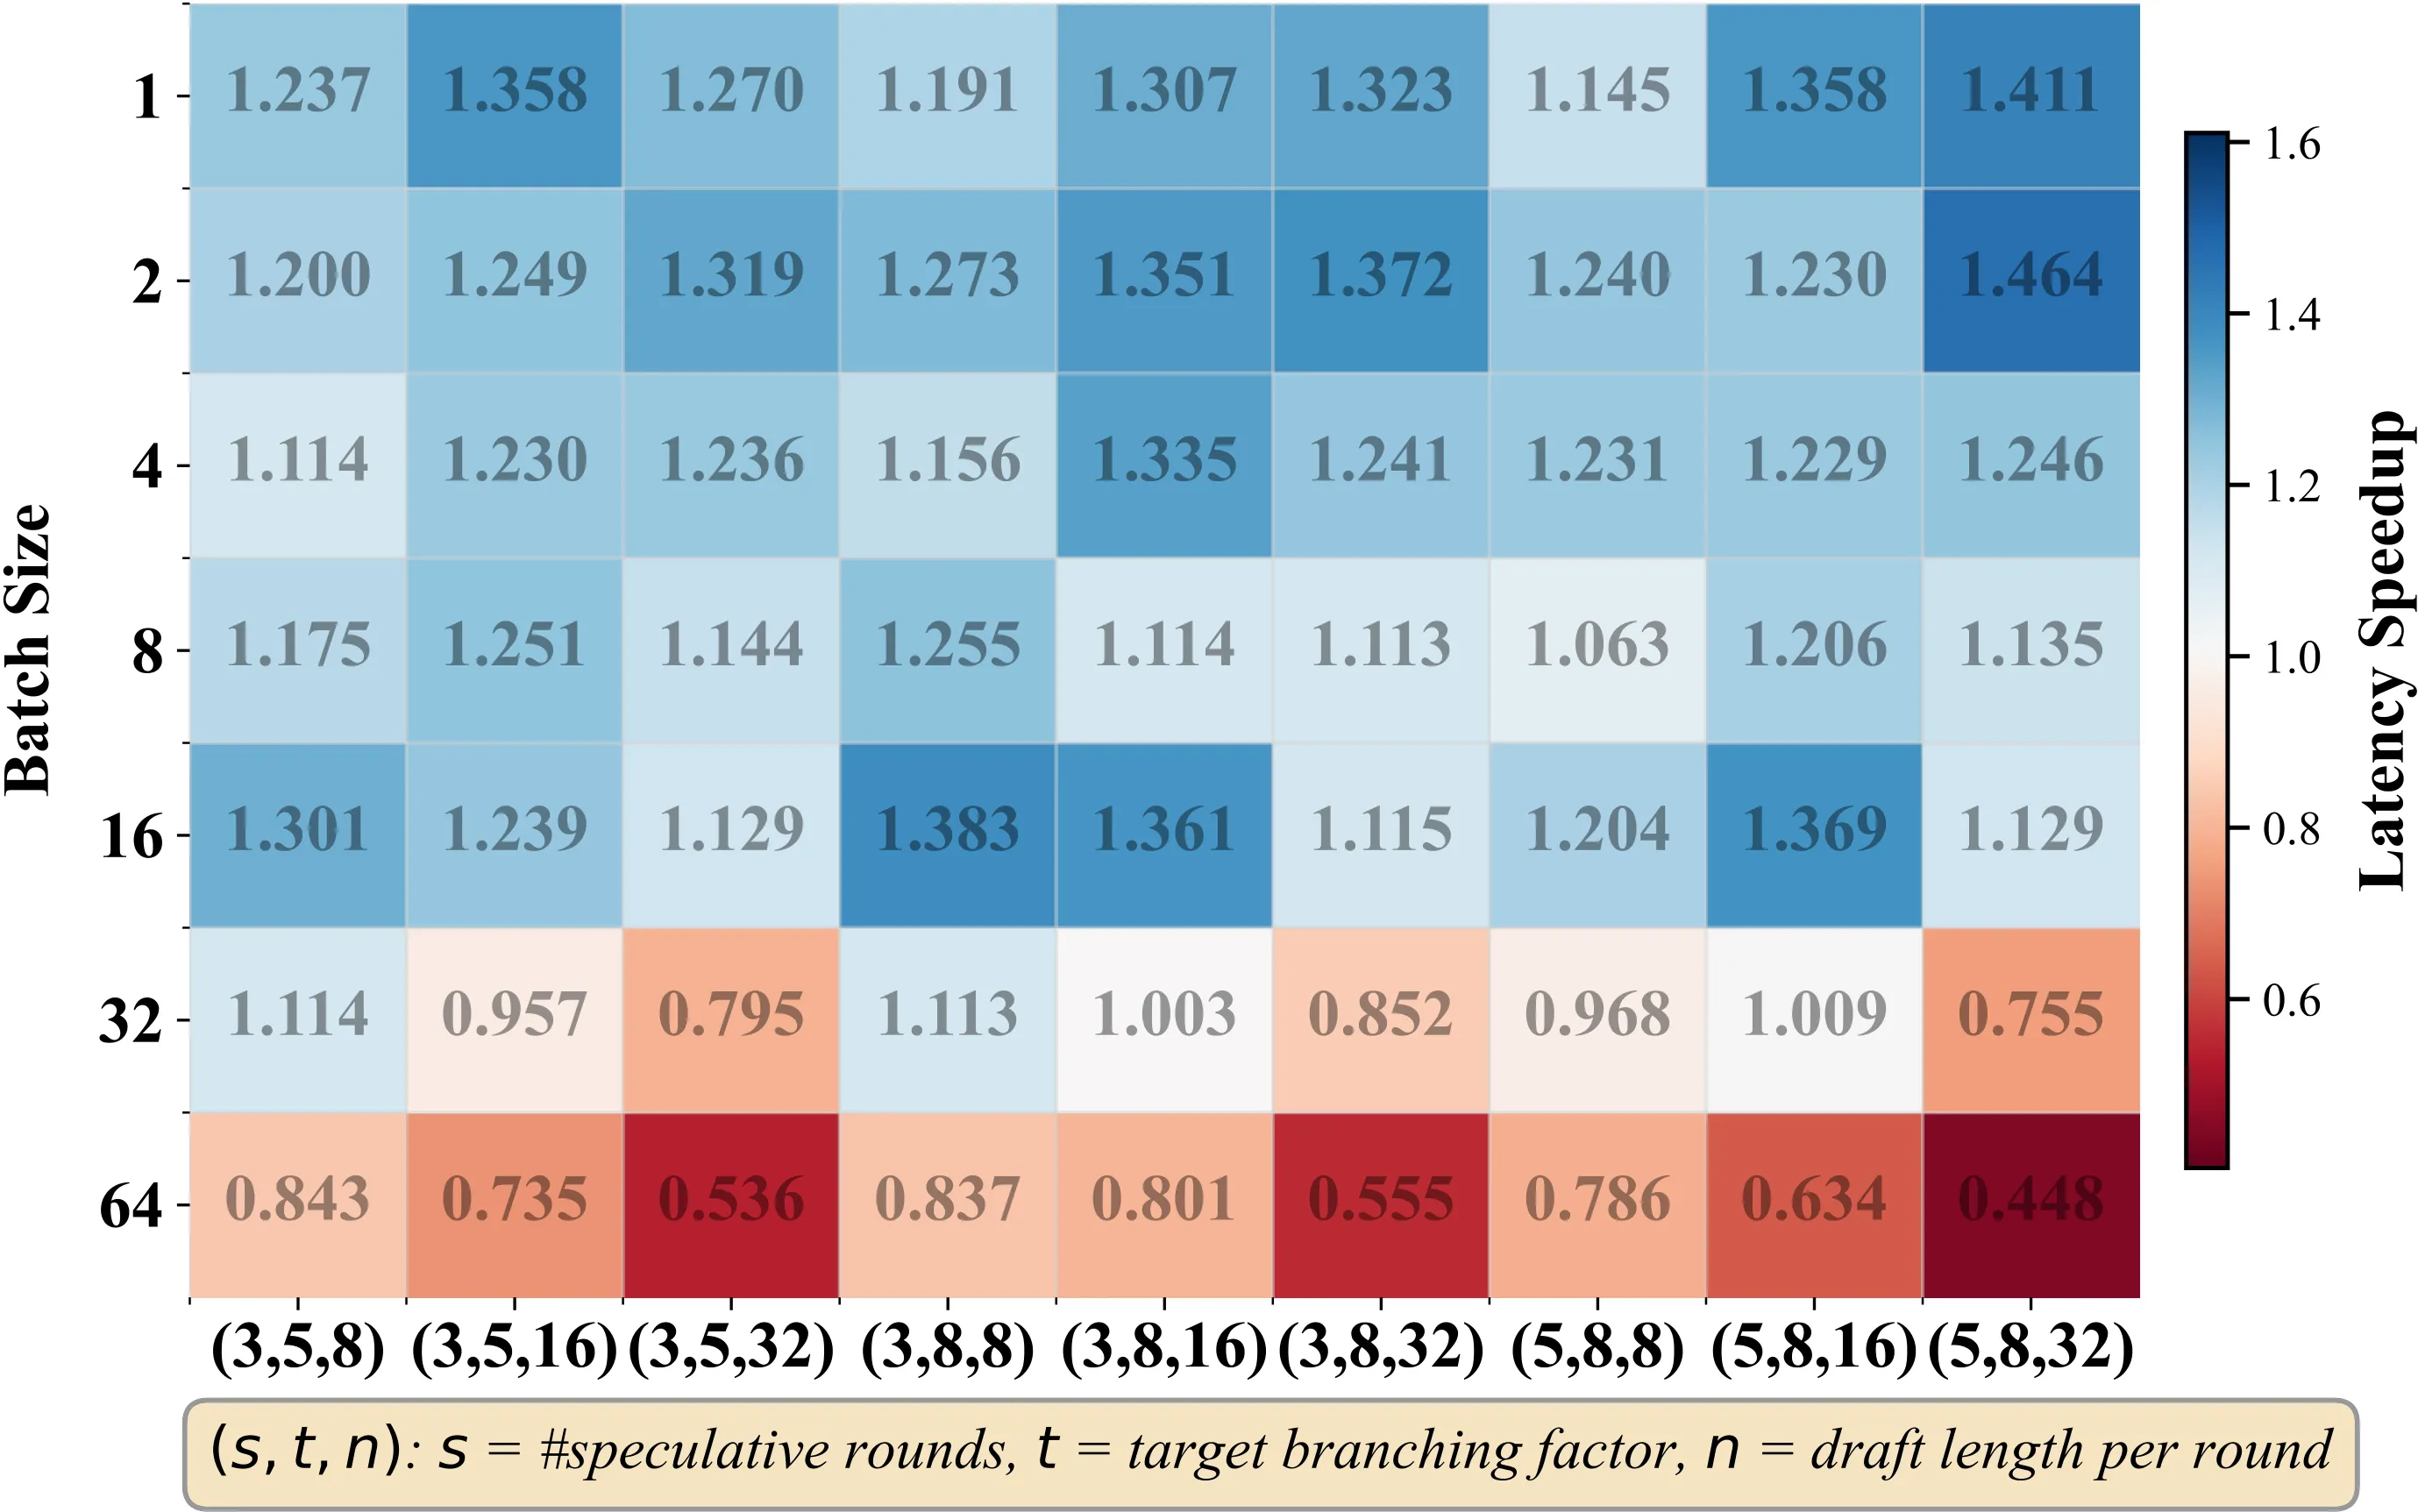
G1:Speculative Decoding 在 batch size 大时会失效,甚至是负优化。如图2所示。 原因是 Target model verify tokens 的计算模型是:
假设每个 request 需要验证 draft model 生成的 16 tokens,并且此时 batch_size = 32
    总等效 batch size = 16 × 32 = 512

当等效 batch size 达到 512 时:
    GPU 完全进入 compute bound
    验证成本太高
    speculative 接受的 token 不足以抵消额外延迟
    反而更慢
图2展现了不同 batch size 下 SD 的加速效果对比,可以看到在 batch size = 16 时,EAGLE3 算法对于 Qwen2.5-7B 的生成是负优化。
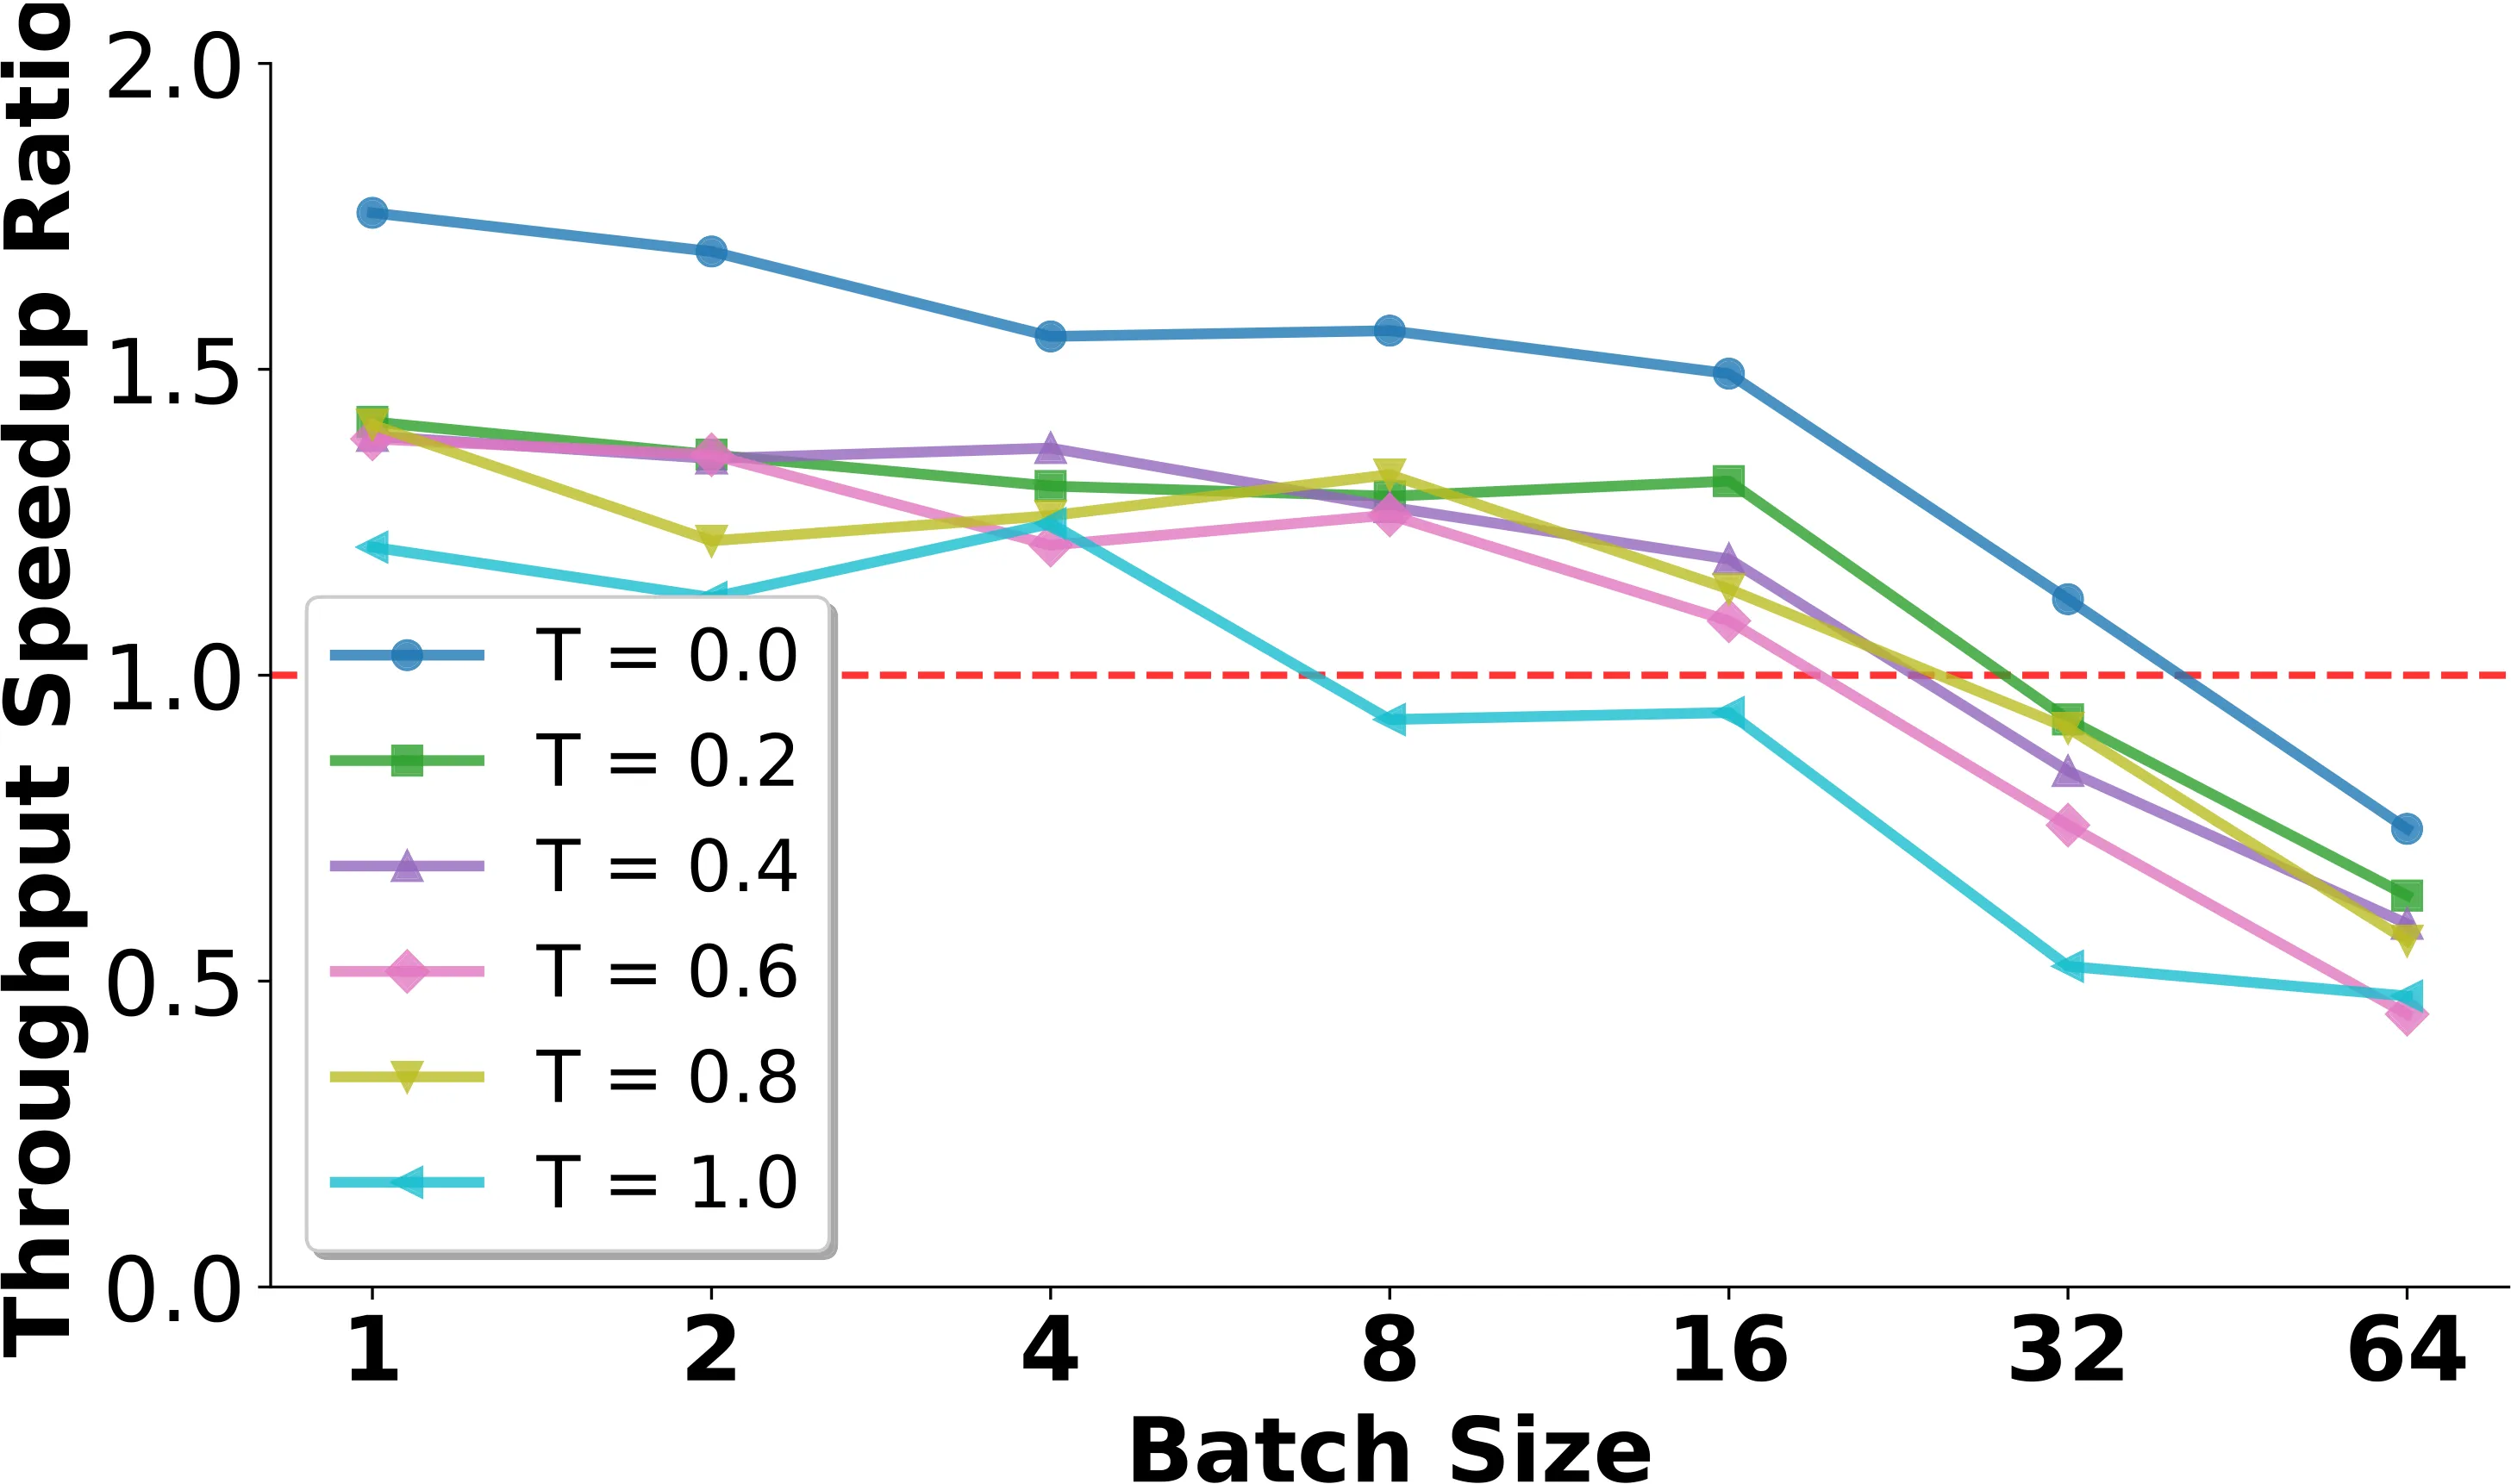
图2:EAGLE推测解码在不同批次规模下的加速比,展示了大批次下加速效益递减的现象 -
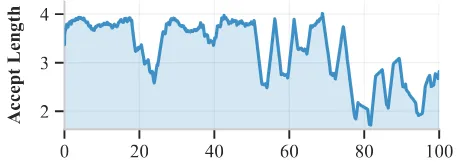
G2:持续 Actor 更新导致的 Draft model Stale。 随着 Actor(即 Target)模型在每次策略更新中不断演化,一个固定的 Draft model 会迅速与 Target model 的分布失准,导致加速收益丧失,如图3中观察到的接受长度下降所示。
-
G3:Draft model 诱发的 Actor 性能退化。 SD 算法本身是完全无损的。造成 Actor 性能退化的原因是现有推理框架实现上的系统性误差,具体来说是 SD 算法还没实现确定性推理。 将 gsm8k 的数据运行多次,使用和不使用 EAGLE3 算法的准确率结果,可以看到不使用 EAGLE3时,准确率是稳定的 0.595,而使用 EAGLE3 算法的准确率会上下波动。这体现了推理框架没有为 EAGLE3 这个算法实现确定性推理。
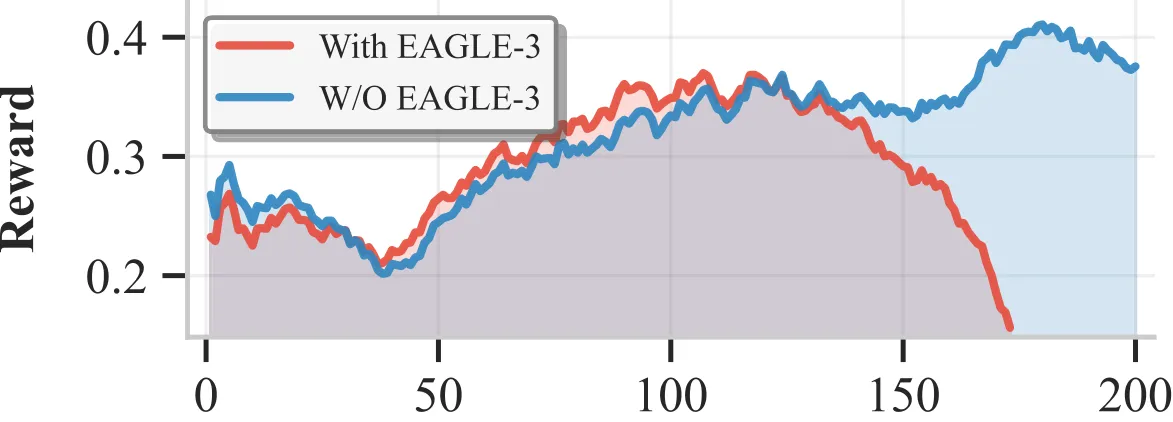
Setting Run1 Run2 Run3 Run4 Run5 with EAGLE3 0.535 0.630 0.565 0.565 0.605 w/o EAGLE3 0.595 0.595 0.595 0.595 0.595 Target model 接受 Draft model propose 的单 Token 在数学上是完全和 Target model 自己生成这个 token 等价的,多 tokens 可能存在较大方差。 而推理系统没有实现 SD 算法的确定性推理,那么这种方差会随着 Draft model 的 Staleness(G2)而加剧,导致生成低质量轨迹的比例升高。在RL环境中,这种分布偏移会降低下游奖励,并在策略优化过程中提供误导性的梯度,如图4所示。
机遇:RL生成阶段的独特优势
在挑战之外,我们也识别出 RL 生成阶段的两个关键机遇,可被用来使 SD 既稳定又高效。
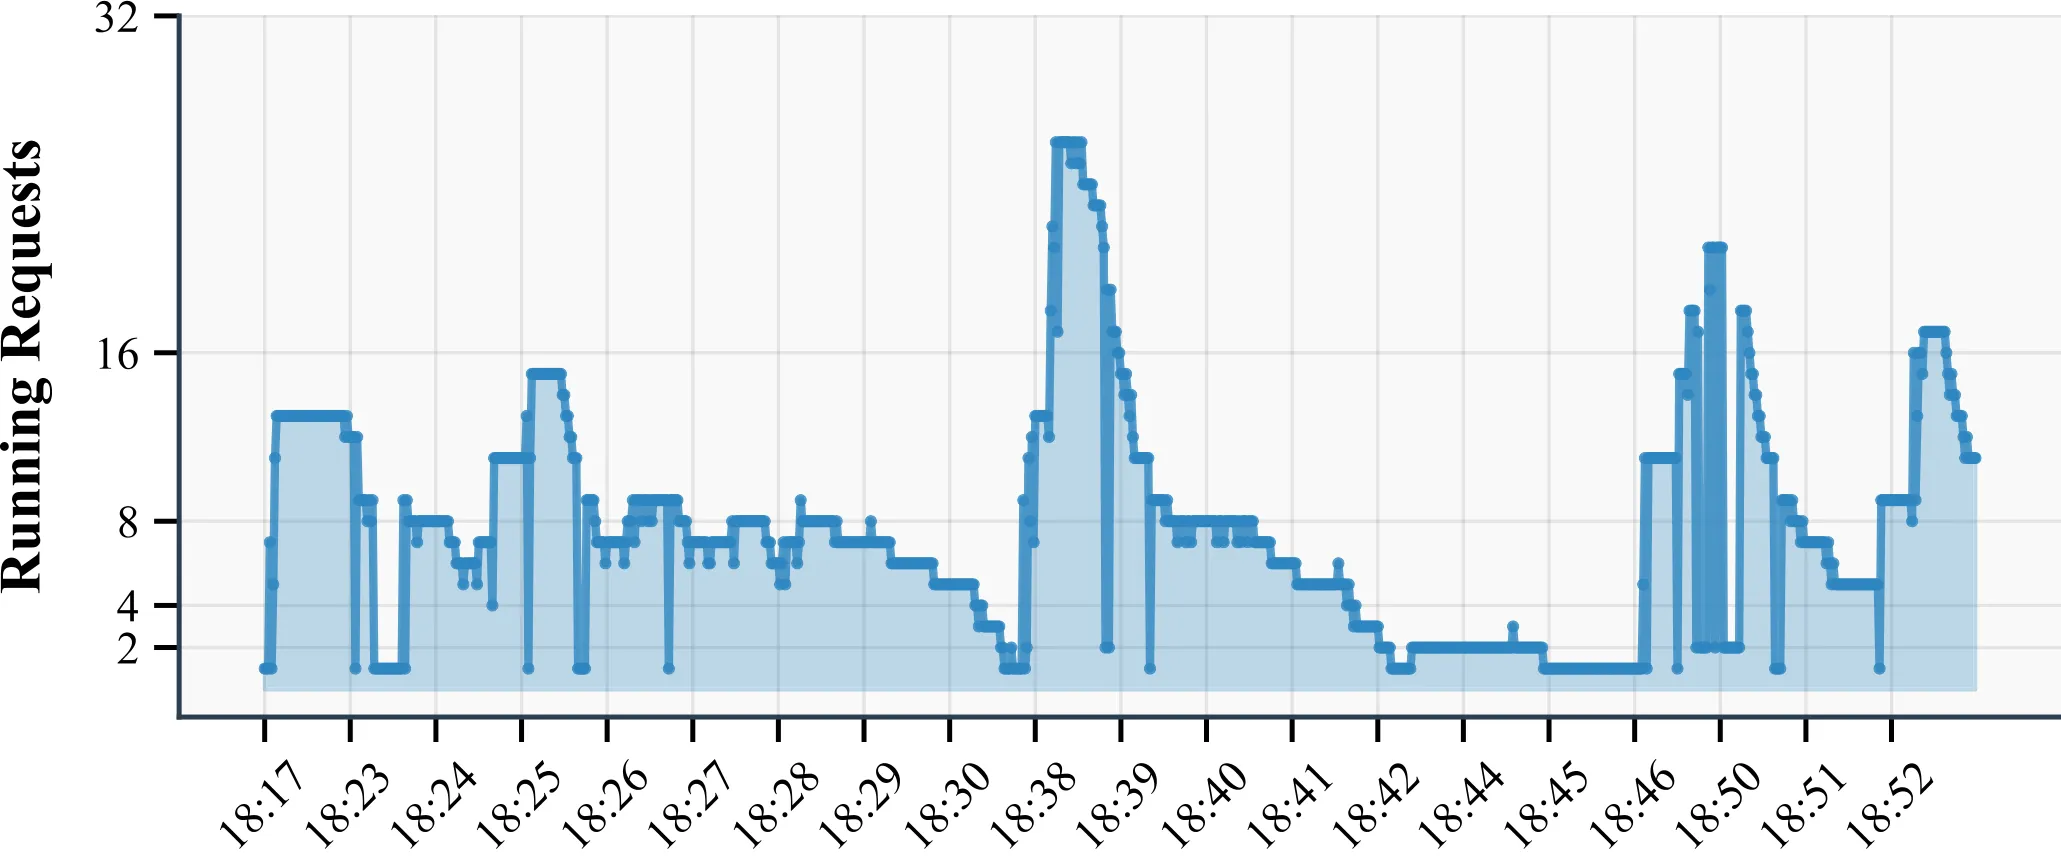
- 生成阶段的 Skewness :在一个批次内,大多数序列会提前终止,而一小部分序列则持续更长,导致随时间变化的活跃批次大小。由于SD的效率依赖于批次大小,这种 Skewness 为动态调整SD配置而非依赖静态超参数提供了机会。具体来说,我们可以根据不同时刻下活跃的 batch size 的数量,如图5,去动态调整是否需要使用 SD,以及使用 SD 的什么配置,如图6。
- 丰富的轨迹信号:RL轨迹生成过程内在地产生了丰富的、轨迹信号(如每步的逻辑值、奖励),这些信号通常被记录但从未被 Draft model 使用。它们为维持 Draft model 与演化中演员策略的对齐提供了宝贵的、未被利用的监督源,使得持续适应无需为采样过程引入额外开销。
ReSpec 系统设计
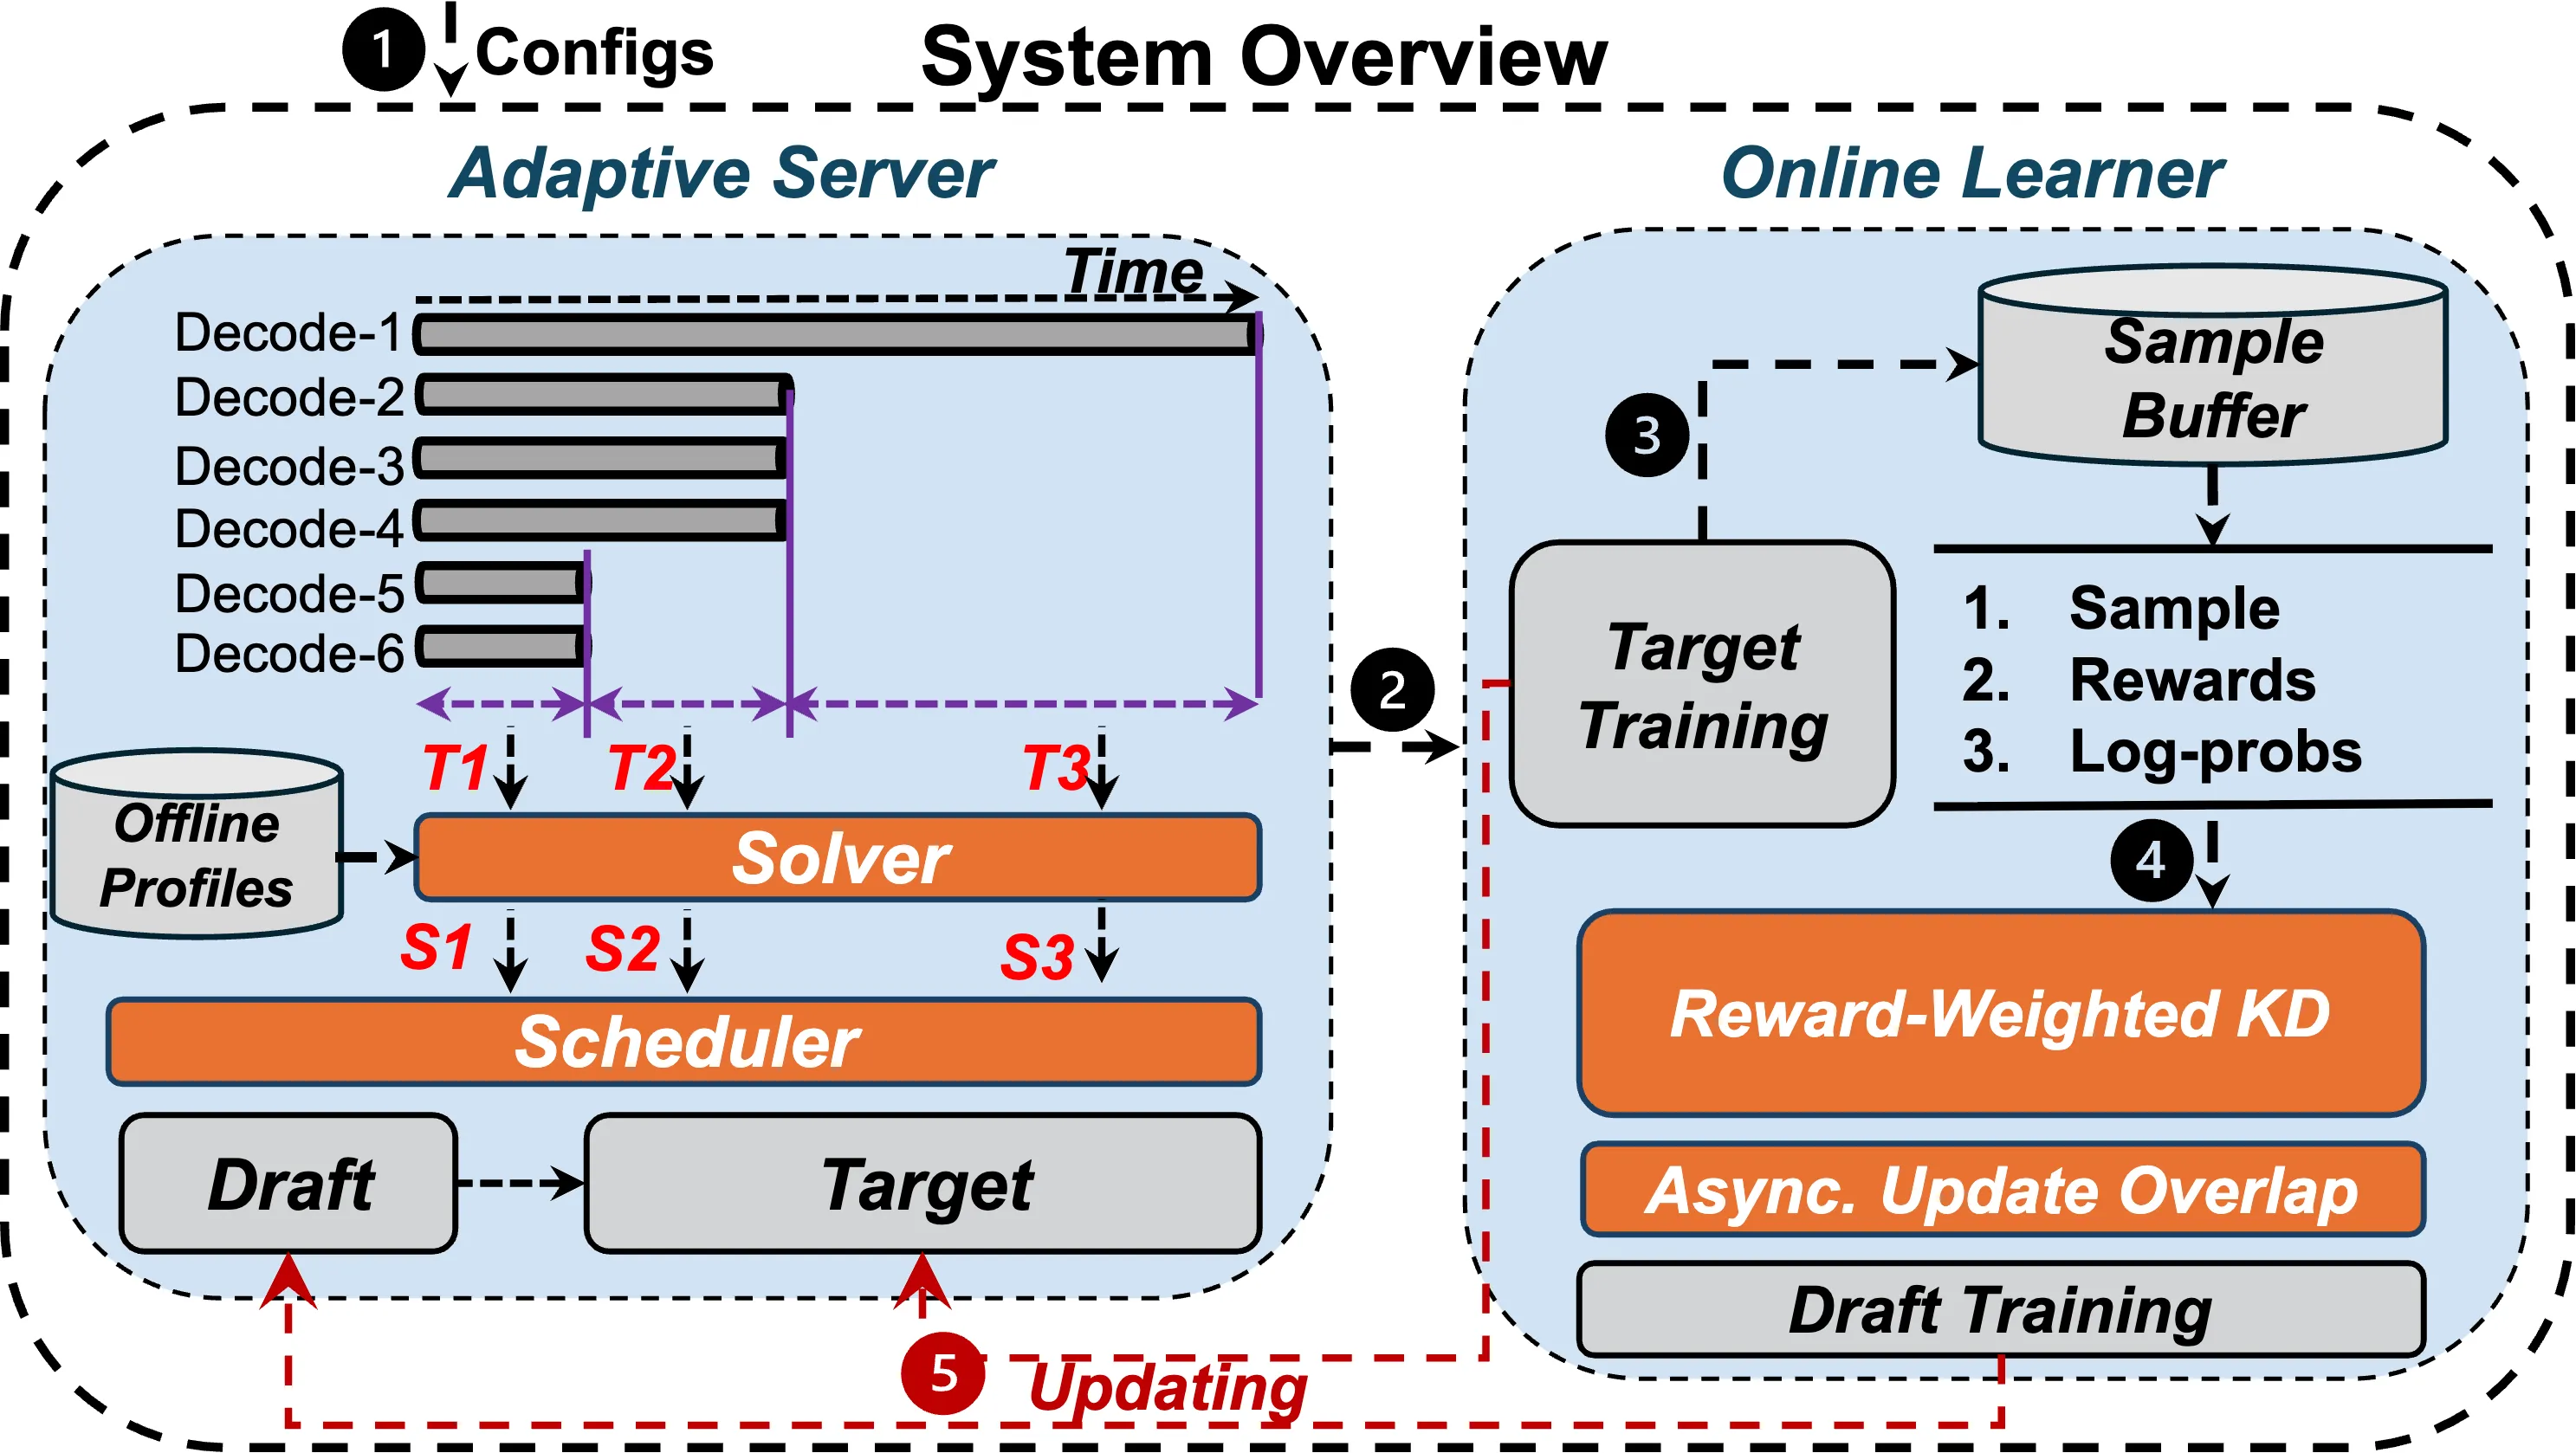
基于上述 GAPs 与机遇,我们提出了 ReSpec,一个使推测解码适应RL训练独特需求的系统。ReSpec 提供了三种针对性机制,分别直接解决一个 GAP(图1(b))。
-
自适应推测解码服务:针对G1,我们设计了自适应推测解码服务。它基于轻量级性能剖析和运行时工作负载信号,根据正在运行的 batch size 动态选择并应用推测解码配置。
-
基于知识蒸馏的 Draft model 演化与在线学习器:针对G2,我们引入了基于知识蒸馏的 Draft model 演化机制。为使 Draft model 与持续更新的 Actor(Target)保持对齐,我们利用来自 Actor 的轨迹来演化 Draft model。该蒸馏管道持续地将 Actor 的分布知识迁移到轻量级 Draft model 中,确保 drafted proposals 在策略变化时依然有效。 然而我们发现简单的 KD 算法- 即计算 targe 和 draft model 的 logits 的 KL 会进一步加速 RL 训练的崩溃,这是因为引入有害于策略学习的分布偏移。
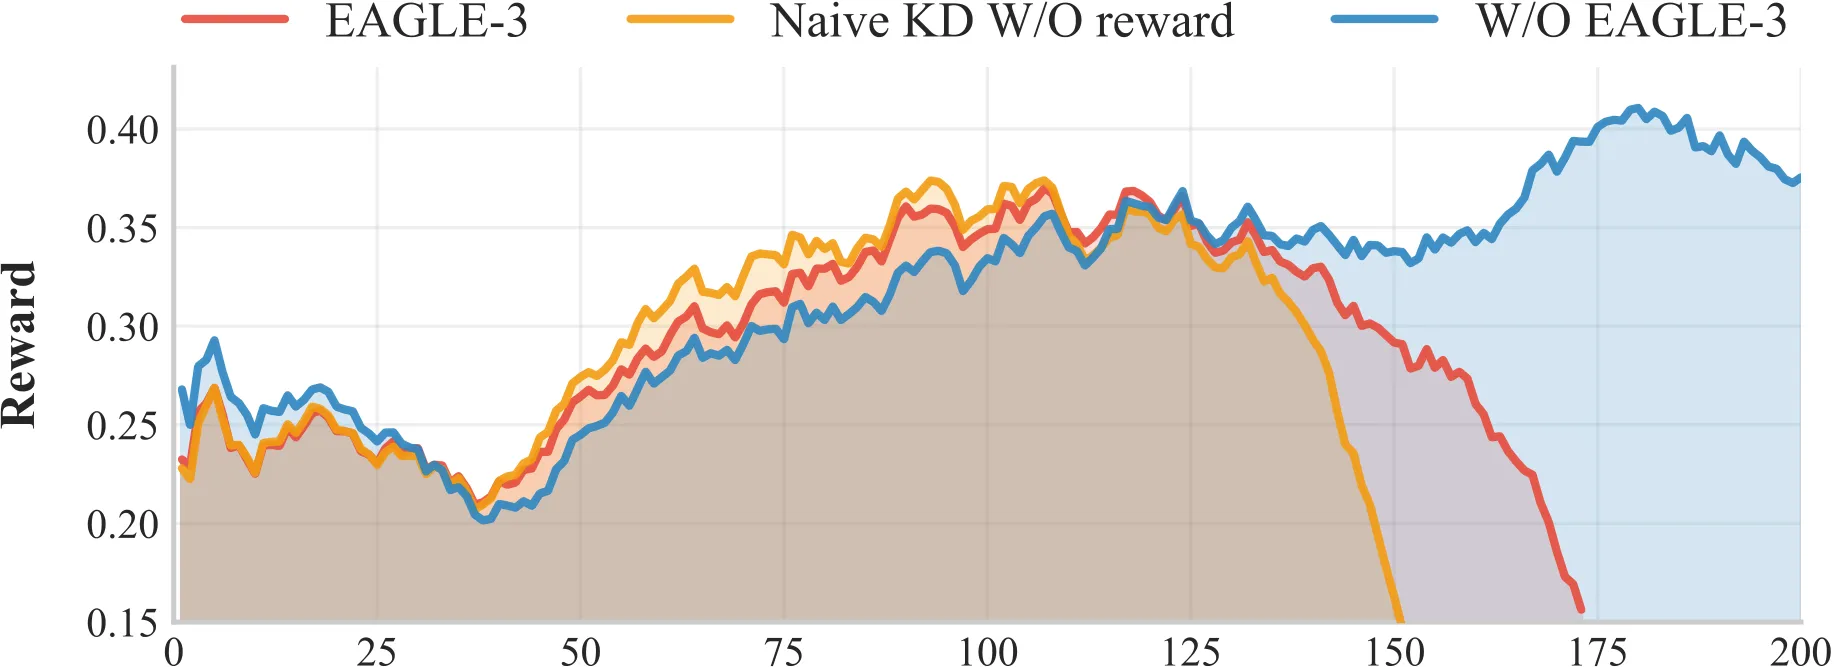
- 奖励加权的适应机制:针对G3,我们设计了奖励加权的适应机制。为避免引入有害于策略学习的分布偏移,我们根据轨迹质量对 Draft model 的更新进行加权,在适应过程中优先考虑高奖励轨迹。此机制确保 Draft model 倾向于那些保持或提升下游奖励的轨迹,降低了在RL优化过程中产生误导梯度的风险。
具体来说,2 和 3 整体是一个 Reward-Weighted 知识蒸馏算法:
1. 数据存储:对每条 rollout,记录输入与生成的响应,同时保存目标 logits 和标量奖励(scalar reward)。
2. 提取蒸馏目标:在线学习器从 rollout buffer 中提取蒸馏目标,并将其累积到 replay buffer (Q) 中。
3. 周期更新:每隔 (I) 次迭代,执行一次奖励加权更新(reward-weighted update),其作用包括:
  - 保持 drafter 与目标分布对齐,从而在 SD 中维持高接受率;
  - 引导 drafter 偏向那些在实际 RL 训练中能获得更高奖励的行为模式。
  - 对于为什么使用周期更新有两个原因:
    - 1. 系统上:可以隐藏 draft model 训练的开销。
    - 2. 算法上: 根据 Scaling Law,Target model 和 Draft model 的参数量不同,因此保持同样的更新频率反而会训崩 Draft。因此我们提出了异步更新 draft model 的机制,如图9。
算法表达为:其中 Target model , draft model ,reward
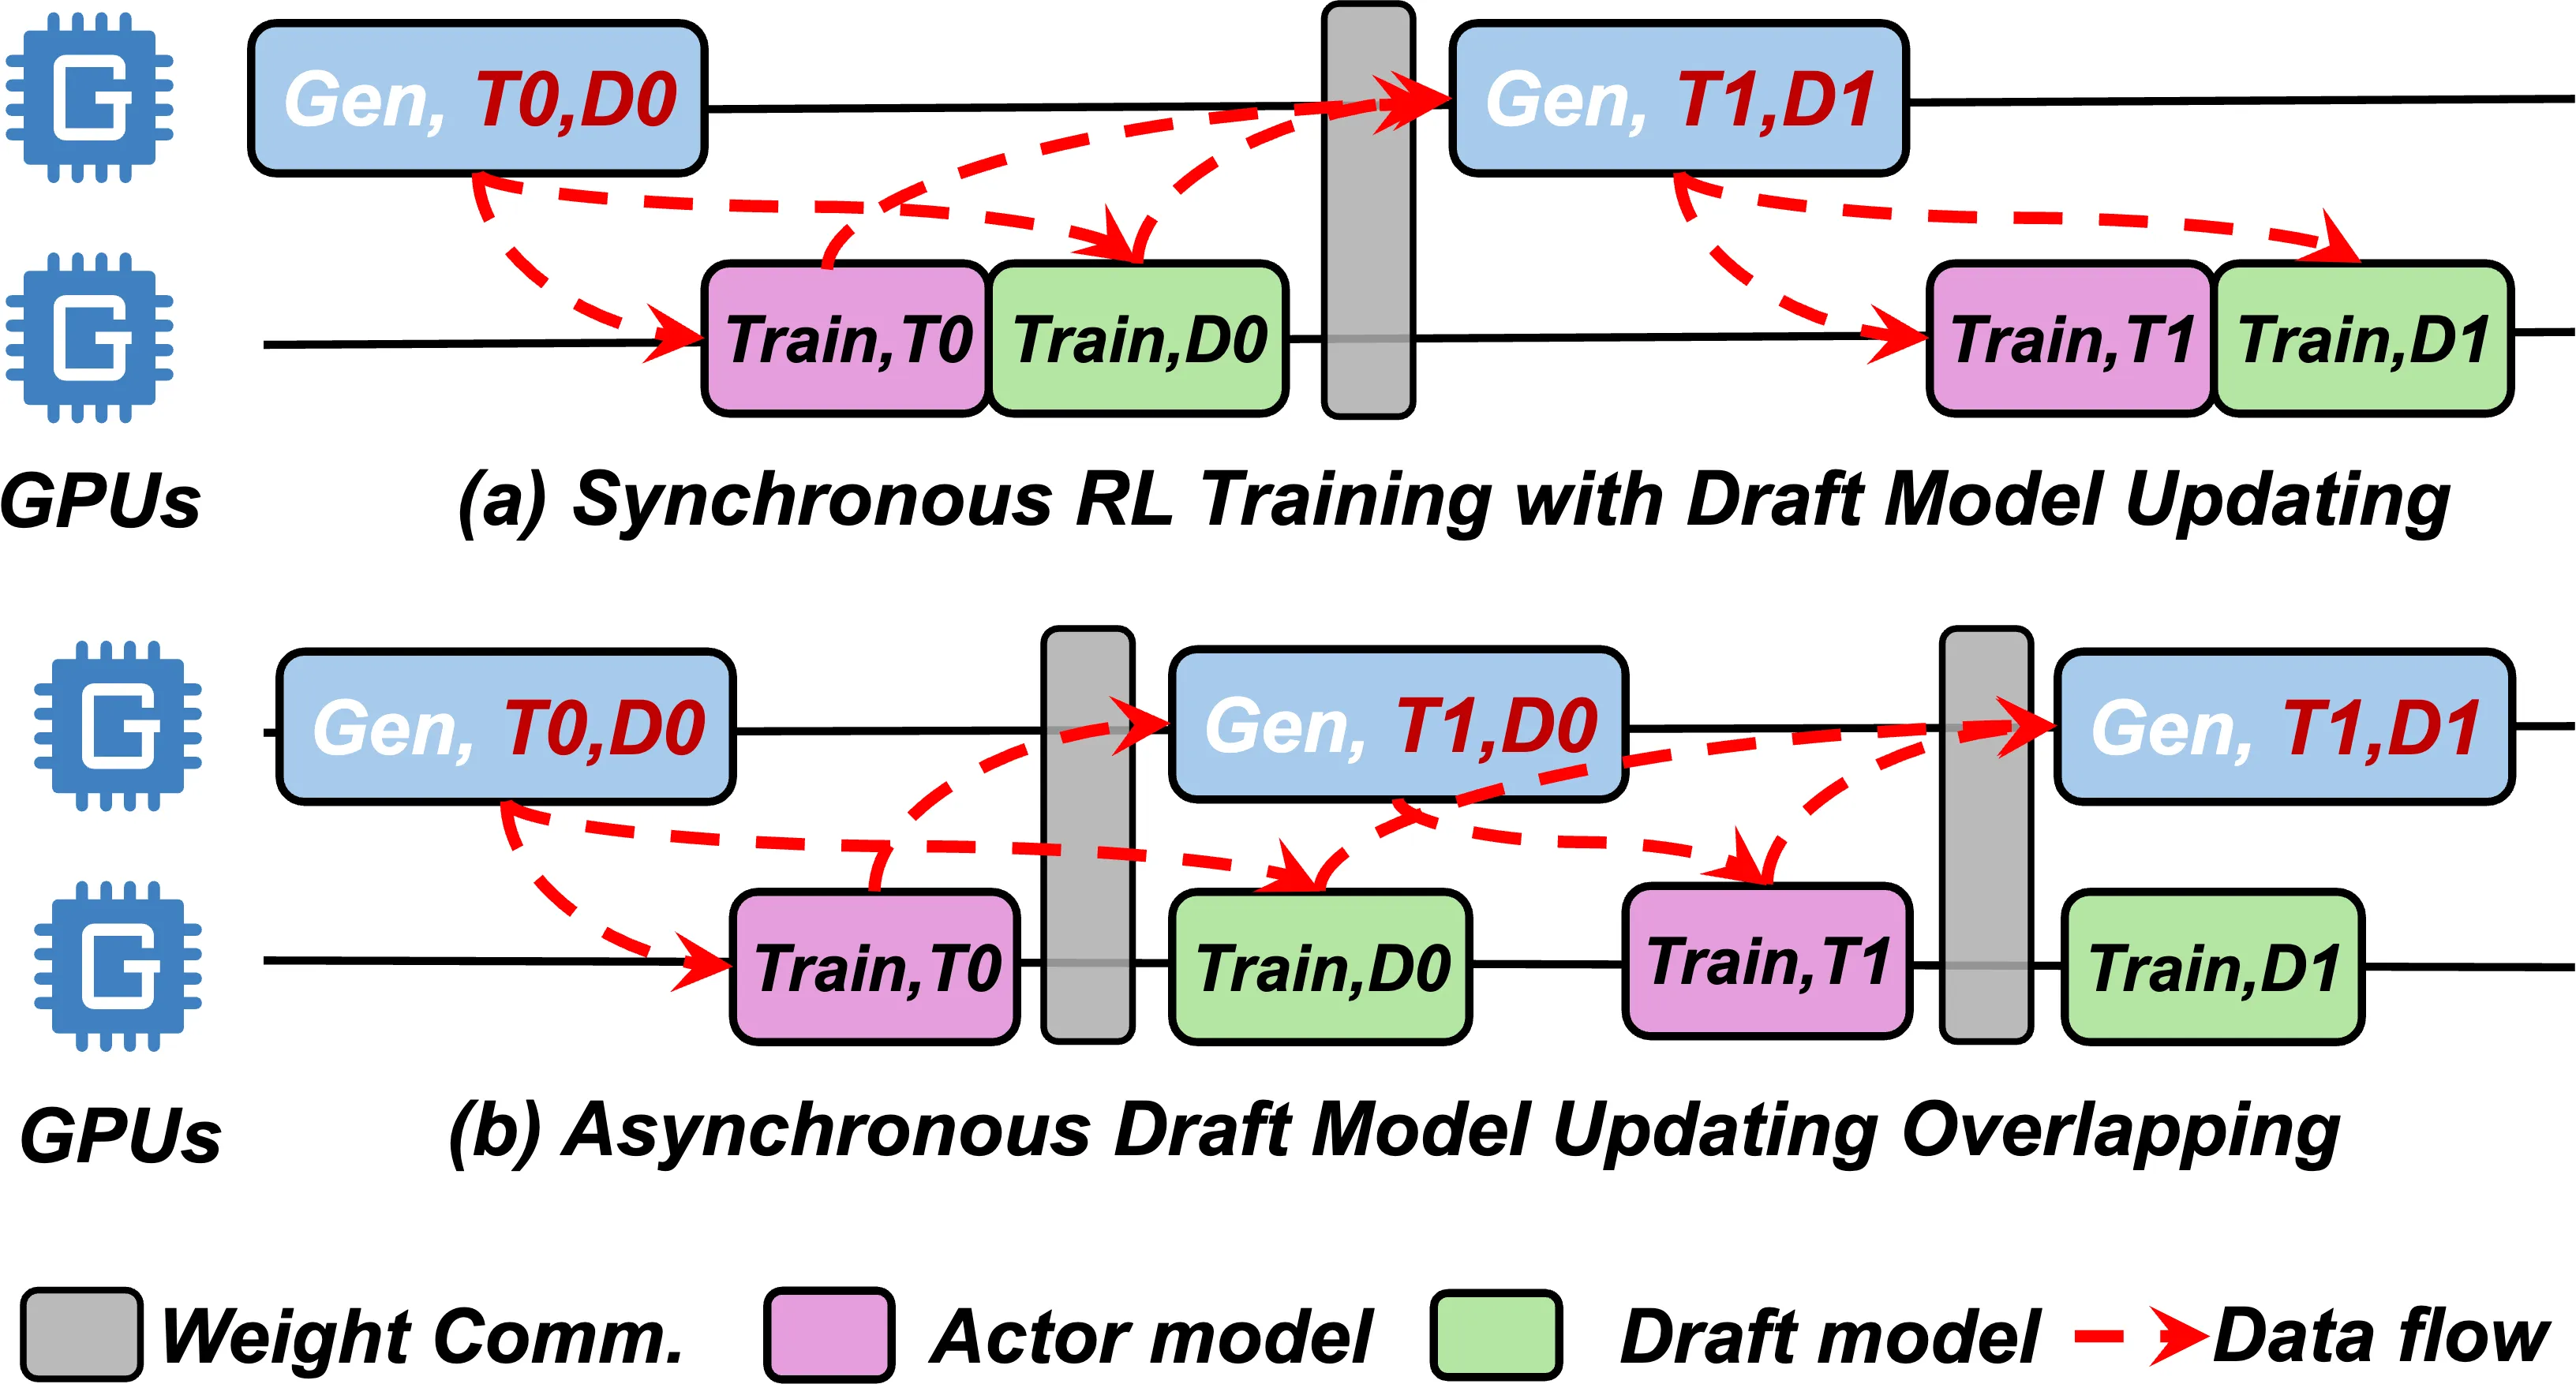
实验评估
我们在Qwen-2.5系列模型(3B-14B)上基于真实数学数据集进行系统评估,训练算法采用GRPO。
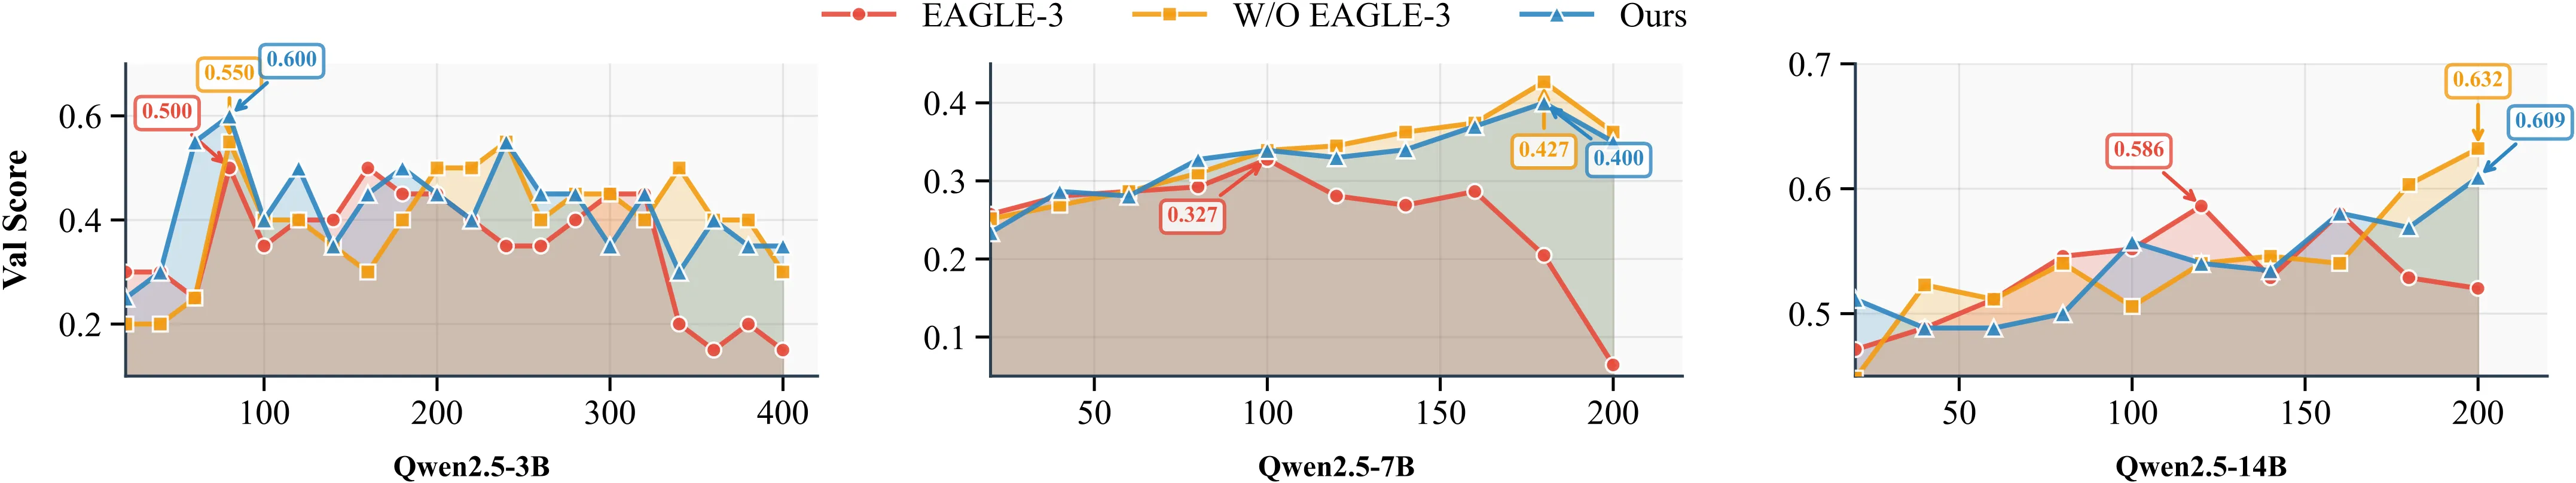
训练稳定性:如图10所示,ReSpec在验证分数上紧密跟踪无加速基线,而直接集成EAGLE-3会导致训练不稳定和显著的准确度下降。
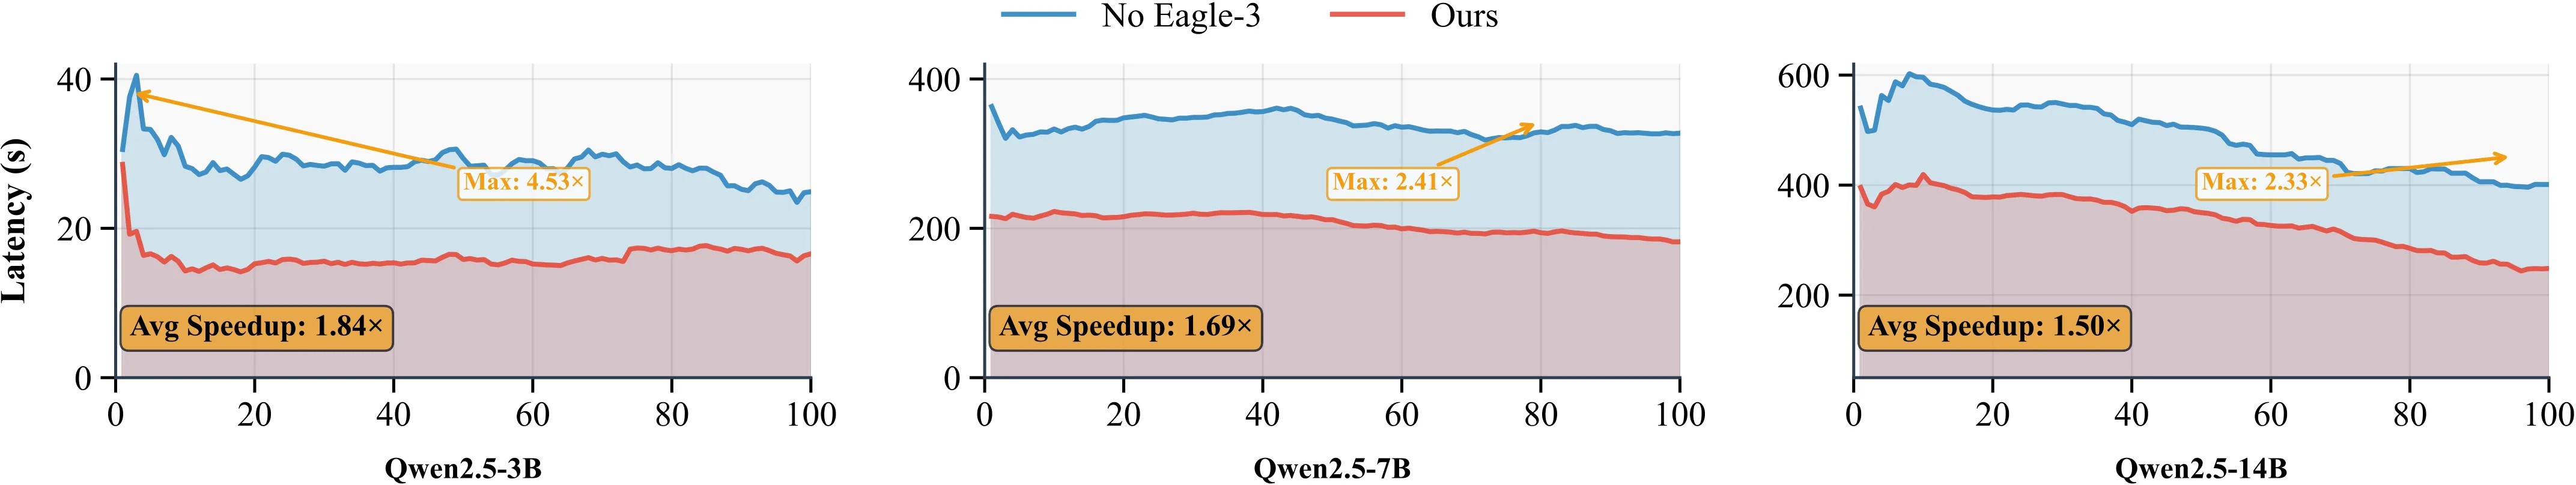
加速效果:ReSpec在端到端训练延迟上实现了1.5×–4.5×的稳定加速,如图11所示。加速效益在训练早期阶段尤为显著。
结论
ReSpec 首次系统性地解决了推测解码在 RL 训练中的适配挑战,通过动态配置选择、在线 drafter 对齐和奖励加权更新,在保持训练稳定性的同时实现了显著的端到端加速。ReSpec为大规模RL训练提供了实用的加速解决方案,代码实现基于VeRL和 SGLang 平台,其中动态配置选择SD已经开源在 SGLANG 社区,在线 drafter 对齐算法也被 Slime 等框架应用。
@misc{2025-respec,
  title   = {Speculative Decoding for RL Training},
  author  = {Qiaoling Chen in collaboration with others at Dawning Road},
  year    = {2025},
  url     = {/blog/respec/},
  note    = {Blog post},
  urldate = {2026-10-24},
}