面向 Blockwise FP8 量化的 ZeRO 优化器设计
引言
本文是我们在 FP8 训练探索系列的第二篇文章。在之前的文章中我们介绍了一种高效的 Grouped FP8 量化算子实现。随着 DeepSeek AI 在 2025 年开源 FP8 训练算子库 DeepGeMM,社区对 FP8 精度在大规模模型训练中的应用热度不断提升。然而,社区在 Blockwise 量化场景下仍缺乏一套高性能、工程化可落地的 ZeRO 优化器实现。为此,我们将回顾 ZeRO 与 Blockwise 量化技术的基础原理,并结合团队的工程实践,介绍一种适配 Hopper 架构、面向 Blockwise 量化的 ZeRO 优化器实现方案。该优化器已经在团队内部基于 DeepSeek 架构的原生 FP8 SFT 与 RL 任务中得到充分验证,欢迎持续关注我们有关FP8训练的技术分享。
背景知识
Blockwise 量化
量化是将高精度张量映射到低精度表示的过程,通常借助缩放因子实现。根据缩放因子的应用粒度,目前有四种常见的 FP8 量化方法,如上图所示:
-
Tensorwise(逐张量量化):对整个张量使用单一的缩放因子。虽然量化开销很低,但容易因极端值超出单一缩放因子的表示范围,导致精度丢失。
-
Blockwise(逐块量化):将张量划分为较小的块(如 128×128 的子矩阵),每个块使用独立的缩放因子。这种方法在计算效率和数值精度之间取得了较好的平衡,在DeepSeek-FP8中对权重进行量化。
-
Tokenwise(逐 Token 量化):这是一种更细粒度的量化方法,对每个 token 单独进行量化,通常使用 1×128 的量化范围,在DeepSeek-FP8中对激活进行量化。
-
MXFP8:NVIDIA 在 Blackwell 架构中引入的一种原生支持 Blockwise/Tokenwise 量化的 FP8 数据类型,它会对内存连续的块分配 E8M0 类型的缩放因子。
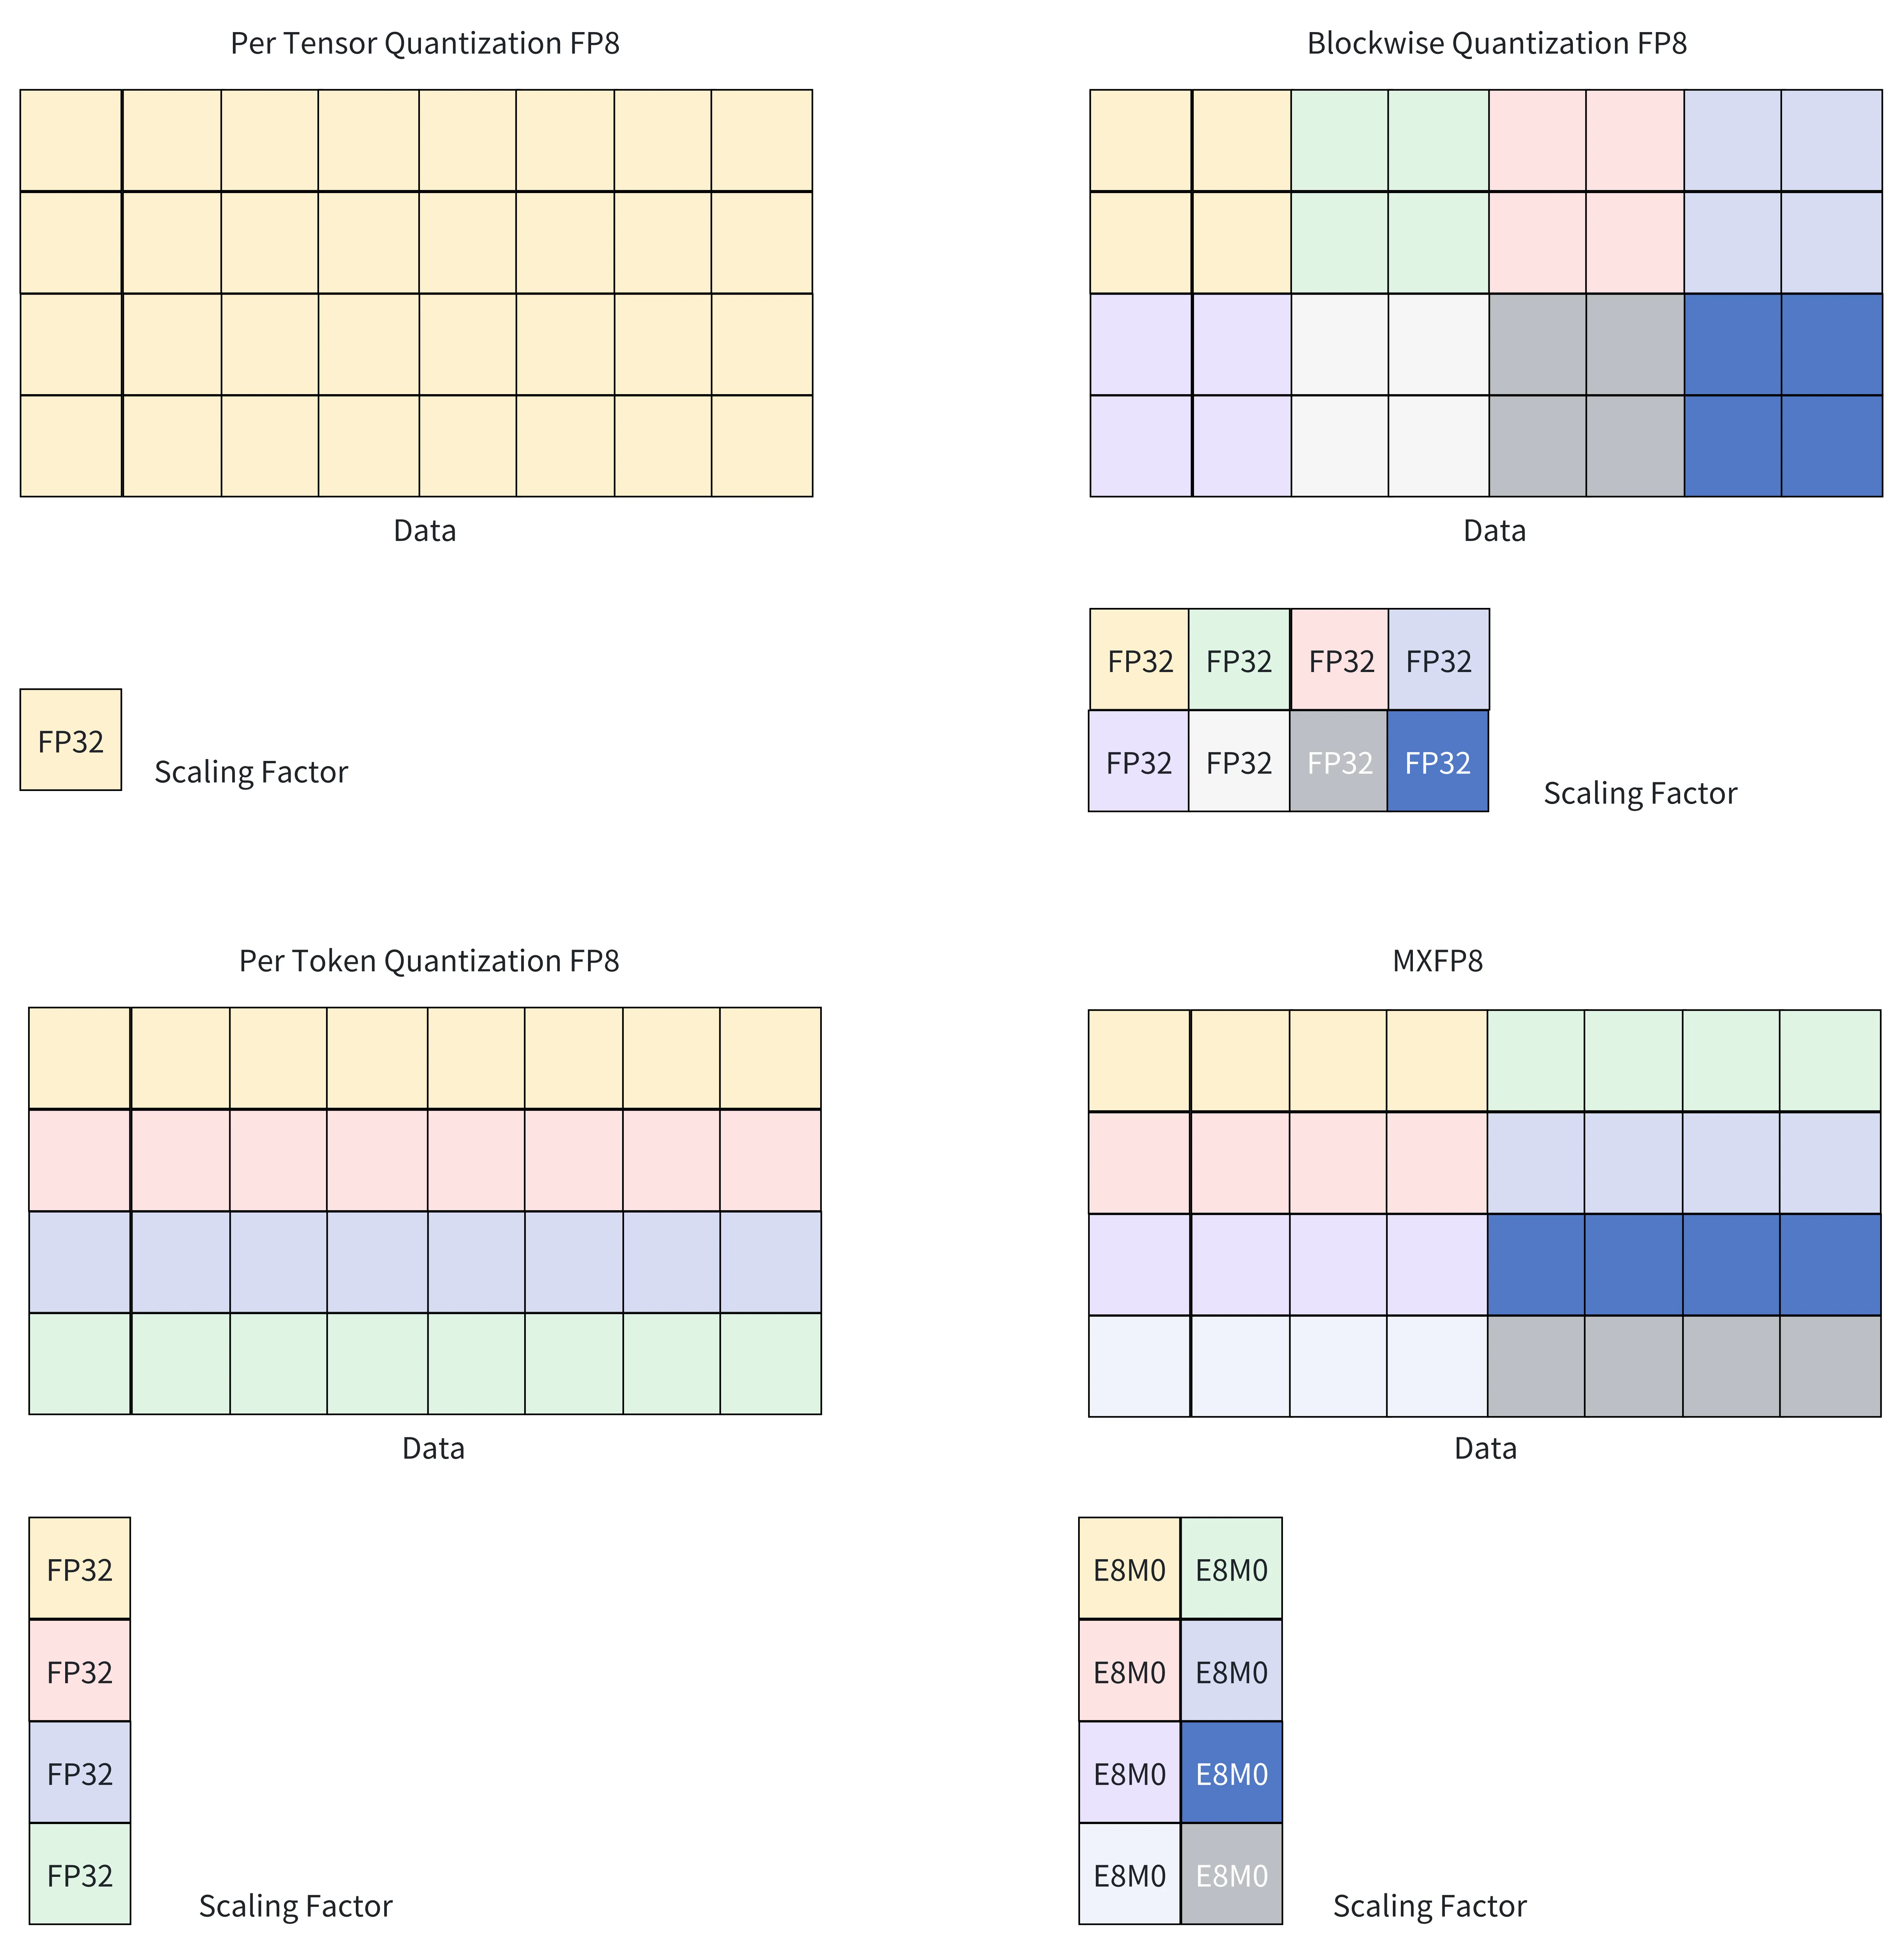
而我们今天要解决的问题背景——优化器只和权重打交道,因此我们只关注Blockwise(逐块量化)给ZeRO优化器实现带来的挑战。
ZeRO-1 优化器
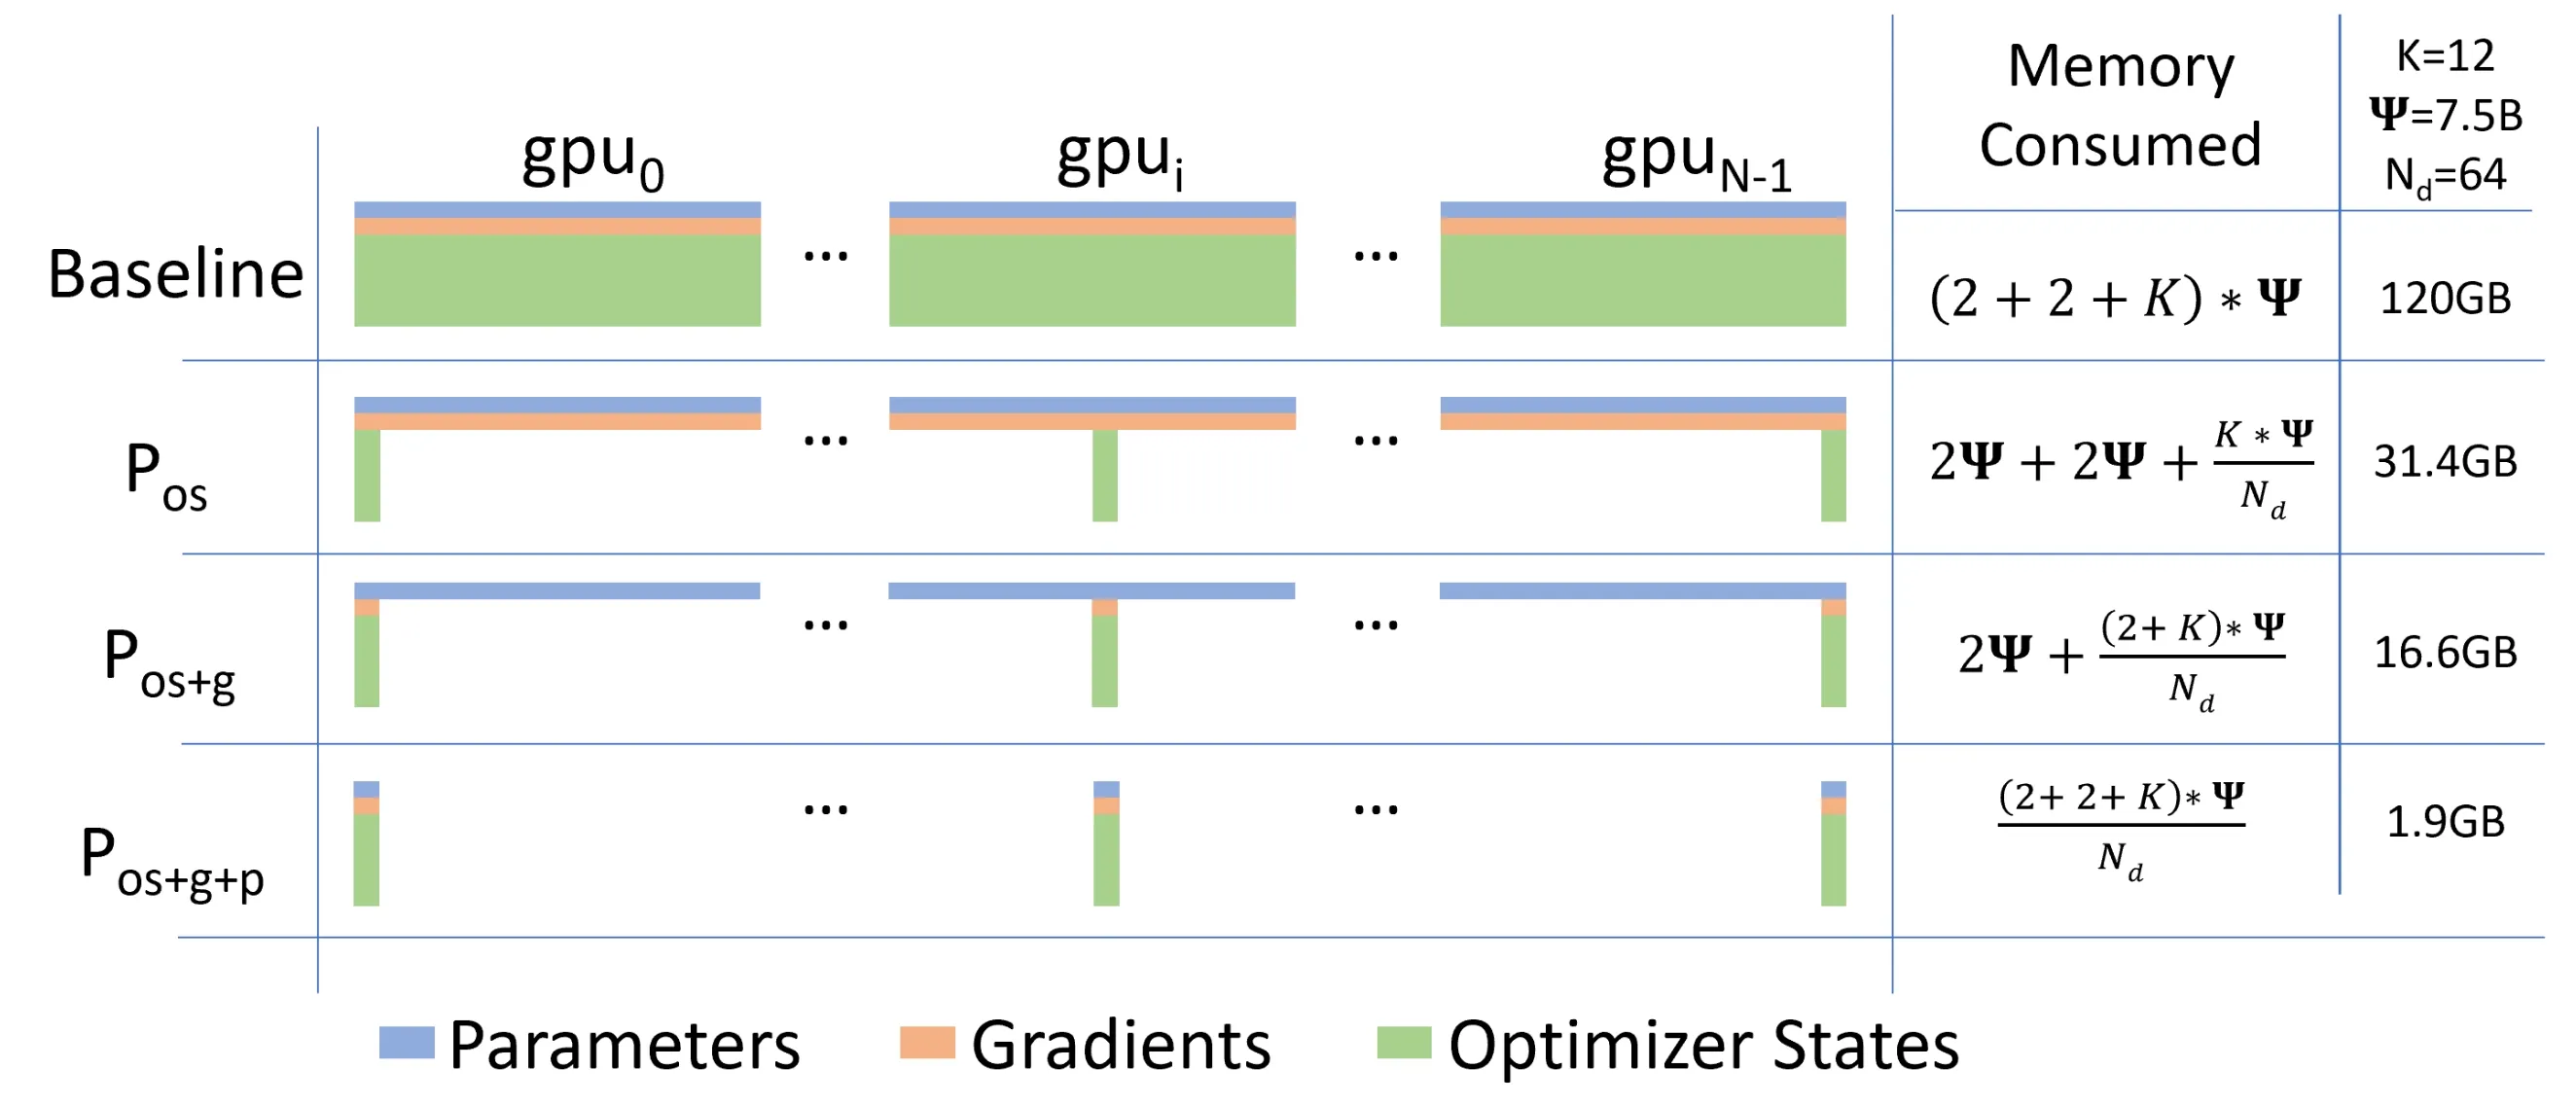
在深入 FP8 训练之前,我们首先回顾 ZeRO(Zero Redundancy Optimizer)[1] 的基本原理。ZeRO-1 是 ZeRO 的第一阶段优化,主要作用于 Model State(参数、梯度以及优化器状态),是整个 ZeRO 系列中显存节省效果最佳且通信代价最低的版本。在 ZeRO-1 中,绿色部分表示可在数据并行(DP)进程间共享的内容,对应论文中的 。
在如 Megatron 或 DeepSpeed 这类框架中,一个完整的分布式混合精度训练通常由多类模型状态共同参与更新,包括:
更新参数需要的组件(Model State):
- Whole Param:前向/反向传播中实际进行计算的权重
- Whole Gradient:反向传播中实际进行计算和通信的梯度
- Master (Main) Param:参数更新时的高精度 buffer
- Master Gradient:梯度累加时的高精度 buffer
- First-class Momentum:AdamW 优化器的一阶动量
- Second-class Momentum:AdamW 优化器的二阶动量
混合精度训练参数更新流程
我们这里借用 NVIDIA Megatron Core 的文档 [4],介绍一下在BF16混合精度训练下,ZeRO-1 优化器的更新流程:
- (初始化)对 FP32 精度的 Main Param 进行 ZeRO 切分
- bwd 完成
- 在每个 DP rank 上对梯度调用 reduce-scatter
- 每个 DP rank 现在有 4 个被 reduced 的 FP32 精度的梯度元素(这里我们使用FP32精度对梯度进行累加)
- 每个 DP rank 使用 slice 操作获得自己负责更新的 4 个 FP32 梯度元素
- 优化器执行参数更新(elementwise操作)
- 每个 DP rank 从 FP32 精度的 Main Param Buffer 中复制其 4 个 BF16 精度主参数元素到 Whole Param Buffer 中
- 在每个 DP rank 上调用 all-gather 获得全部 BF16 精度的参数
- Whole Param buffer现在包含所有 16 个完全更新的参数
- 进入下一轮 fwd
在实现上,Megatron/DeepSpeed 一类的训练框架往往将这些模型状态进行 flatten 后再切分存储。主要原因是优化器的参数更新是 element-wise 操作,可以均匀切分,将各个 DP rank 的参数同步 buffer 大小统一,从而有机会合并参数同步的通信次数,避免发起数量很多但通信量很小的通信,提高 ZeRO 参数同步带宽利用率。
Blockwise 量化给 ZeRO-1 带来的挑战
使用 ZeRO 优化器支持 Blockwise 的 FP8 训练主要面临两个挑战:
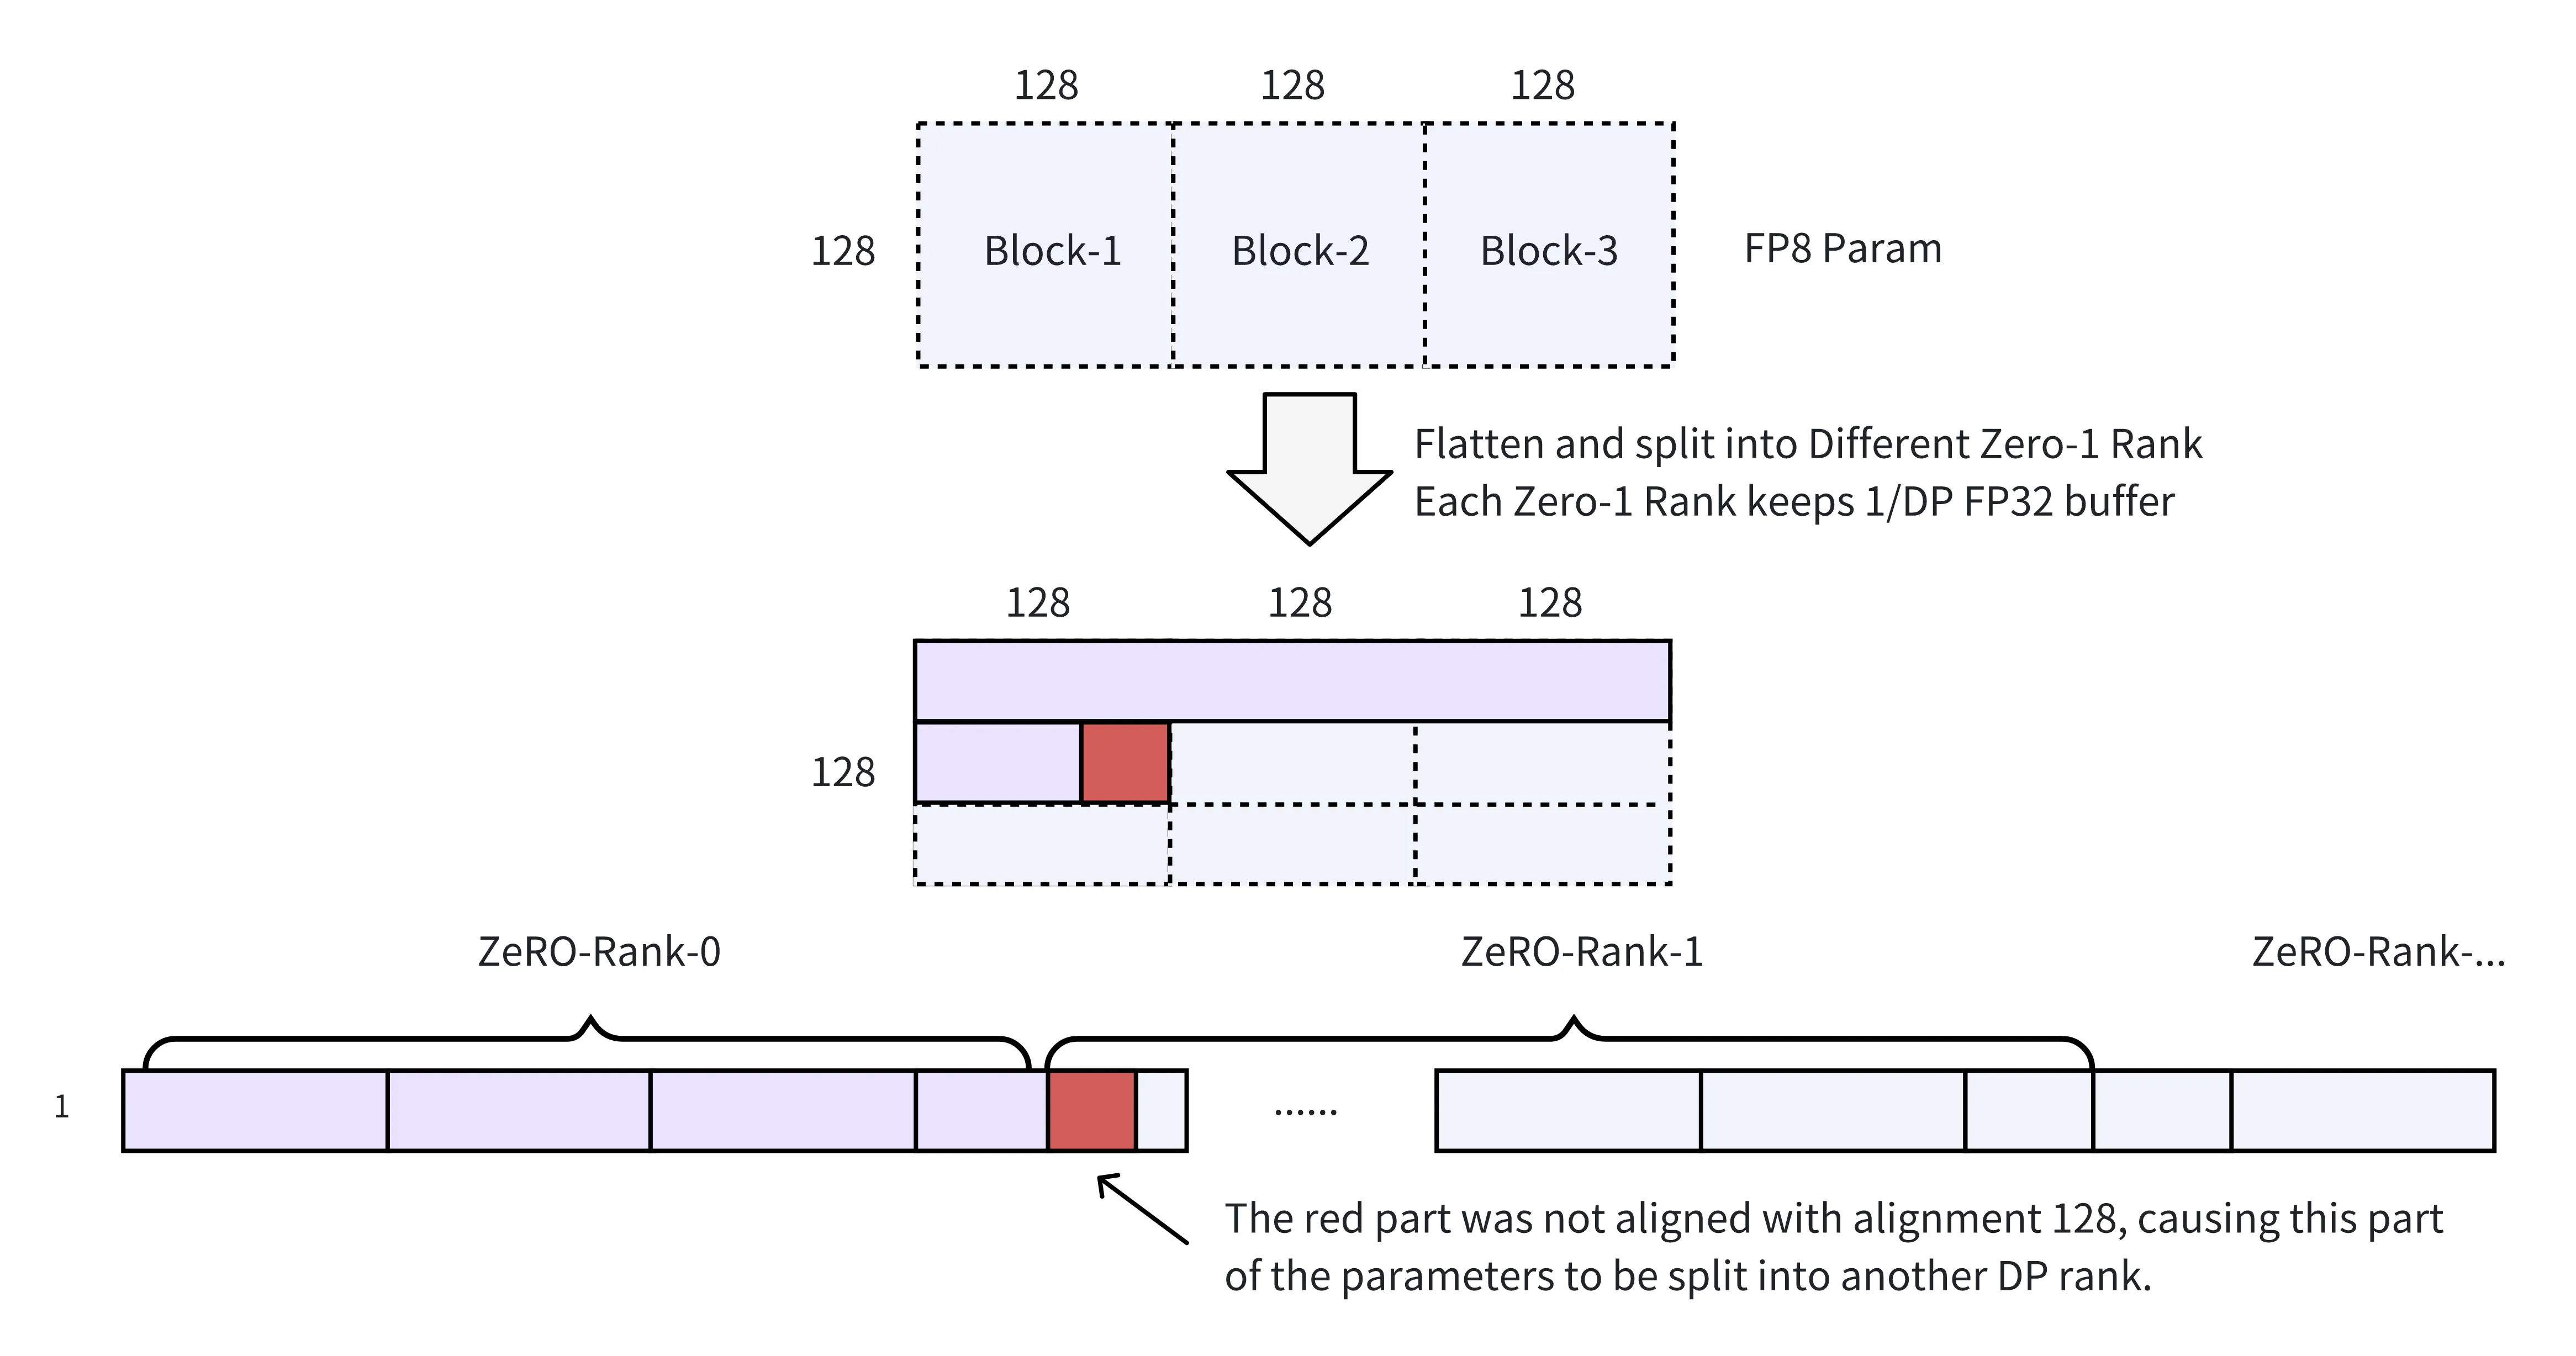
- 量化块被切分到不同的 DP rank 上:Blockwise 量化需要 2 维参数布局,而 ZeRO-1 优化器中,参数布局是 flatten 后的连续 1 维存储,并按照 DP size 均匀切分 flatten 后的参数。这可能导致一个 128×128 的块被切分到不同的 DP rank 上,导致在 FP8 参数更新时无法正确进行量化和反量化,如下图所示。
- 量化块不是内存连续的:每一个 128×128 的量化块分别在行和列的方向上进行量化,而这个 128×128 的 block 在存储上并不连续。如果直接将 FP8 参数 flatten 为 1 维存储会导致与 scale 值的映射错位。
这个问题在 Muon 优化器的 ZeRO 改造中也会遇到,本质上都是一维连续存储的模型状态丢失了参数的形状信息,导致优化器在更新参数时无法判断参数的边界位置。
在论文 FP8-LM: Training FP8 Large Language Models [5] 中,作者建议将优化器状态从均匀切分改为以完整 param 为粒度进行切分,从而使得不同的 DP rank 可以对完整的参数进行量化和反量化操作。在 TransformEngine 的 FP8 训练实现中,其利用了 Blackwell 架构原生支持的细粒度 FP8 类型(MXFP8)[6]。MXFP8 有一个非常优良的性质是量化 block 粒度(比如 32×32 或 128×128)是连续的,但 MXFP8 并不能在 DeepGeem + Hopper 架构的场景下使用。
解决方案
按块拆分的 ZeRO-1
为了解决挑战 1,我们按照参数粒度和块粒度分别设计并实现了两种不同切分粒度的 ZeRO 优化器。
参数粒度切分(Param-wise Split)
在分配 main_grad 和 main_param 时,提前对 FP8 参数根据参数大小进行排序,使用贪心算法将 FP8 参数尽量均匀地分配到 DP 个 bucket 中。然后以参数最多的 bucket 为基准,在实际为各个 bucket 分配存储空间时,将 bucket 起始偏移量和最大的 bucket 大小对齐,使得每个 bucket 的大小 + padding = 元素数量最多的 bucket 大小。
在 ZeRO-1 对 main_grad 和 main_param 进行切分(sharding)时,可以保证每个 DP rank 得到的 main_grad/DP 和 main_param/DP 中都是完整的 FP8 参数,如下图所示:
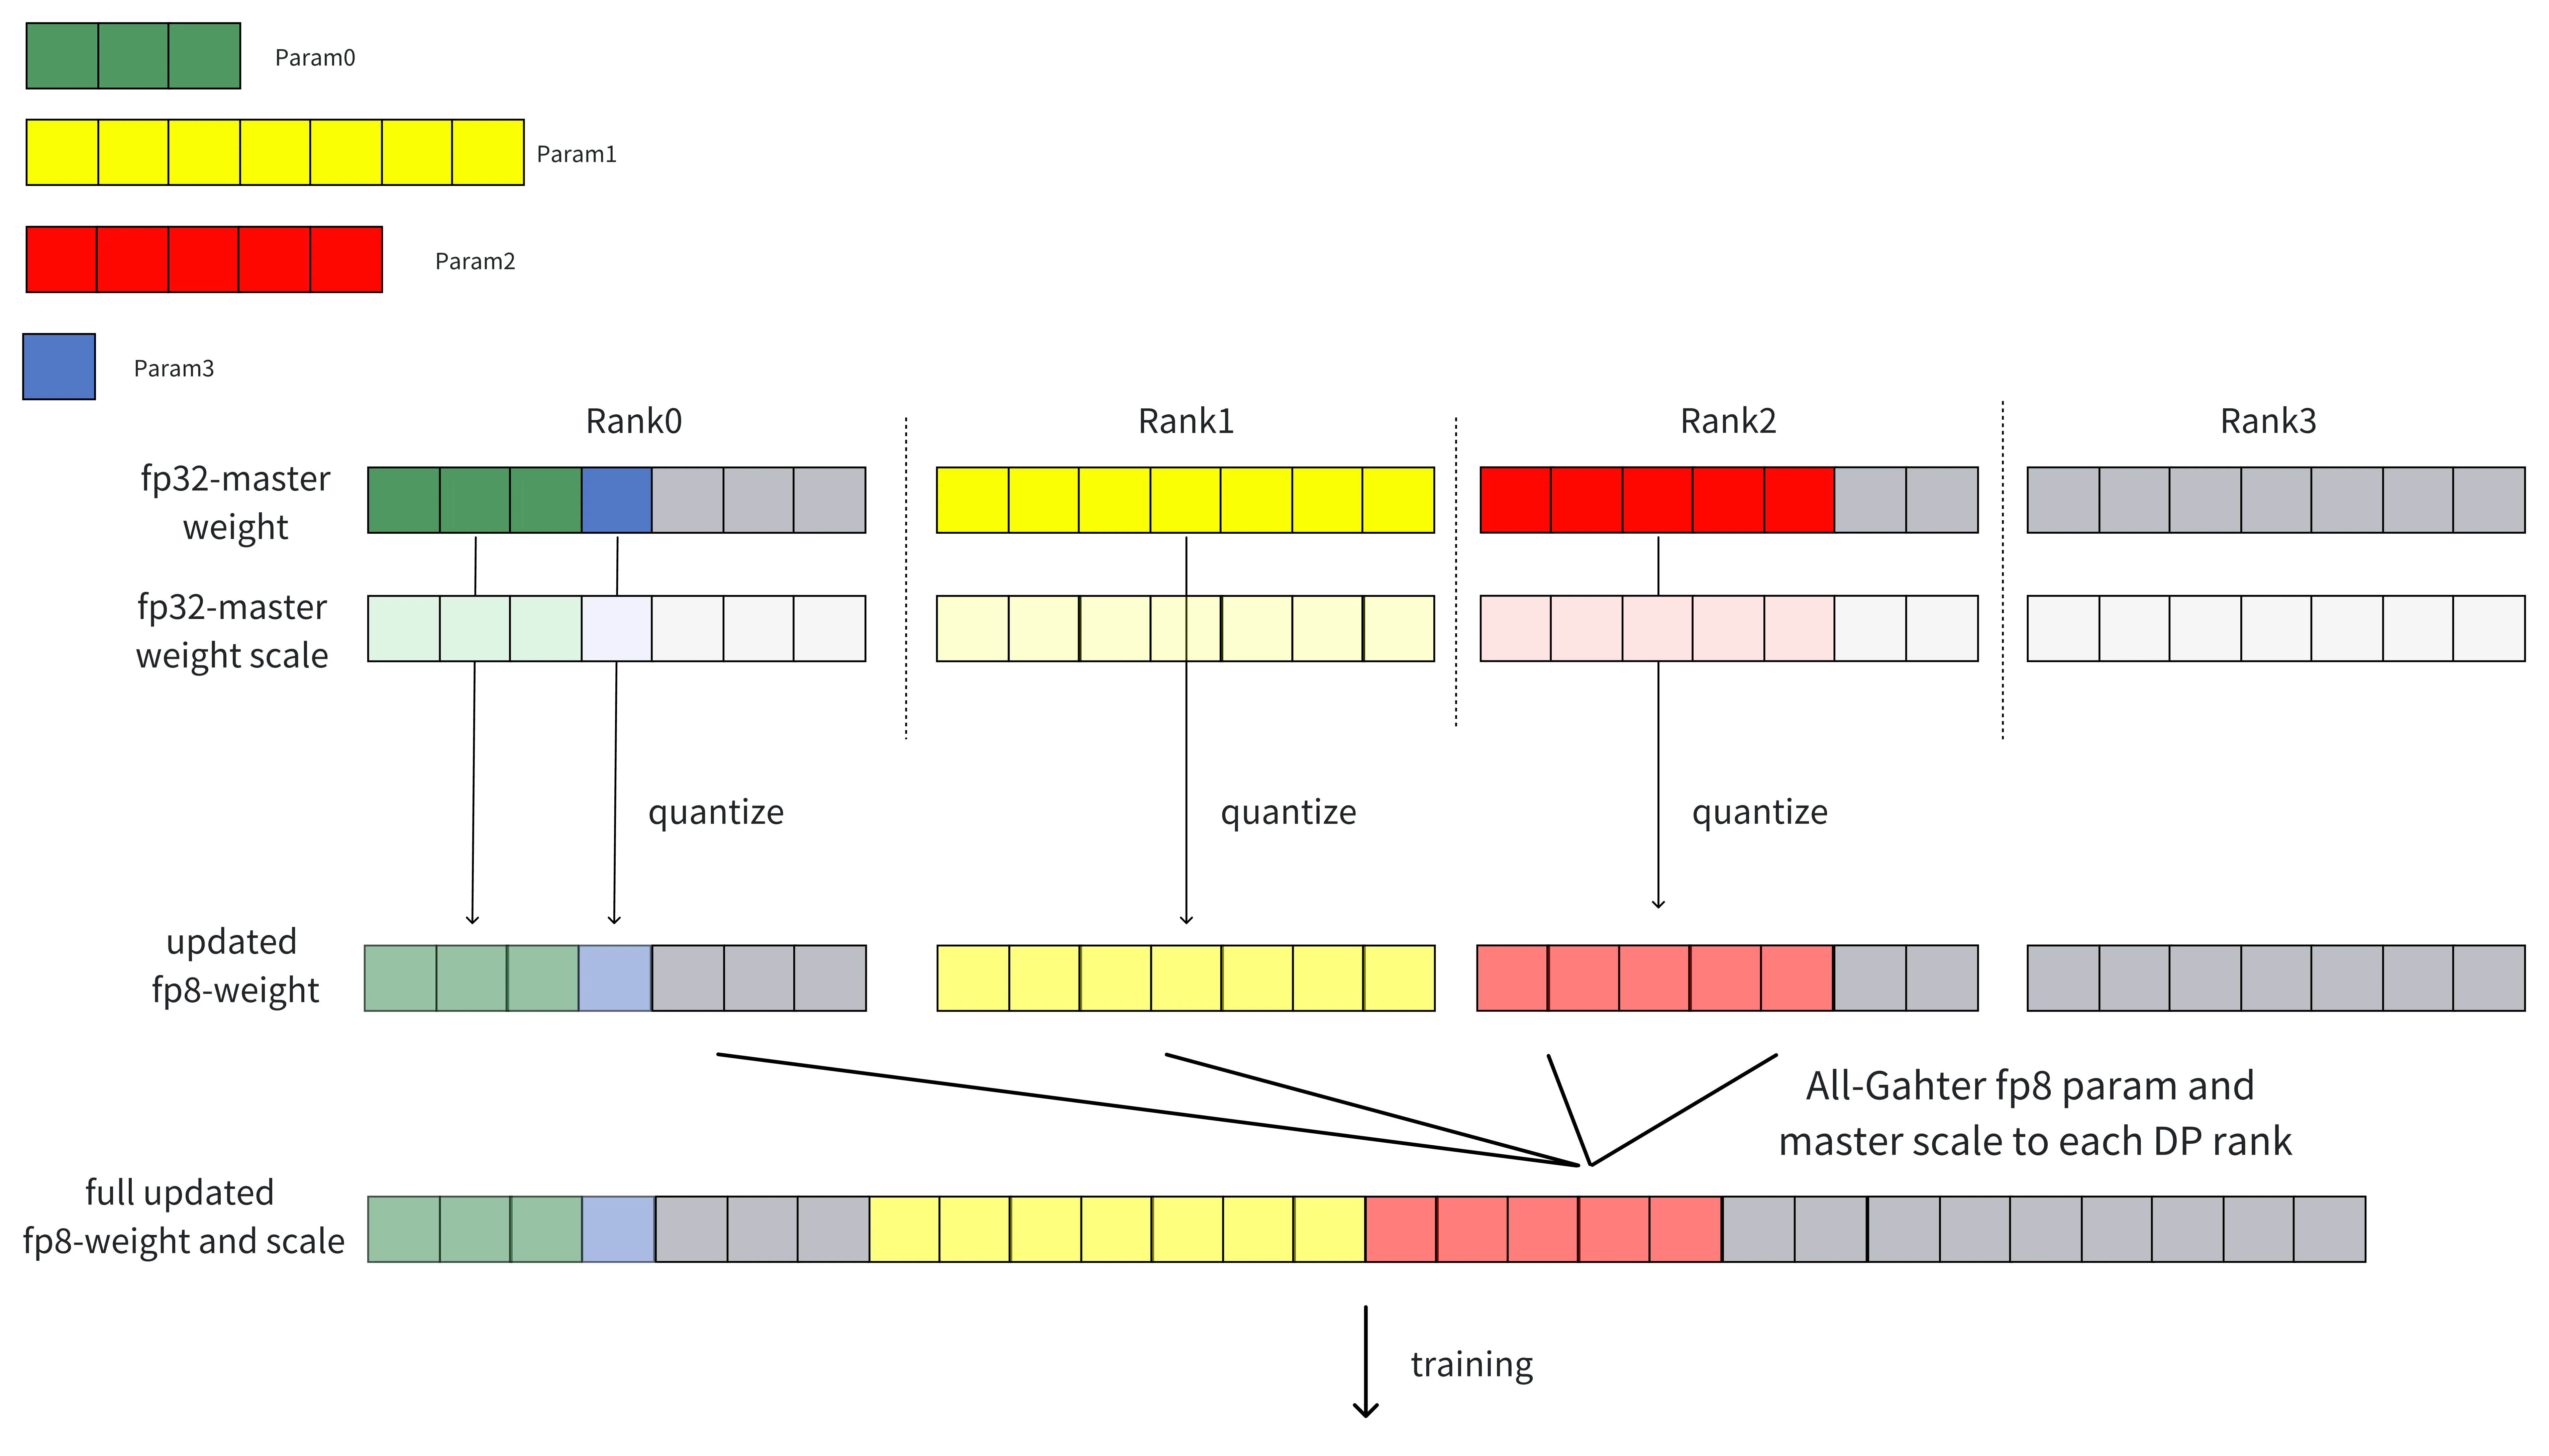
但是这种方案实现的 ZeRO 优化器缺点也比较明显:
- 会付出额外的 Padding 空间,造成显存浪费
- 如果参数数量不够多,会出现有些参数不够 DP size 切分的情况
在实际训练中,我们发现对于 MoE 模型,由于 MoE 参数和 Dense 参数需要使用不同并行配置的 ZeRO1 优化器更新参数,这种 Padding 浪费问题尤为严重。
块粒度切分(Block-wise Split)
为了解决上述 Param-wise ZeRO-1 优化器的缺点,需要进一步细化切分粒度。为此我们引入了额外的查找表,以 128×128 为对齐单位对参数进行切分,同时会对参数量化维度的 shape 进行 Padding,保证每一维是 128 的倍数。优化器需要记录下实际的参数数量和 Padding 长度,从而方便在一维数组存储上遍历参数。参数切分逻辑如下图所示:
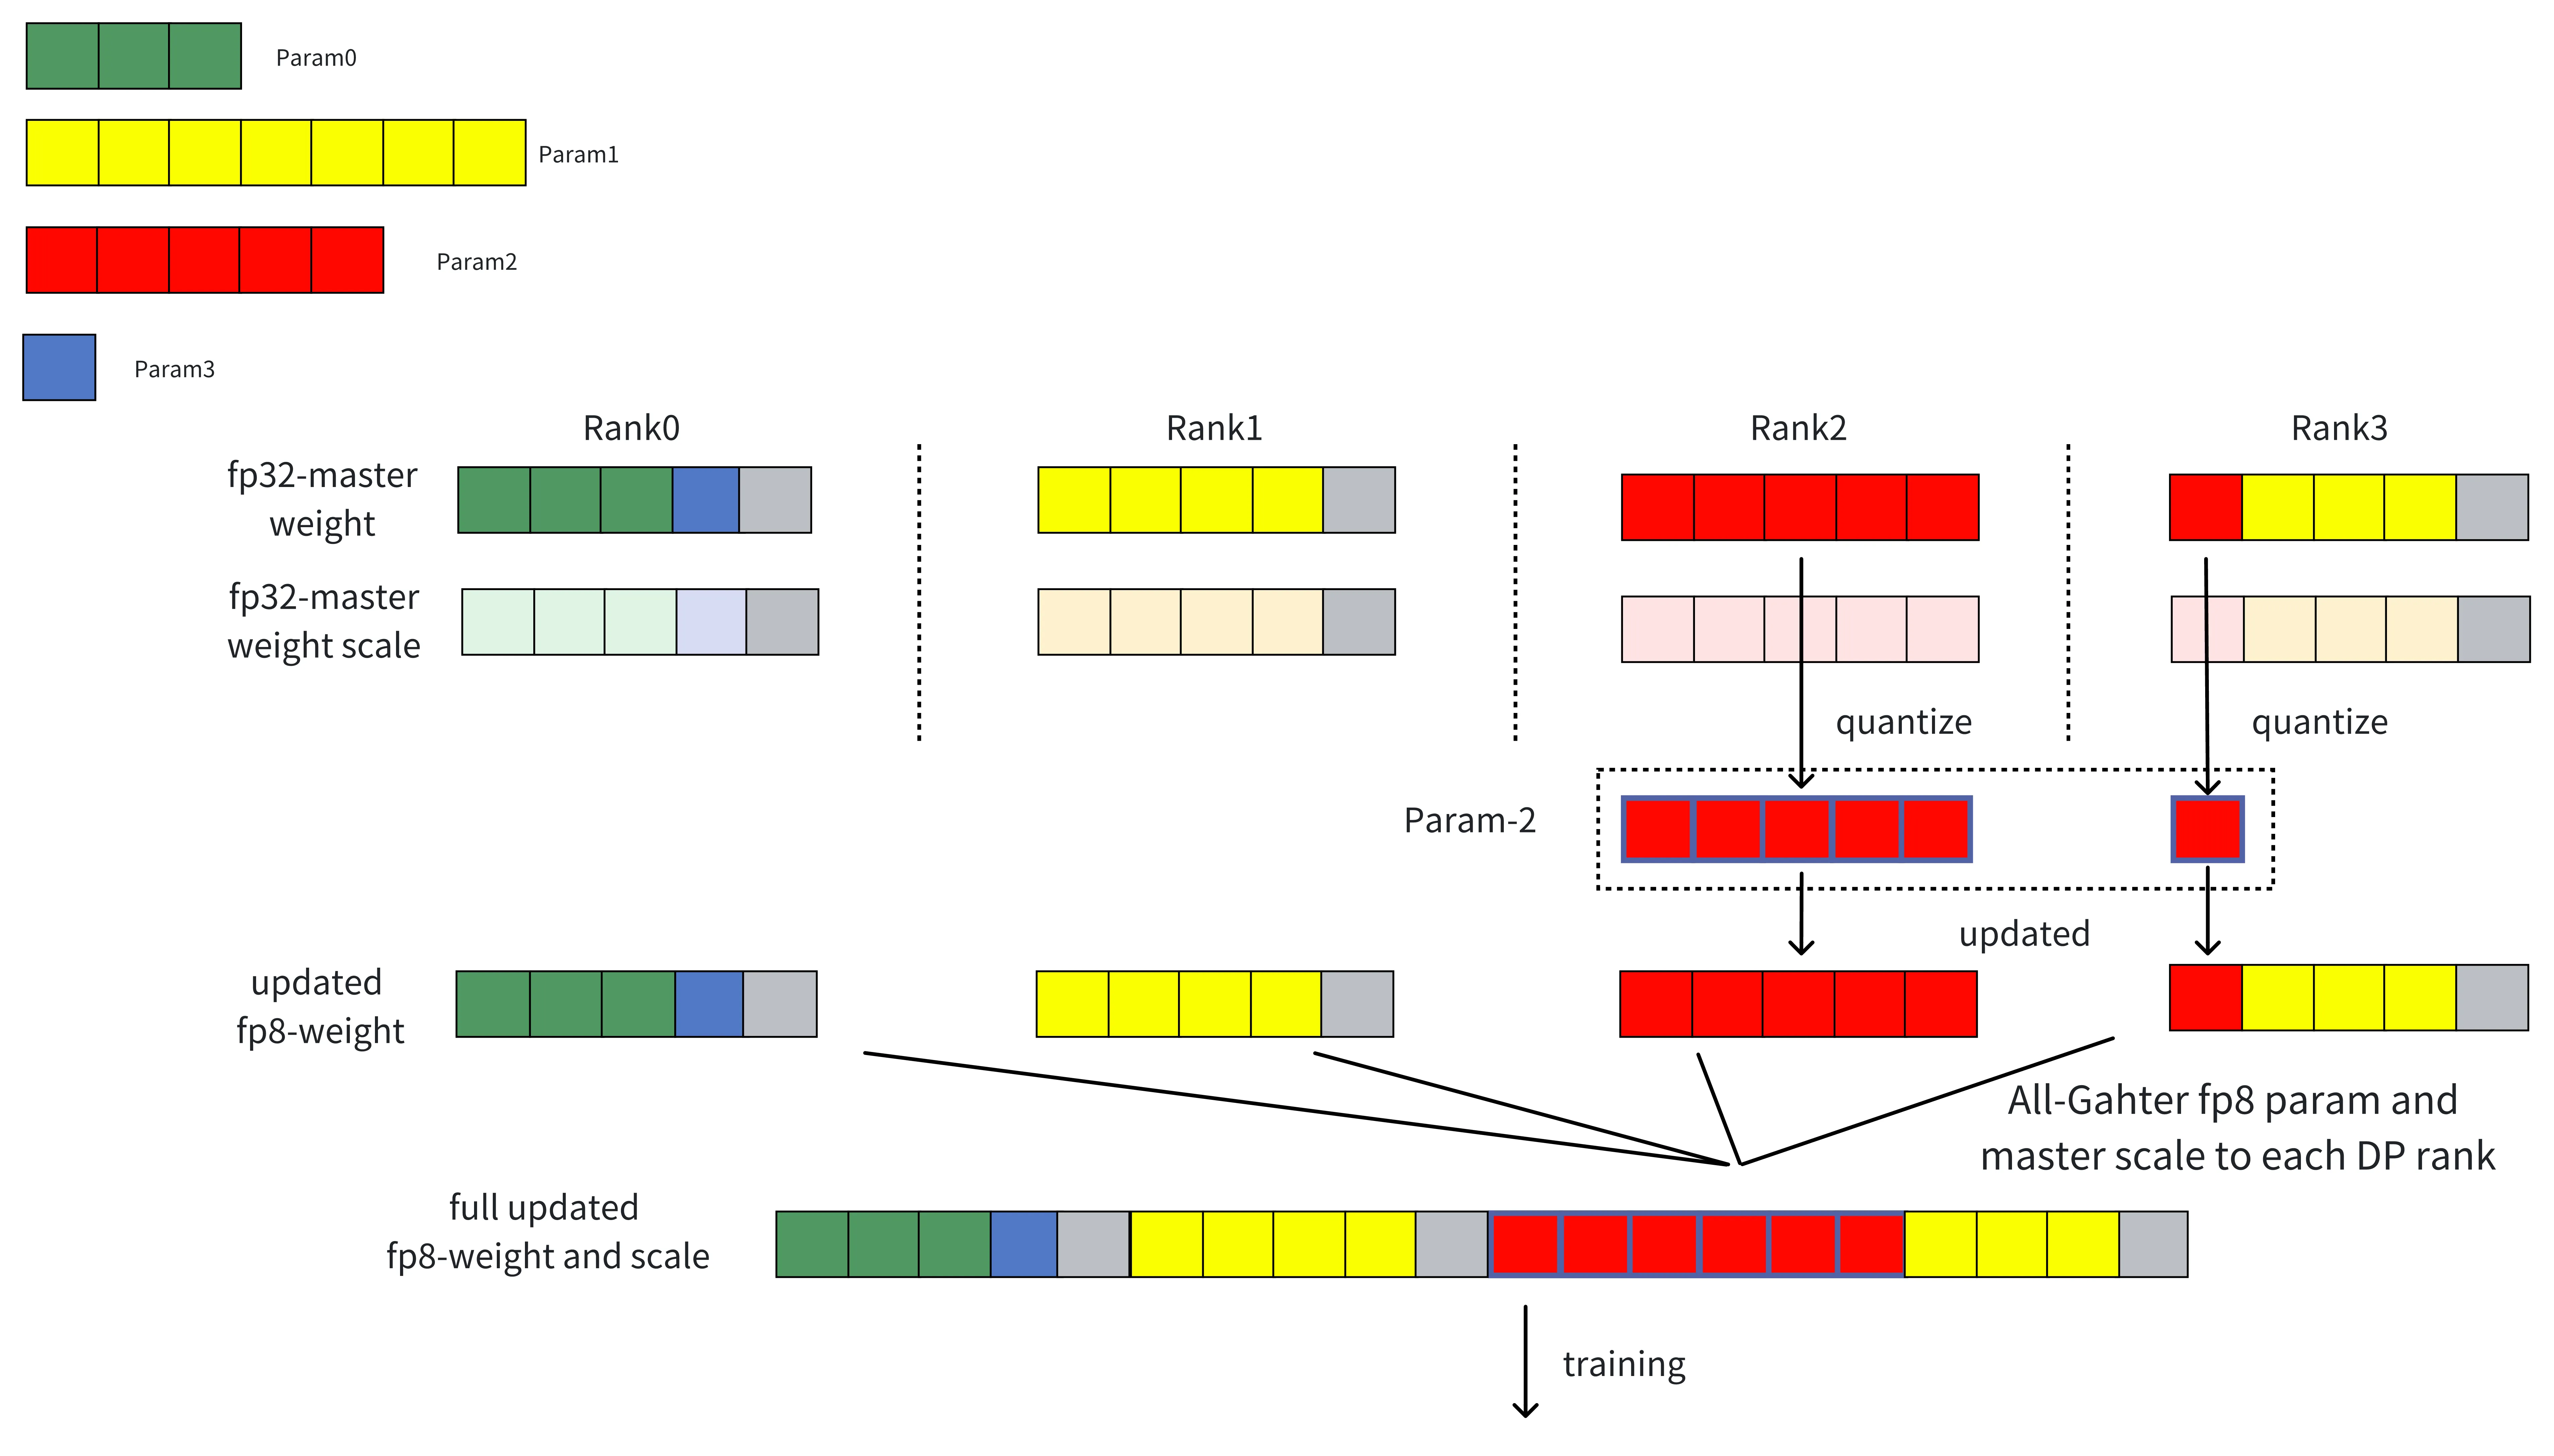
通过 Block-wise 的参数切分,我们最大程度地减少了冗余的存储和计算。同时 1 维连续 Buffer 也不会影响在 ZeRO 参数同步时的通信行为,使其可以通过一次集合通信即可完成对所有 FP8 参数的同步(对于 FP8 训练来说,还需要一次额外的集合通信同步 Scale 系数,不过其通信量要远小于参数同步)。
参数布局变换
上文提到过,由于在我们场景下Blockwise量化的128*128的单元并不是连续的,为了能够使得优化器可以在一维buffer上高效更新参数,且可以支持Blockwise的优化器状态切分,我们引入了名为fold/unfold的互逆的布局变化操作。具体来说,fold操作会将行主序存储的参数权重,将其转换为128*128的单元块为粒度连续排列的格式。从而可以直接让ZeRO-1优化器按照128*128的块粒度对优化器状态进行切分,fold操作的伪代码如下所示:
# 这里假设参数为3维,第一维为专家数量
weight_blockwise = (
   weight.view(
      weight.shape[0], weight.shape[1]//128, 128, weight.shape[2]//128, 128
   )
   .permute(0, 1, 3, 2, 4)
   .contiguous()
   .view(-1, 128, 128)
)
unfold操作是fold操作的逆变换,将以128*128为连续单元排列的参数恢复为原始参数权重的存储排布:
# 这里假设参数为3维,第一维为专家数量
weight_unfold = (
   weight_blockwise.view(batch_size, height_blocks, width_blocks, 128, 128)
   .permute(0, 1, 3, 2, 4)
   .contiguous()
   .view(batch_size, height, width)
)
在训练中,我们会在训练开始前的初始化阶段将 Main Param Buffer 执行 Fold 操作,再进行 ZeRO 优化器的切分。为了保证参数更新时梯度与 Main Param Buffer 对齐,在梯度 Reduce 完成之后,我们会对梯度同样执行 Fold 操作。在优化器更新完参数之后,最后再调用 UnFold 操作将 Param 复原为原始的内存布局。
总结
在原有混合精度ZeRO训练的参数更新流程之上,加粗部分为支持Blockwise量化我们新增的操作步骤:
- (初始化)将 2-D/3-D 参数 fold 为 1-D 的 Master Param Buffer
- (初始化)执行按照 Blockwise 对齐的 ZeRO 切分
- bwd 完成
- 在每个 DP rank 上对梯度调用 reduce-scatter
- 每个 DP rank 现在有 4 个被 reduced 的梯度元素(这里我们使用FP32精度对梯度进行累加)
- 对 Main Grad Buffer 中的梯度执行 Fold 操作,使梯度的布局与优化器保持一致
- 每个 DP rank 使用 slice 操作获得自己负责更新的 4 个 FP32 梯度元素
- 优化器执行参数更新(elementwise操作)
- 每个 DP rank 使用其 FP32 主参数来量化新的 FP8 参数和缩放系数
- 每个 DP rank 复制其 4 个 FP32 FP8 主参数元素
- 每个 DP rank 复制其负责的 4 个 FP32 主参数scale元素到 Whole Param buffer中
- 在每个 DP rank 上调用 all-gather 获得全部参数
- 每个 DP rank 复制参数对应的scale元素到 Whole Scale buffer中
- 在每个 DP rank 上调用 all-gather 获得全部缩放系数
- Whole Param/Scale buffer现在包含所有 16 个完全更新的元素及其对应的scale
- 将 1-D 的 Blockwise 参数 Unfold 为原始 2-D & 3-D 形状的参数
- 将 1-D 的 Blockwise Scale Unfold 为原始 2-D & 3-D Scale
- 进入下一轮 fwd
实验
精度对齐
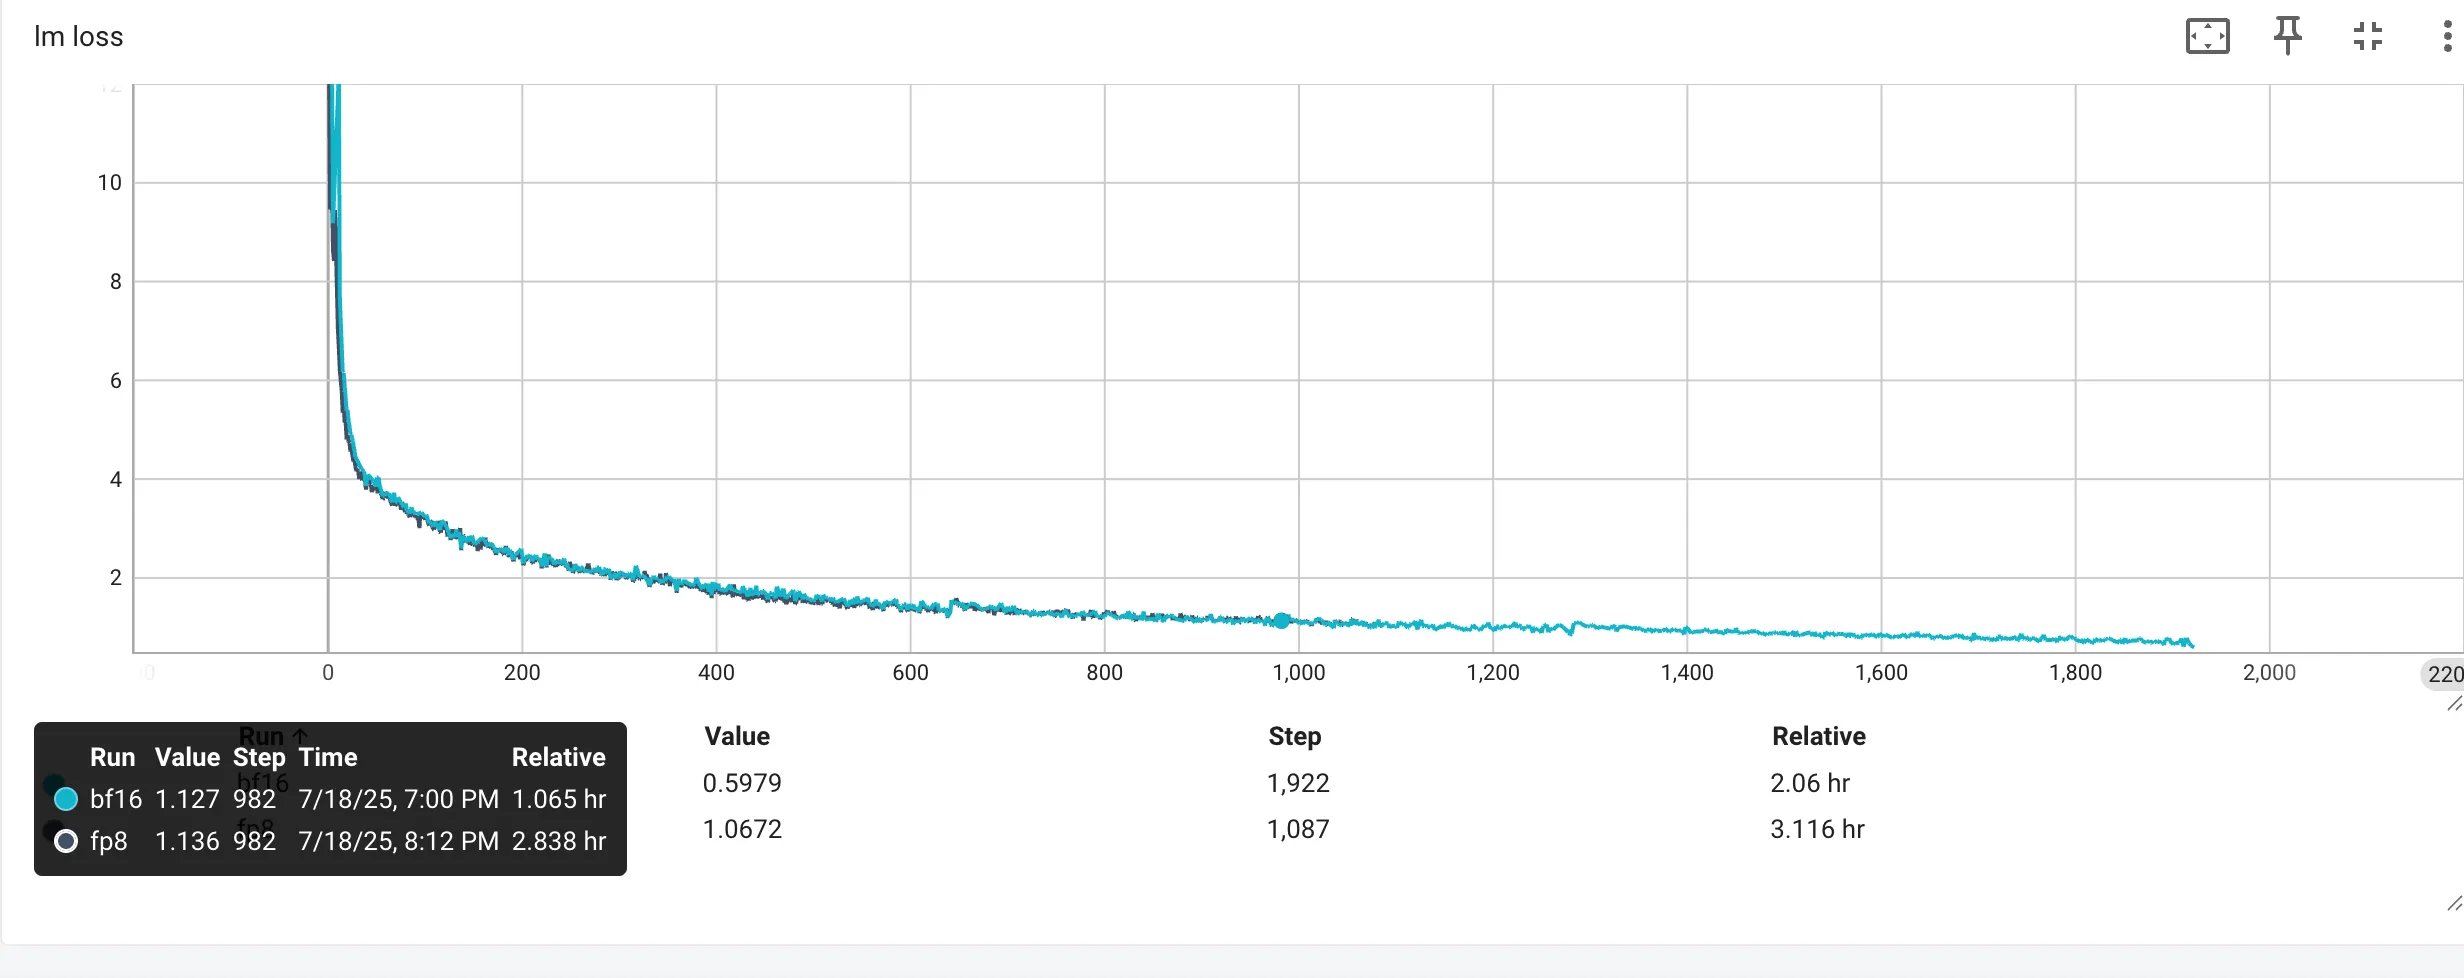
我们在 Moonlight 模型上进行了 Pretrain 和 SFT 实验,结果表明 Blockwise Splited ZeRO 优化器的精度可以与 BF16 训练严格对齐:
性能实验
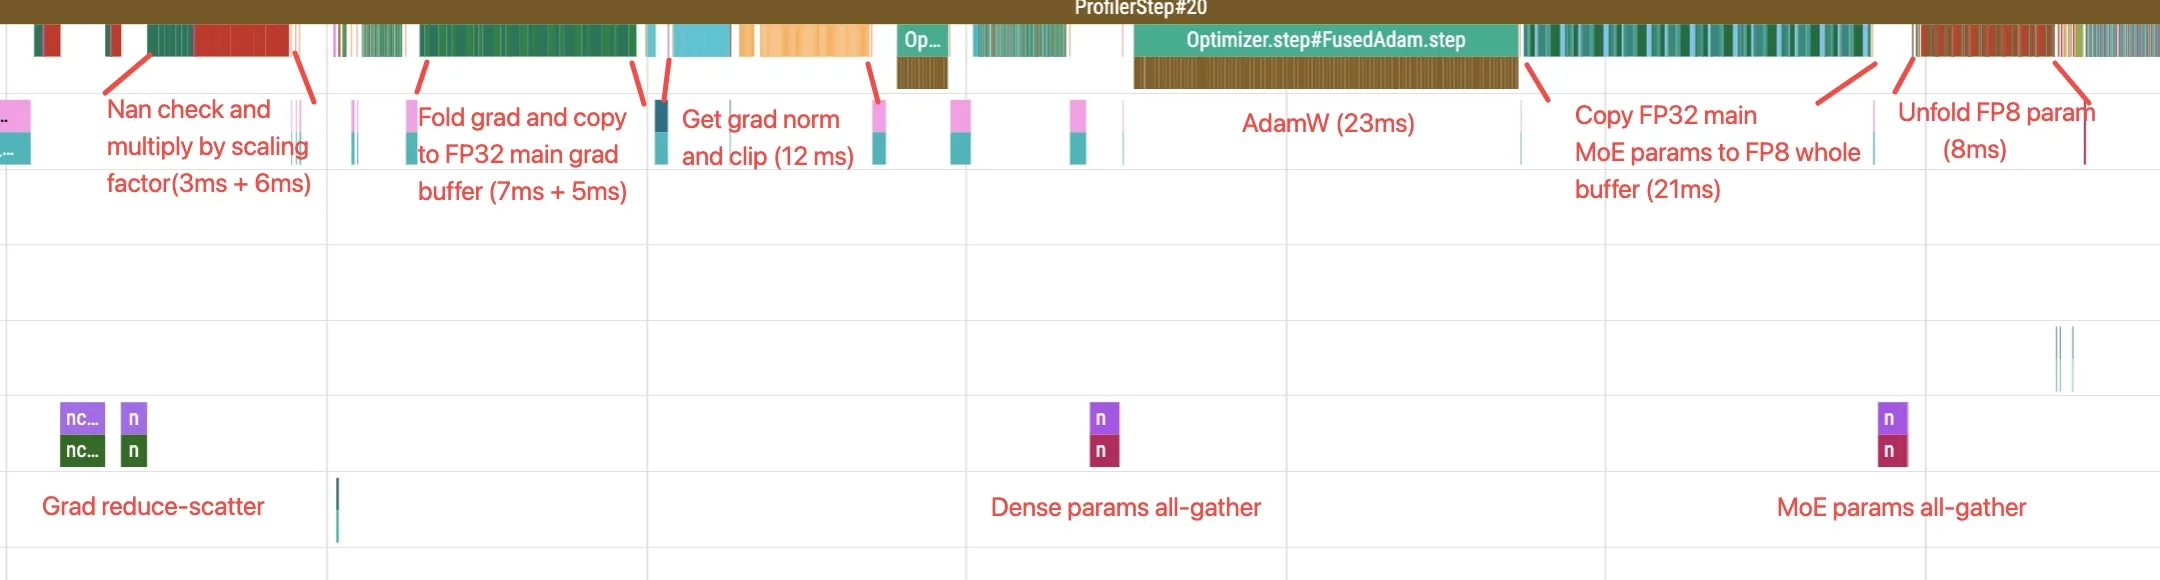
我们在 DeepSeek-v3 (pp8-ep32-dp2) 的试验下测试了 Blockwise Splited ZeRO 优化器各阶段的性能,其引入的额外开销主要为对Grad和Param的 Fold 和 Unfold 操作(包含量化开销), 其引入的额外开销综合大约为 20ms, 与一次优化器更新的总耗时 127ms 相比,仅增加约 15% 的耗时。
参考
@misc{2025-fp8-zero1,
  title   = {A ZeRO Optimizer Design for Blockwise FP8 Quantization},
  author  = {Guoteng Wang in collaboration with others at Dawning Road},
  year    = {2025},
  url     = {/blog/fp8-zero1/},
  note    = {Blog post},
  urldate = {2026-10-24},
}