智能体运行框架工程:让 Harness 自动优化
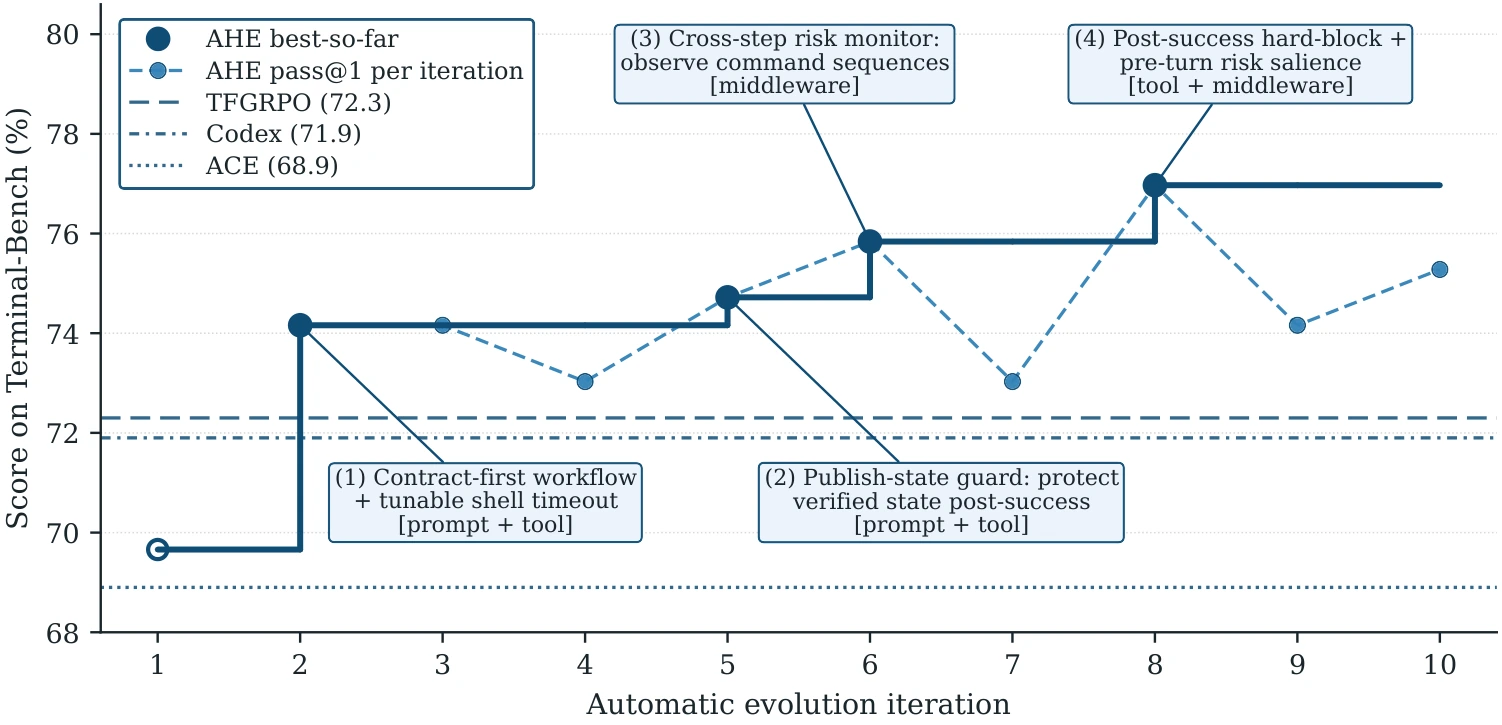
tldr: 我们开源了一套面向 coding agent 的 harness 自动优化方法 AHE(Agentic Harness Engineering)。不改变 model,在 Terminal-bench 2 上,让 coding agent 的分数从 69.7 迭代到 77.0。自动迭代得到的 harness 展现出良好的模型间泛化(5.1pp - 10.1pp)以及任务间泛化,避免 overfit 评测集。
2026 年以来,得益于 OpenAI,Anthropic,LangChain 等一系列 blog 的发布以及 OpenClaw、Hermes Agent 的火爆出圈,Harness Engineering 在大模型领域变得炙手可热。社区正在形成共识:模型的能力以及能动性的释放,需要通过 harness 来辅助、增益,我们需要一套完善的 harness engineering 方法论来实现这一目标。
每个模型都有其“舒适”的 harness 设计,才能最大化模型能力的发挥。与此同时,model 本身更新换代速度飞快,高效、稳定地开发 harness 是我们的首要目标,而人工进行敏捷开发跟不上模型进化速度。在 harness engineering 这件事上,社区已经探索了不少方向,得到了一定实践经验,但都没有系统性地回答:在 harness engineering 的迭代过程中,哪些部分可以被自动化?如何让 harness 从经验中学习,以更加稳定、高效完成任务?
Jiahang Lin、我和 Chengjun Pan 在公司探索了近半年,烧了数十亿 tokens,想找到最佳实践。以下是我们的探索和总结。
Takeaway
- harness engineering 目的是为了打通双向 context flow
- 观测体系是核心,包括组件观测(nexau)、经验观测(agent debugger)、决策观测(evidence)
- 全观测的自主搜索可以得到超越人类设计的 harness,更少的人类先验,更多的自主搜索
智能体运行框架工程的三个视角
如何优化 harness?我们从三个视角来审视这个问题。
作为封装层的运行框架
在长程的编程任务中,很少会有人直接让裸模型运行,而是会给它配一系列“外挂”,最早是 API tool,然后是 MCP、skill、sandbox。与这些配件的持续交互,是模型与外界交互必由的媒介。而配件的数量、形态逐渐膨胀,成为一个庞然大物,变得无法忽视。
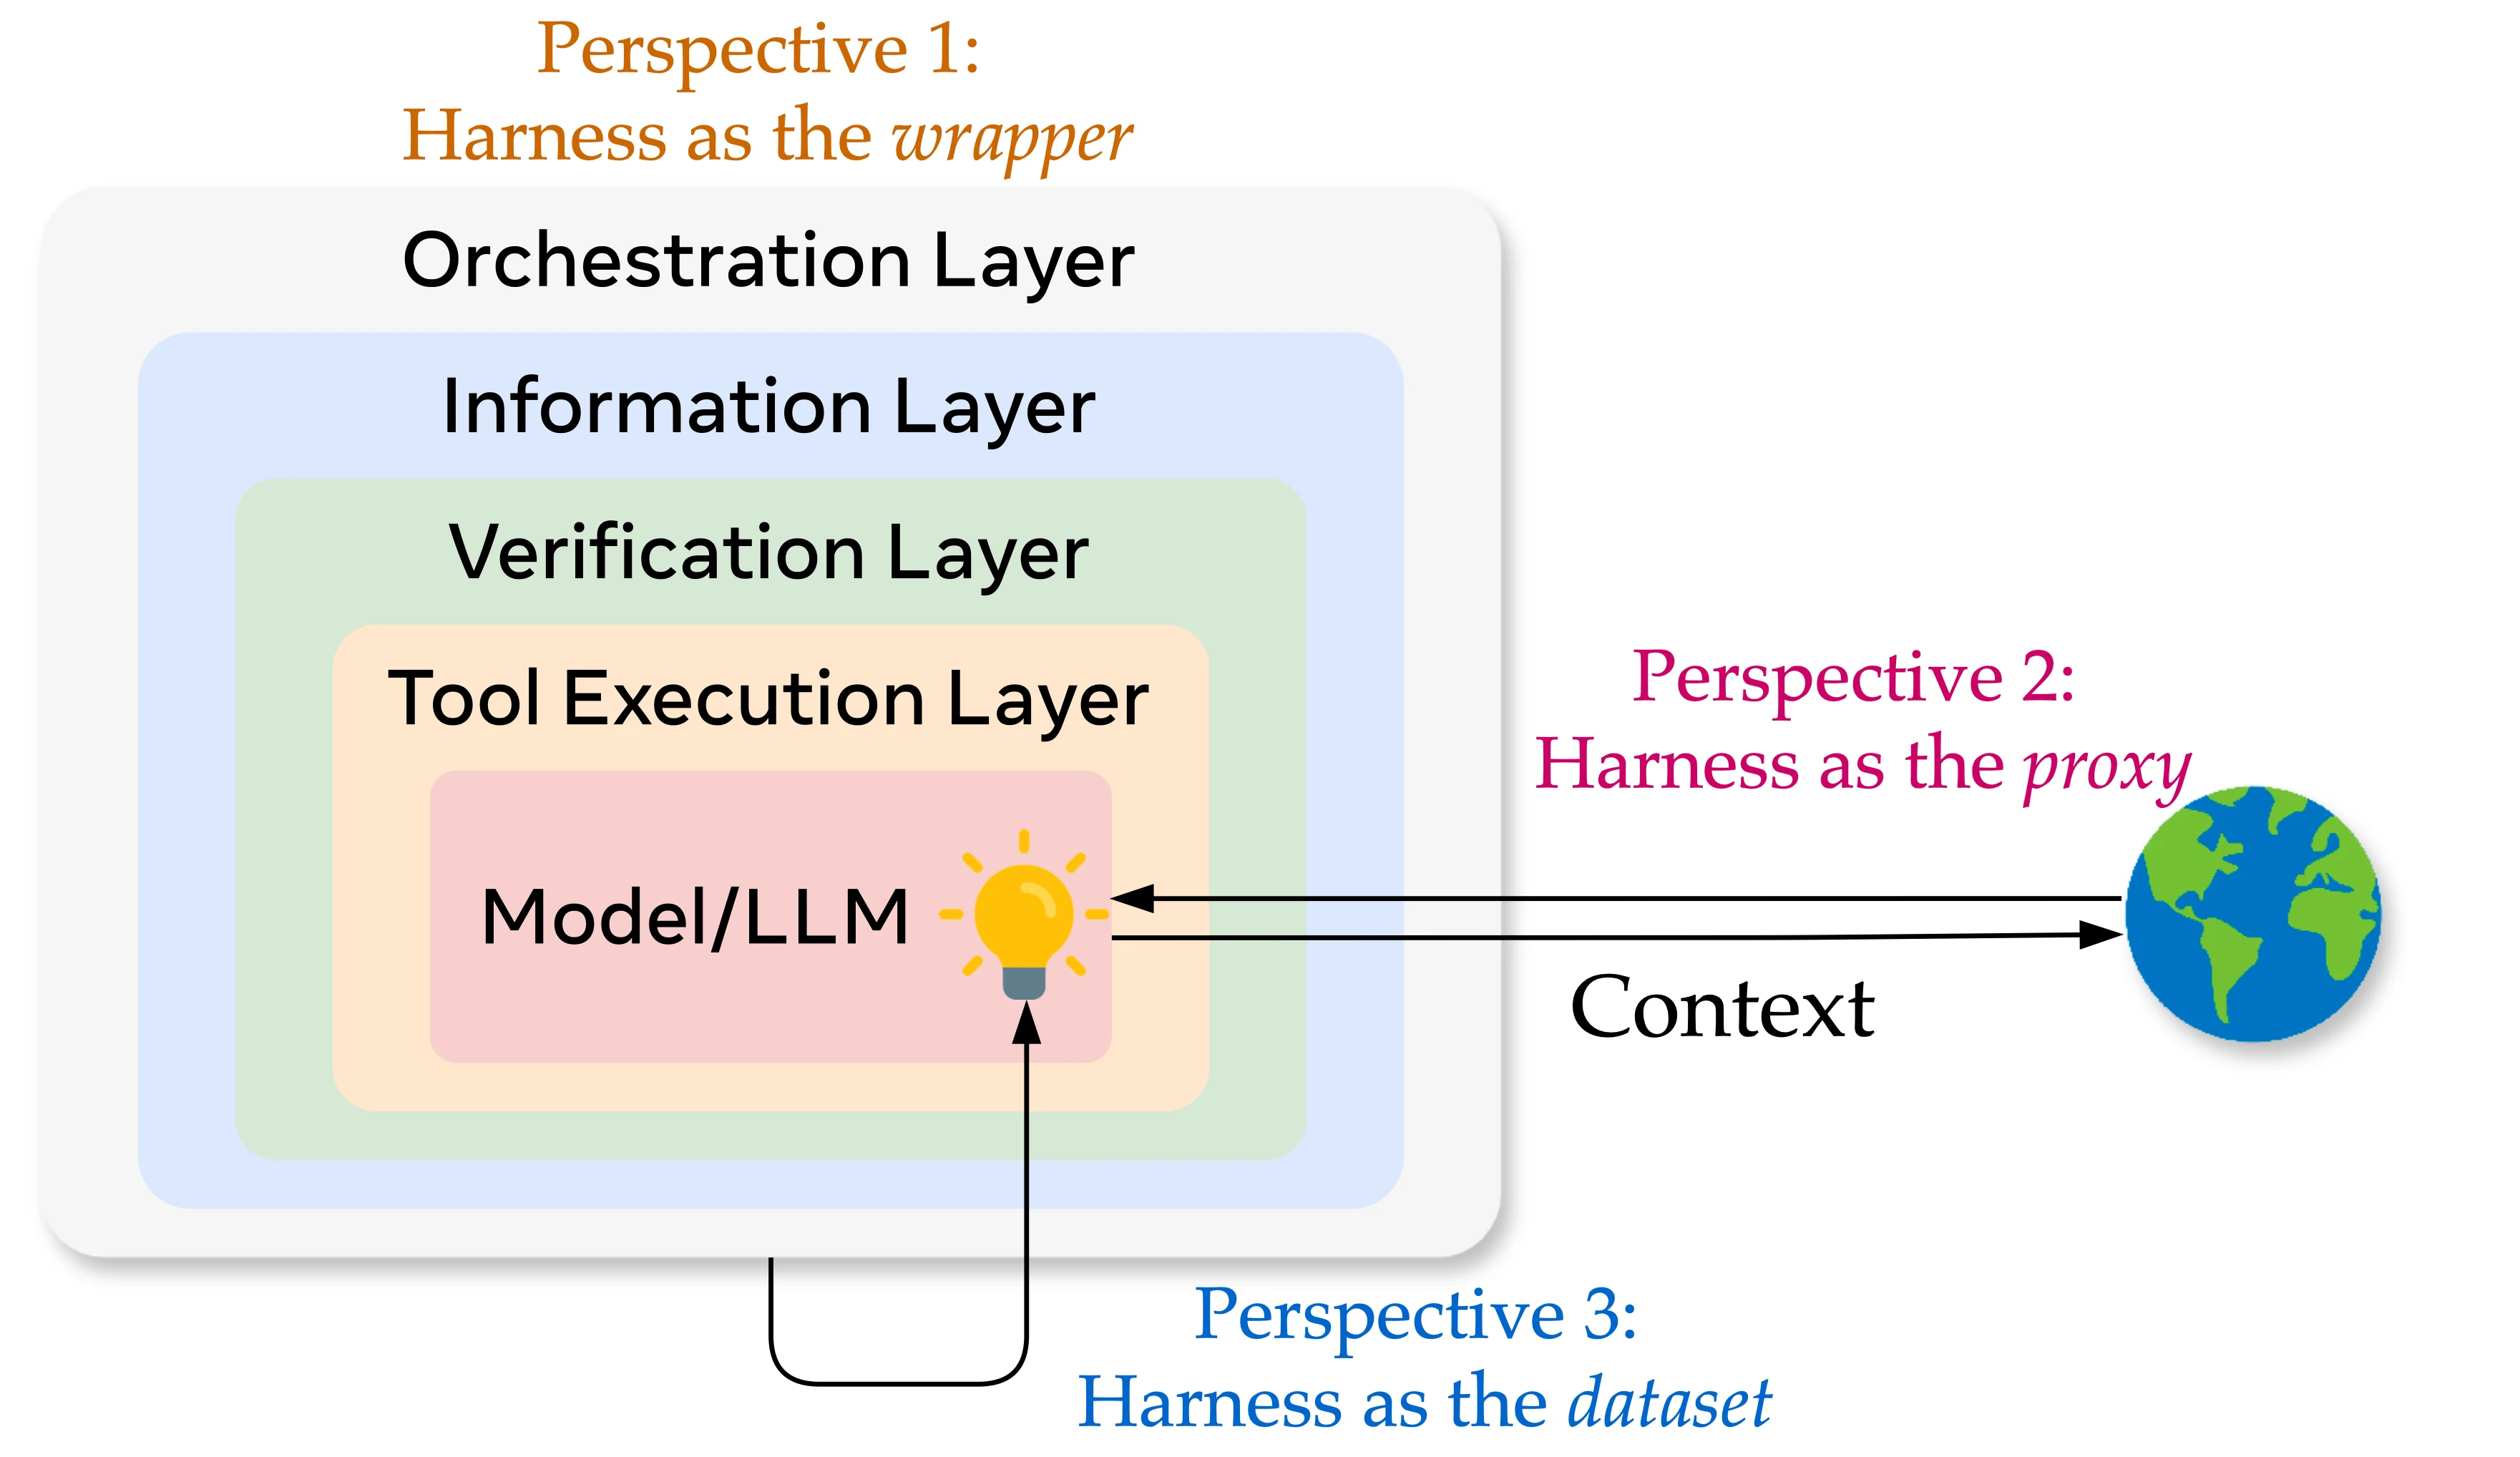
what's harness? 从形态上看,harness 代表了从 model 到 agent、agentic system 的结构性增量,模型和 harness 共同构成一个主体和环境进行交互。model 给出 next-token 的条件分布,是信息的压缩、智能发生、不确定性的来源;harness 是包裹在外的一切确定性代码:system prompt、工具定义与实现、middleware 钩子、skill 文档、sub-agent 编排、长期记忆、日志与观测。它们共同负责工具调用、上下文获取、沙盒隔离、逻辑编排、反馈反思。当一个 agent 想要稳定地长程运行、反思迭代,这些组件不可或缺。
进一步拆分,harness 可以划分为信息层(memory、context 管理、tools、skills)、执行层(orchestration、sandbox、guardrails)、反馈层(evaluation、tracing、observability),分别对应 agent 运行的三个阶段。每一层有自己的工程原则:信息层追求信息的精准性,包括渐进式披露、提升 context 利用率;执行层任务编排和管理,按照任务的阶段划分 session,避免 context 污染;反馈层来完成 grounding,实现反馈闭环,让模型能不犯第二次错误。社区已经形成了不少各个层的方法论。
作为代理层的运行框架
基于这些组件,优化的方向是什么?从目的上看,harness 的职能是在 model 和 environment 之间管理一条双向的上下文流:一侧在合适的时机把任务、用户意图、环境状态、外部信息传进 model,另一侧把 model 的动作忠实地记录、校验后交回环境执行。
在这一点上,Anthropic 在博客中如是说:“Good context engineering means finding the smallest possible set of high-signal tokens that maximize the likelihood of some desired outcome.”;"Thoughtful context engineering is essential for building capable agents." 过去,开发者需要手动喂 prompt、复制 terminal 输出、复制外部文档内容给 model,上下文分布在互不相通的空间里,人类依据直觉和观察来决定 context 的构成。
因此,Harness 的设计目标之一,就是让 context 的流动可以更加精准、更加自主。向 model 流入的一侧,harness 是用户的代理:它以 system prompt、memory、skill、sub-agent 编排逻辑的形式沉淀用户的偏好、指令、惯例、领域知识、实证过的良好开发范式,这些是不同粒度的用户 context。从 model 流出的一侧,harness 是环境的代理:模型输出的 response 会通过 harness 进行解析,并可能提前进行干预约束,如护栏 middleware 校验模型做出的 action,相当于为环境建模,把 env context 翻译成约束代码,避免 model 陷入无效探索。
Harness 优化的方向,是让模型和环境之间那条 context 通道尽可能高带宽、低损耗、可审计。
作为数据集的运行框架
进一步地,我们应该如何优化 harness?
最直观的,就是优化各个组件代码,或者称之为 Agent Infra。开发者社区贡献了大量有用的 harness 组件,用于记忆、上下文管理、沙盒环境、轨迹管理,这依赖了大量扎实的工程开发与优化,让各个部分的独立地变得更加高效、安全、稳定。
而对于任意一个特定环境,我们想要找到最优的 harness,这就成为了一个 model x harness x env 的组合优化问题。我们不再能像开发单独组件那样有一个明确的规则,不再能利用人类开发者的先验知识一步到位找出最优组合,而是要开发、观测、迭代,根据模型的运行轨迹、评测分数这样或模糊或稀疏的信号,来反复调整各个组件之间的非线性组合。在新时代谁都没有对于 agent 拥有天才般的英雄主义式的直觉,model 能力变化太快,任务环境变化太快,而人工优化太慢。
人类的注意力是稀缺的,而硅基生命不知疲倦、无休无止。因此,必须让 agent 本身也参与到 harness 优化的过程中来。只要把优化目标、动作空间、状态空间都以一种 agent 可读的方式呈现,那么就可以引入一个 agent 进行自主优化。可以是 claude code,可以是 openclaw,whatever。只要我们把 harness 在 model 和 environment 之间传递 context 这个过程中的所有组件、所有步骤都透明化、可观测,那么一个持续进化的 harness就呼之欲出了!
This is what we’ve done。我们后面会详细铺开我们是如何做好可观测,构造声明式组件、渐进披露、分层分析、版本管理。
在此之前,如果还想把 harness 优化推向更深层,那便是 harness–model co-design,harness 和 model 的协同进化。Deepmind 的 Staff Engineer Philipp Schmid 所言:"The harness is the dataset. Competitive advantage is now the trajectories your harness captures." 这些轨迹都会训练进模型参数中,利用 SFT、RL 或 OPD。让 model 适应在 harness 提供的异构 context 中理解、执行,既需要掌握 context learning,又能实现工具内化,context 腐化更慢。
Lenny Rachitsky 在和 Cat Wu(Head of Product,Claude Code)的访谈中说到:“模型会把你的 harness 当早餐吃掉。”借海德格尔哲学来类比,当下 harness 里的组件对 model 而言是在手的(Vorhandenheit), 每一次使用都必须把工具 schema、调用约定、风险提示放进 context,model 需要意识到这件东西的存在;而当这些组件被训练进权重之后,它们转为上手的(Zuhandenheit), model 不再需要在 context 里看见它们,就像熟练的木匠不会意识到锤子的存在。Harness 会随时间收缩,只剩下真正无法内化的部分,到那时新的 harness 已经孕育而生了。
模型和 harness 会螺旋上升,互相迭代,这是 harness 演化的下一步方向,也会是我们后面工作的方向。本文聚焦当下在手状态的 harness 如何被高效地迭代和进化,迈出第一步。
注:stanford 的 meta-harness 也做了类似的工作,取得了优秀的效果。我们非常高兴有其他人关注到这个方向,欢迎各位读者对比阅读。
可观测体系 in Nex 生态
我们的出发点是:我们不手写一行代码、并不直接开发任何一个组件本身,而是搭建一套完善的平台,让一个 agent 能自动优化目标 coding agent 的 harness(在我们的语境下,优化和被优化的对象是不同的 agent,并不是 self-evolving)。那么,需要什么基础设施?
和所有软件开发过程类似,harness 的开发也分为几个阶段:编写组件、运行 agent、收集反馈。这个过程反复迭代,持续运行。如果要想让 agent 接手人类的工作,就需要在此过程中所产生的 context 都能被可观测,并且做好 context 结构化、层次化。我们并不限制 agent 的自主决策空间和指引,只依赖评测结果,以及更多分层信息来辅助它精准修改、准确归因。
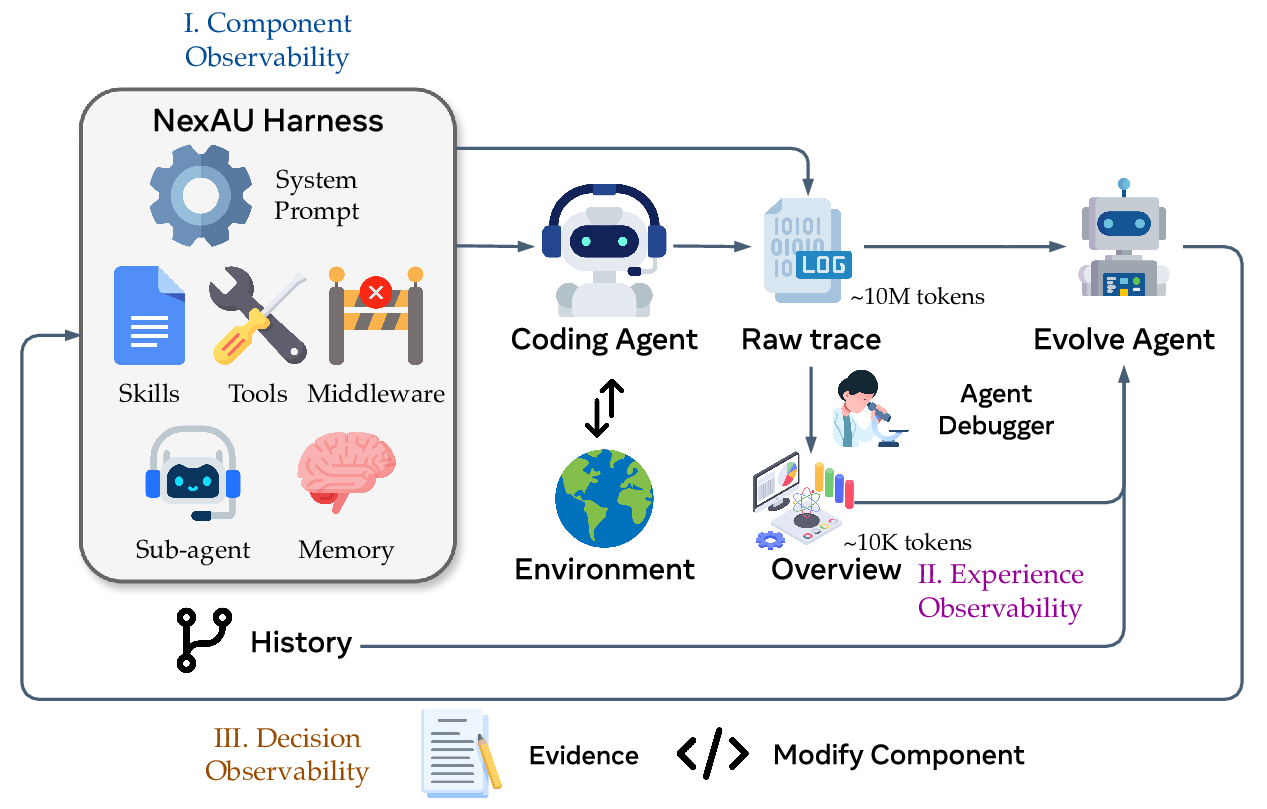
我们搭建了一套完善的观测平台,对全阶段做详细而精确的记录。分三部分:
- NexAU 提供各部分解耦的 harness,提供 harness 组件的可观测性;
- Agent Debugger 把 10M token 量级的 raw trace 提炼成分层的、可溯源的多维反馈意见,实现反馈结果的可观测性;
- Evolve Agent 基于 git 溯源的组件历史、反馈结果,构建证据驱动的完整修改链路,对相应组件进行修改,实现优化行为的可观测性。
NexAU:把 harness 解耦成可追溯的组件
我们基于 NexAU 框架设计我们的 coding agent。NexAU 的关键属性是把可修改组件都暴露为 workspace 目录里的显式文件。七类正交组件(system prompt、tool description、tool implementation、middleware、skill、sub-agent、long-term memory)各自有明确的文件格式和挂载点。它们之间在结构上解耦:加一个 middleware 不需要动 system prompt,加一个 skill 不需要动任何 tool 实现。
解耦让失败模式-单一组件的对应关系变得清晰,使得 Evolve Agent 有更明确的动作空间。workspace 利用 git 跟踪,每一条逻辑改动伴随一次 commit,提供了文件粒度的 diff 与可 revert 的历史,让 harness 演化的每一步都能被定位、审计、回退,也让对上一轮改动做事后判决变成一件机器可做的事。
被优化的 code agent 本身刻意从零先验的极简形态起步:只有一个 run_shell_command 工具,没有任何 middleware、skill、sub-agent。如果起点已经带了目标 benchmark 的先验,后续每一次新增的组件、每一次改写的 prompt 都会被污染,无法干净地归因到它自己带来的收益或回归。我们不希望迭代出的 harness 只能用于刷榜,overfit 到特定 benchmark,而是要有一定泛化性。
Agent Debugger:把 trace 变成可消费的资产
一次 rollout 的原始 trace 可以到数十万 token,包含每一次 LLM 调用、每一次 tool call、每一次 middleware hook、每一次 sub-agent 以及评测结果。一轮评测常常包括数百条 trace,如果把这些原封不动扔给 Evolver,它的上下文预算全花在读 trace 上,改代码的空间所剩无几。raw trace 本身并不是高价值资产。
Agent Debugger 在 raw trace 之上构造了一条分层提炼流水线:底层忠实记录所有轨迹(~10M tokens);cleaner 重复工具输出;上层 QA sub-agent 对每道题的 k 条 rollout 按 pass/fail 分布切换提问模板,如全失败问根本原因、bias,全通过问成功策略、可复用模式、潜在脆弱性。最后所有任务聚合成一份 overview(~10K tokens),提供给 Evolve Agent 消费。
分层不仅是压缩信息,本质上是渐进式披露。Evolver 默认先读 overview,也可以访问特点任务的具体分析,甚至回到 raw trace 核实结论是否可信,让 10M 级别的轨迹数据变成可并发、可消费、可审计的观测资产。
Evolve Agent:证据驱动的组件修改
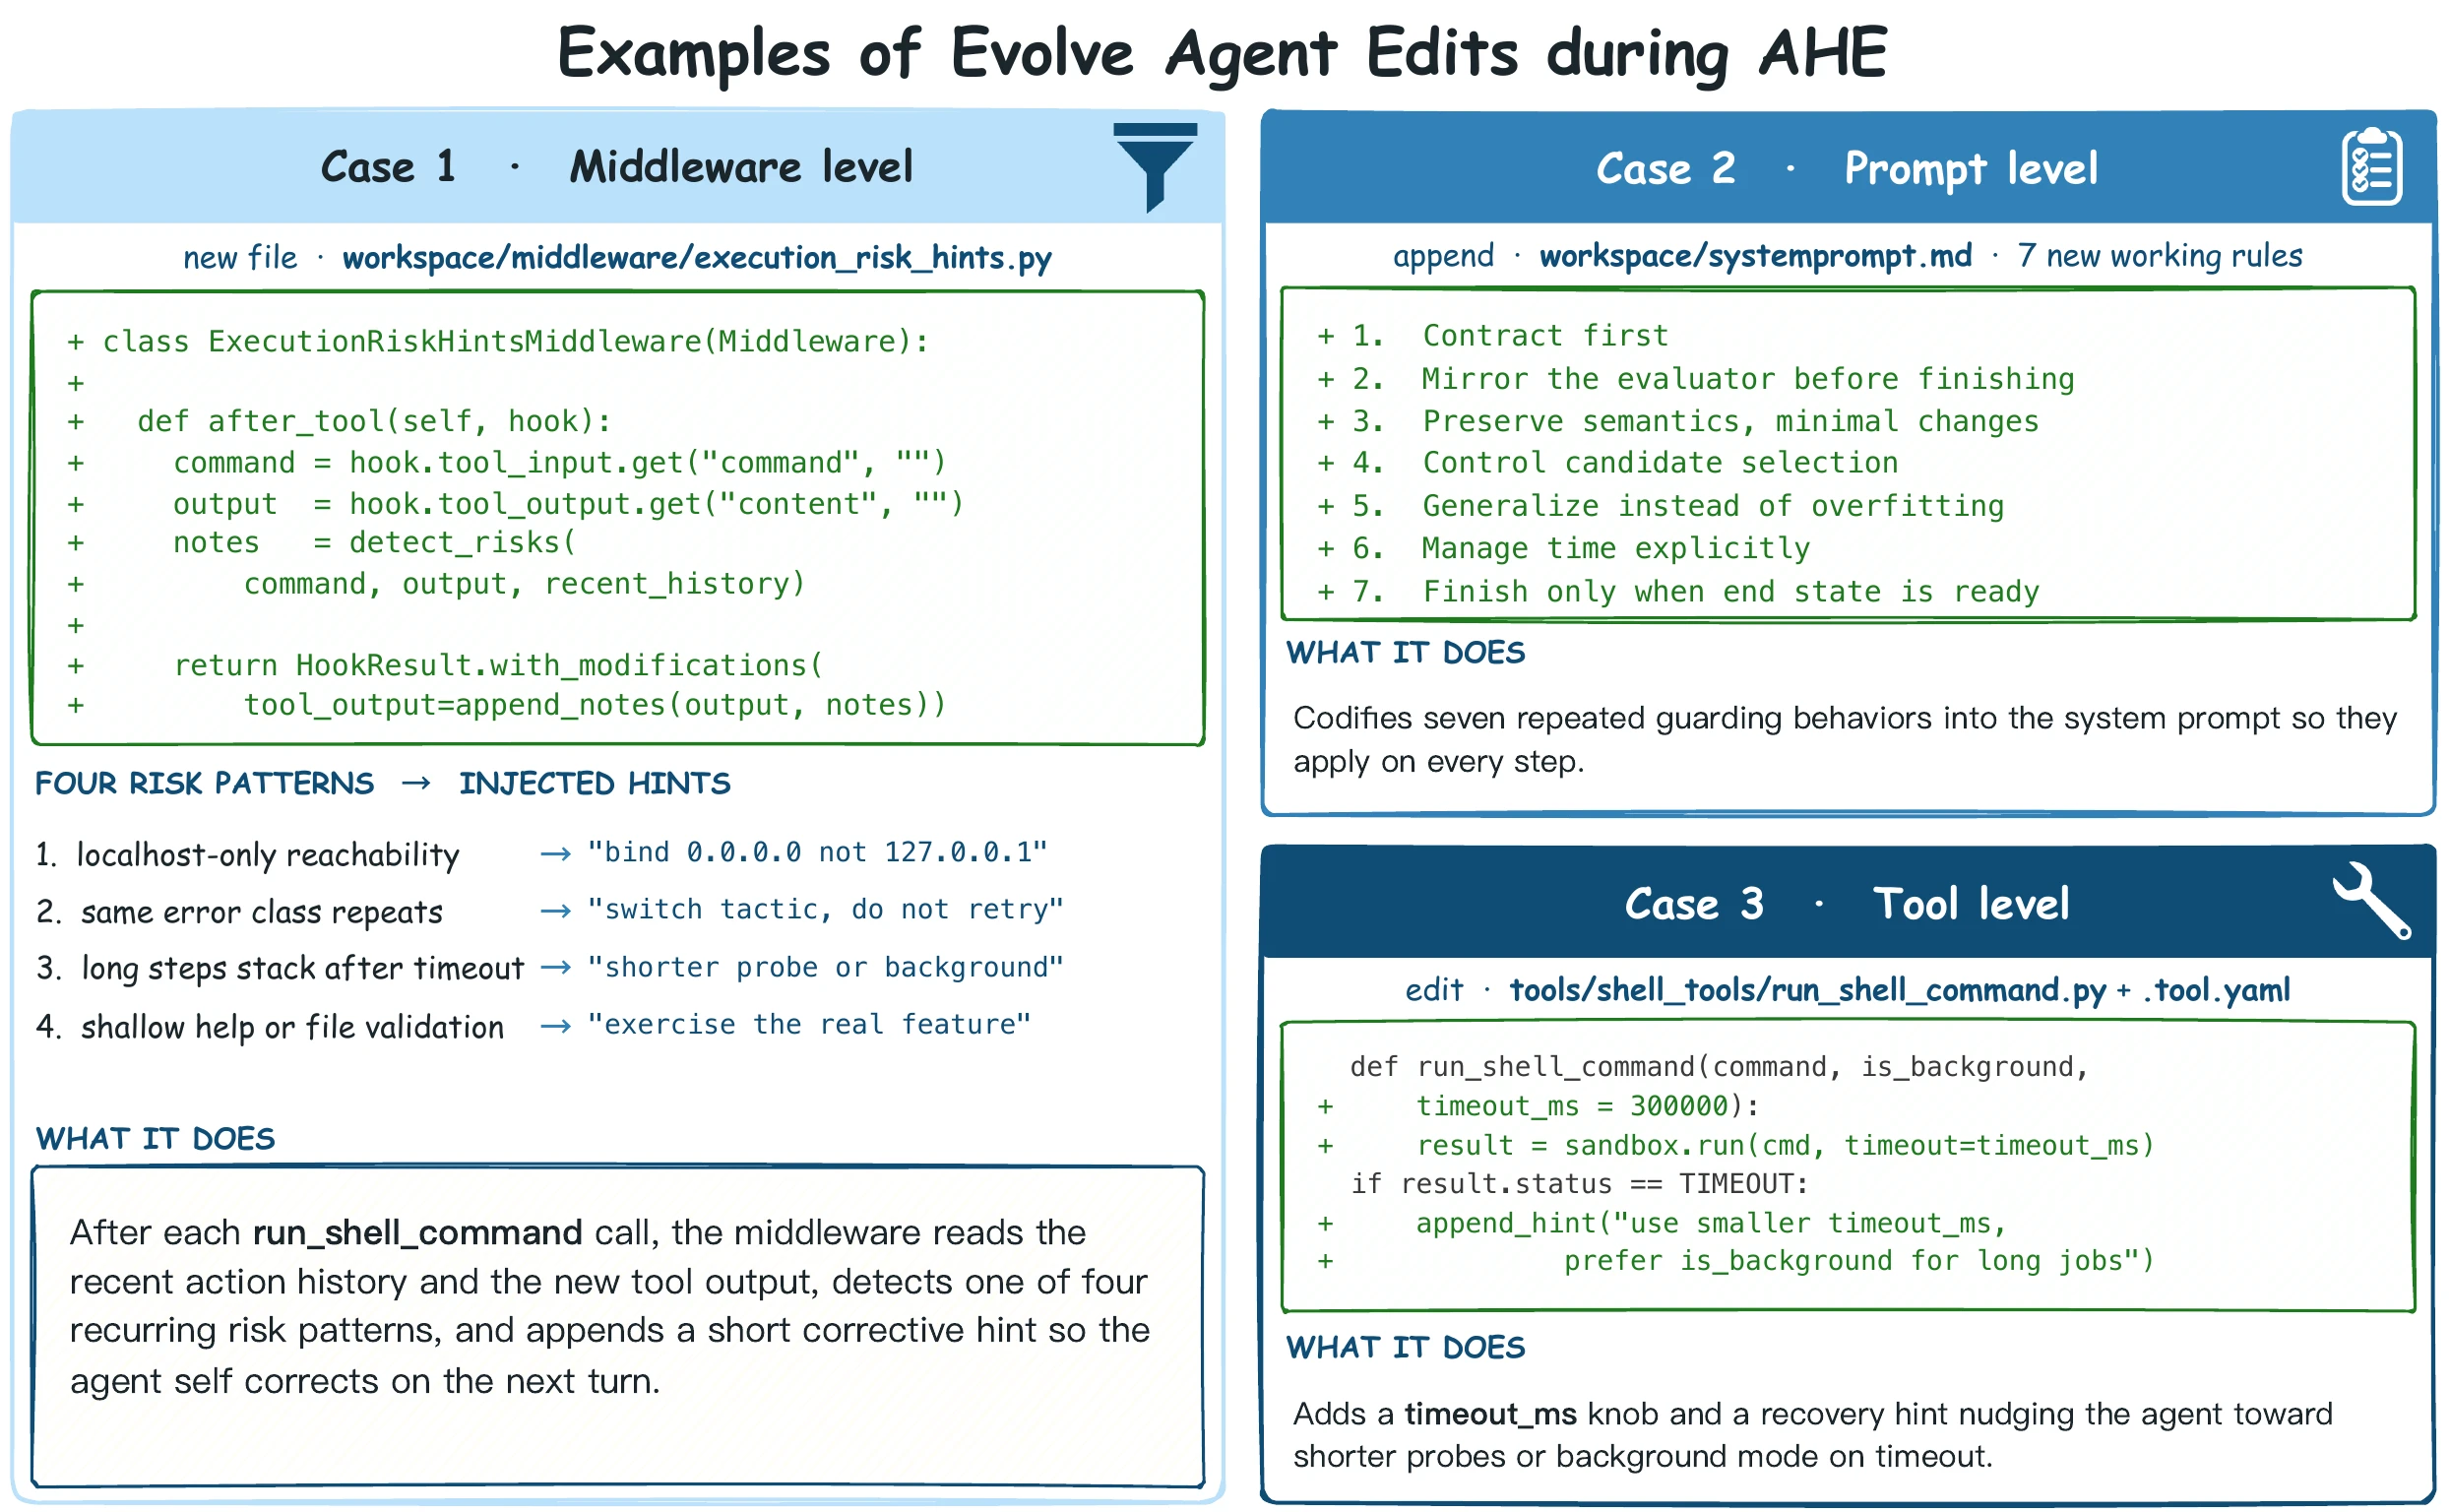
Evolve Agent 在可观测、可归因的 workspace 上进行修改、迭代,并遵循以下原则,使得其自身行为也尽可能可观测、可追溯。
只能写 workspace。runs 目录、tracer、verifier、LLM 配置都是只读,的原始 system prompt 显式标为不可删除。这把 Evolver 的动作空间限定在 harness,不允许它通过绕开 verifier 或换模型(如修改 reason effort)来 hacking。
证据驱动。在产生任何改动前,必须同时给出相应的理由:具体哪些 task 失败(failure evidence)、为什么失败(root cause)、一条直接针对根因的修改(targeted fix)、以及预计修好哪些任务 + 可能破坏哪些任务(predicted impact)。每一次改动都是可被下一轮评测证伪,而不是主观判断,被 evolve agent 综合评判为有害的改动会按文件粒度回退。
把前面所有要素组合在一起,每一轮外循环是六个顺序阶段:当前 harness 跑评测 → 清洗 trace → 对比上一轮变更判决 → Agent Debugger 做归因 → Evolve Agent 改 workspace 并给出 evidence → commit 对应修改。每一轮产物都归档到结构化目录,任意一轮的过程都可以被完整重放和审计。
实验设置
我们在 Terminal Bench 2.0 上进行迭代,Terminal Bench 2.0 是一个面向终端环境的 agent 评测基准,包含 89 个由人工核验的真实任务,覆盖软件工程、系统运维、科学计算等场景,每个任务都在隔离的沙箱中以脚本化测试判定通过与否。 我们采用 Terminal Bench 2.0 官方评测框架 harbor 进行评测。timeout 设置为 1h(由于 API 速度限制),使用 gpt-5.4 作为迭代模型,reason effort 设置成 high(兼顾实验效果和效率)。我们采用 e2b 的开源版本作为 sandbox 实现,本地部署(感谢 infra guys from Qijizhifeng & infraware)。
为了探索跨任务的迁移性,我们选择了 SWE-Bench Verified,由 500 道经人工核验的 Python 仓库级 bug 修复任务组成,agent 仅需产出代码补丁,由仓库自带单元测试判定是否解决。
前期的失败案例
Evolve Agent 的设计前后经过两次调整。前期我们观察到很多 overfit benchmark 的行为,为了与之对抗,我们尝试了一些努力。
Phase 1:subset 容易 hack
为了快速迭代,我们从 Terminal-bench 2 中挑选了较难的 30 题,让系统在子集上跑 10 轮。题目通过数在 16–20 之间反复震荡,没有持续上升的趋势。逐题对比每轮前后的 pass/fail 翻转,修复率 6.7%、回归率 7.7%,基本上修一个题就坏一个题,平均每轮净亏损一个点。
我们对 task-specific 的判定标准是:代码中是否包含只对特定 benchmark 任务有意义的信息,如具体的任务名、领域术语、文件路径、算法选择提示等。分析修改组件得知,Evolve Agent 诊断推理精确到代码级,在 30 题上直接变成了 task-specific hack:最终的 harness 里有针对 Fibonacci 算法的 fast-doubling heuristic、针对 Golden Gate 的 splice-offset 检测、针对 Caffe 的完整工作流模板。
结论:小子集导致 task specific 的信号过强 (一道题在整个题集的占比过高),无法在评测结果上抑制 hack。需要更加真实的信号。
Phase 2:人工先验的行为偏好不一定可靠
我们把题集扩到 89 题全集,并在 evolve agent 的 system prompt 加入显式方法论,包括三原则(Safety / Creativity / Generality)以及约束层级排序 "Always prefer the strongest constraint level that fits. Middleware/Tool impl > Tool desc > Skill > System prompt." 扩题集确实缓解了 overfit:回归率从 7.7% 降到 6.0%。Evolver 78% 的修改落在 middleware 层,prompt 只改了 3 次。没有再出现明显的 task-specific hack,但训练曲线在前期冲到 75.3% 之后就再没超过,进化停滞。修改出来的 middleware 确实比较通用但不一定有效(不解决问题),agent 全部收敛到修改这单一组件上。
结论:人工引入的行为先验成为了僵化。我们不该直接告诉 agent 人类的修改组件偏好,这可能是错误的。
Phase 3:鲁棒性与层次化
我们还观察到一个现象:coding task 里面包含大量环境噪声,来自模型 api 的稳定性、温度、sandbox 稳定性等等,因此需要更鲁棒性的方案。
具体改动分两部分。
- 评测时每题跑两次(非常简单地同设置运行 2 次),不是为了刷 pass@k,而是进行 partial-pass 对照。同题同 agent,一次过一次没过,Evolver 直接 diff 两条 trace 就能定位根因,这是最高质量的诊断信号。
- 给出 context 的优先级。要求 agent 先读
overview.md,改完 middleware 后读运行日志。避免所有行为指导,删整段 Creativity 原则、Generality 对照表、约束层级排序;只保留 Evidence-Driven 过程要求以及 rollback-and-pivot 规则。
在同一 89 题 benchmark 上稳步提升,后期触顶 77.0%,且提升更稳定。修改分布变为 middleware 37% + tool 48% + prompt 10%,没有任何单一层级超过 50%,不同进化阶段灵活调整:前几轮偏 tool + prompt,中后期才加入 middleware。
主要结论
Agent 从外界反馈中获得 evolve 的原动力。对 evolve agent 来说,人类的工作不是替它思考方法论,而是确保反馈信号的质量够高、覆盖够全:扩大题集、增加 rollout 对照、预构建 analysis report、读运行日志。有了好的反馈,模型自己能找到正确的进化方向(bitter lesson again)。这就是我们构建可观测体系的核心动机。
在 Terminal-bench 2 上自动迭代
我们在 Terminal-Bench 2 的 89 题进行评测,所有 role agent 都用统一的 GPT-5.4 high reasoning。我们关心三件事:AHE 的有效性,harness 优化是否过拟合,以及价值到底沉淀在哪一类组件里。
主实验:持续进化并且超越人类设计的 harness
我们选择了同出于 openai 的 codex-cli 作为人类优化的 harness 对象。如图 1,经过 10 轮演化后,pass@1 分数从 NexAU_bash-only 的 69.7% 爬升到 77.0%,绝对分数 +7.3 pp,相对分数 +10.5%。
泛化性验证:跨数据集与模型
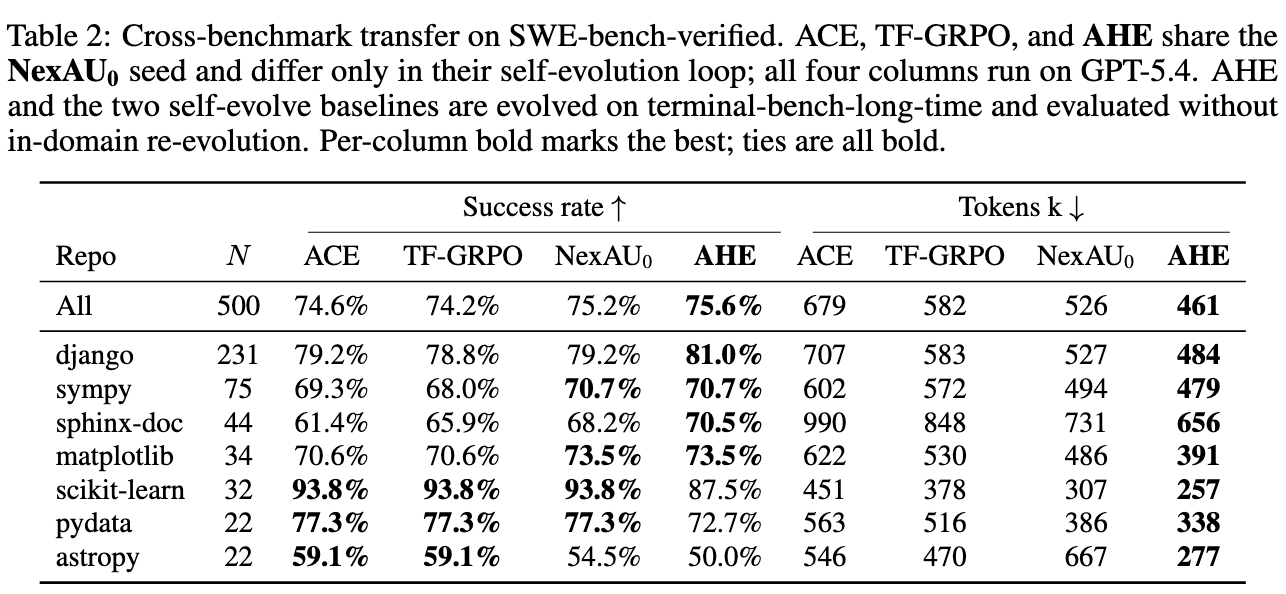
我们把演化后的 harness 冻结,在 SWE-bench-verified 的 500 题上评测。和其他持续进化的 baseline 方法(ACE、TrainingFree-GRPO)对比,AHE 在 success rate、token cost 上都领先。这说明,演化得到的 harness 学到的是通用工程经验,不是 terminal-bench 2 特化的刷榜技巧。
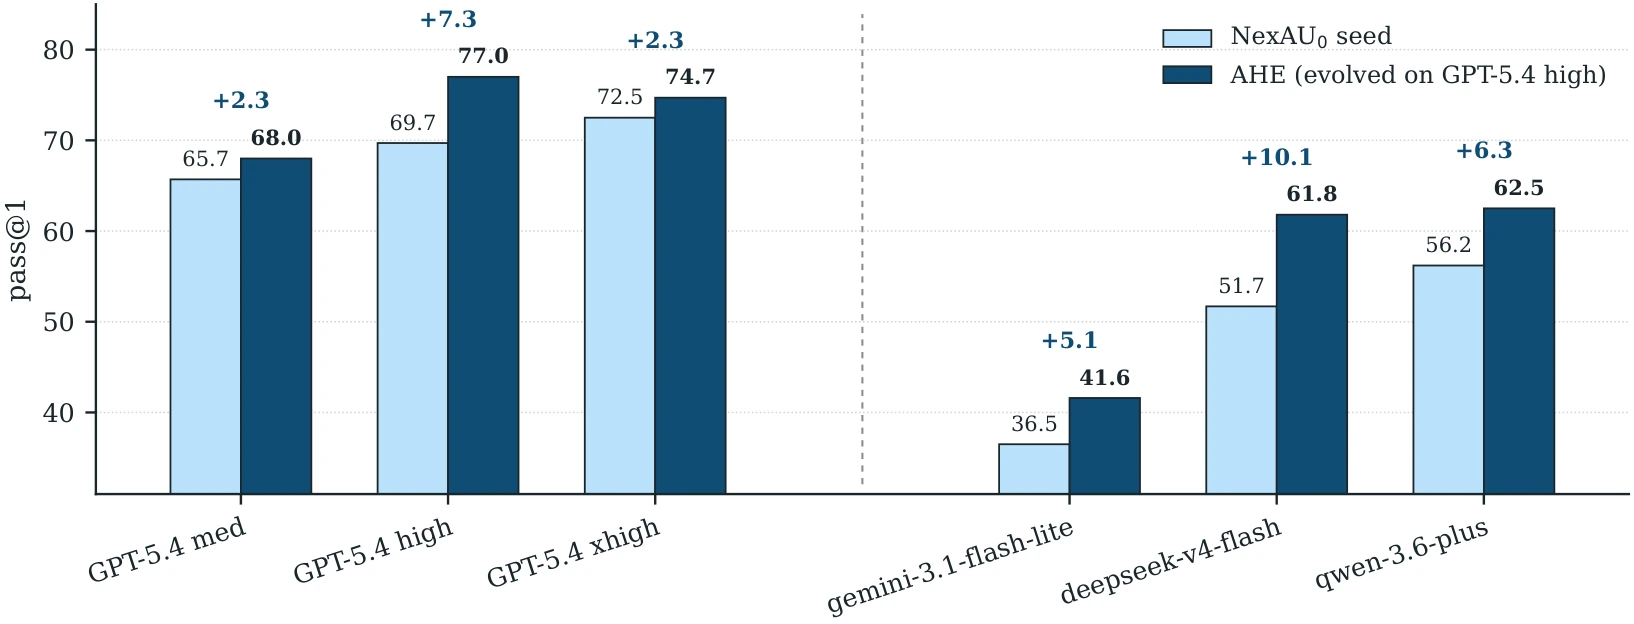
冻结同一份 AHE harness(gpt-5.4 演化而来),换 base model 重新评测(Terminal bench 2),不做任何再演化。在 Qwen、Gemini、Deepseek 上获得了 +5.1 pp 到 +10.1 pp 的提升,这证明了我们迭代出的 Harness 不是 GPT 特化的。另外,也可以说明,在一些较弱的模型上,Harness 带来的提升更为巨大:
组件迁移:价值沉淀在哪里
把 AHE 演化出的四类组件(memory、tools、middleware、system prompt)单独放回 NexAU 的 bash only 版本,其它三类保持默认,看每一类的边际贡献:
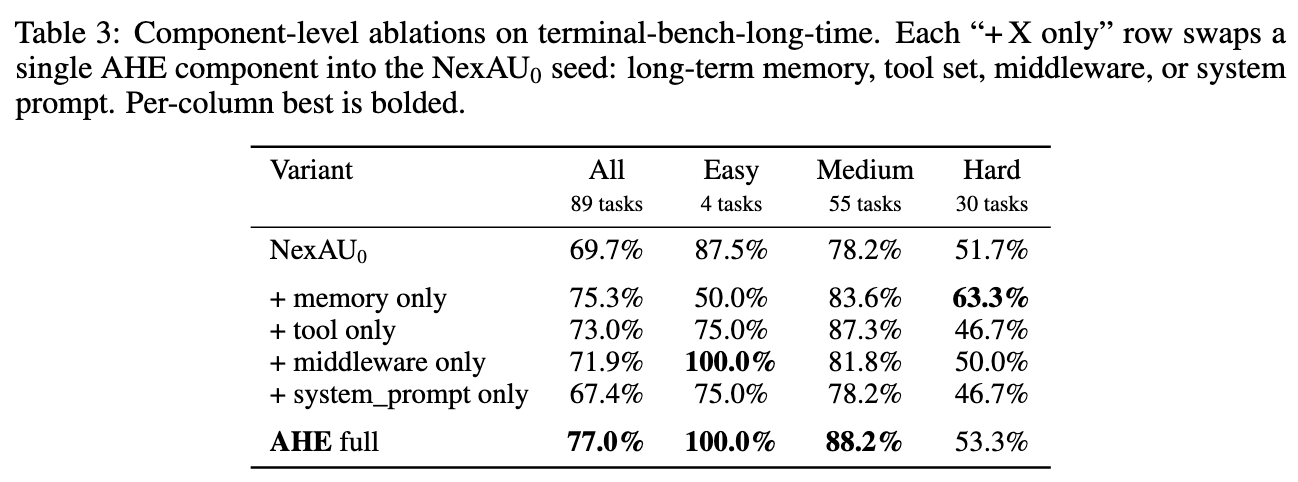
我们发现,memory 和 tool 增益显著,system prompt 单独迁不动。只换 memory 就恢复了全局增幅的 95% 以上,只换 tool 在 Medium 题提升显著,而 system prompt 反而下降。这和社区"先调 prompt"的惯性相反。我们的理解是:prompt 的语义是策略性的(你应该这样做),memory 和 tool 的语义是事实性的(这里有段可复用代码)。事实比策略迁移性好,保留了信息的同时维持了泛化性。
我们对 evolve agent 行为进行分析。其读取的 context 最大一类是 workspace 代码(44.9%),之后是 raw trace(22.8%)、debugger report(14.1%)。在所有阅读行为中 33 个被读 raw trace 的任务里有 32 个先读了对应 debugger detail。大约 56% 的失败题 Evolver 只读 debugger 根因就改代码,不回看原始轨迹。
从修改组件的分布上,tool_impl + middleware 合计占 76%,prompt 只占 13%,skill 从未被编辑。我们发现,单一迭代中的修改文件数量和效果无关,大量 edit 常常意味着 agent 的不确定性;少量、精准地修改文件,如 iter5 引入前置风险评估 middleware、iter9 引入后置验证 middleware,两次都实现正收益。
下一步研究
回过头来,我们就做了两件事情:搭建好观测体系(让 Evolve Agent 能访问组件、轨迹、反馈),在全量数据上运行测试。方法论不需要人去替 agent 想,给 agent 一个结构化的 workspace、清晰的修改接口、以及高质量的反馈信号,它的行为会自动向真实工程师收敛。
当一个领域可以被 agent 自动化运行,人就要考虑更上层的设计了。当模型的智能跨越奇点,能自主完成更大范围的循环:harness 优化 → 构造弥补自身能力缺陷的数据或环境 → 训练更新参数 → 生产更困难的评测集。在一种指数型加速的进程中,我不敢想象 AGI 将以何等的迅速而到来。
是时候迈出第一步,让 harness 自动演化起来了。
引用本文
@misc{linAgenticHarnessEngineering2026,
  title = {Agentic {{Harness Engineering}}: {{Observability-Driven Automatic Evolution}} of {{Coding-Agent Harnesses}}},
  author = {Lin, Jiahang and Liu, Shichun and Pan, Chengjun and Lin, Lizhi and Dou, Shihan and Huang, Xuanjing and Yan, Hang and Han, Zhenhua and Gui, Tao},
  year = 2026,
  month = apr,
  doi = {10.48550/arXiv.2604.25850},
  url = {http://arxiv.org/abs/2604.25850}
}