Agent Debugger:通过 Agentic 工作流理解 Agent 轨迹
为什么要做 Agent Debugger?
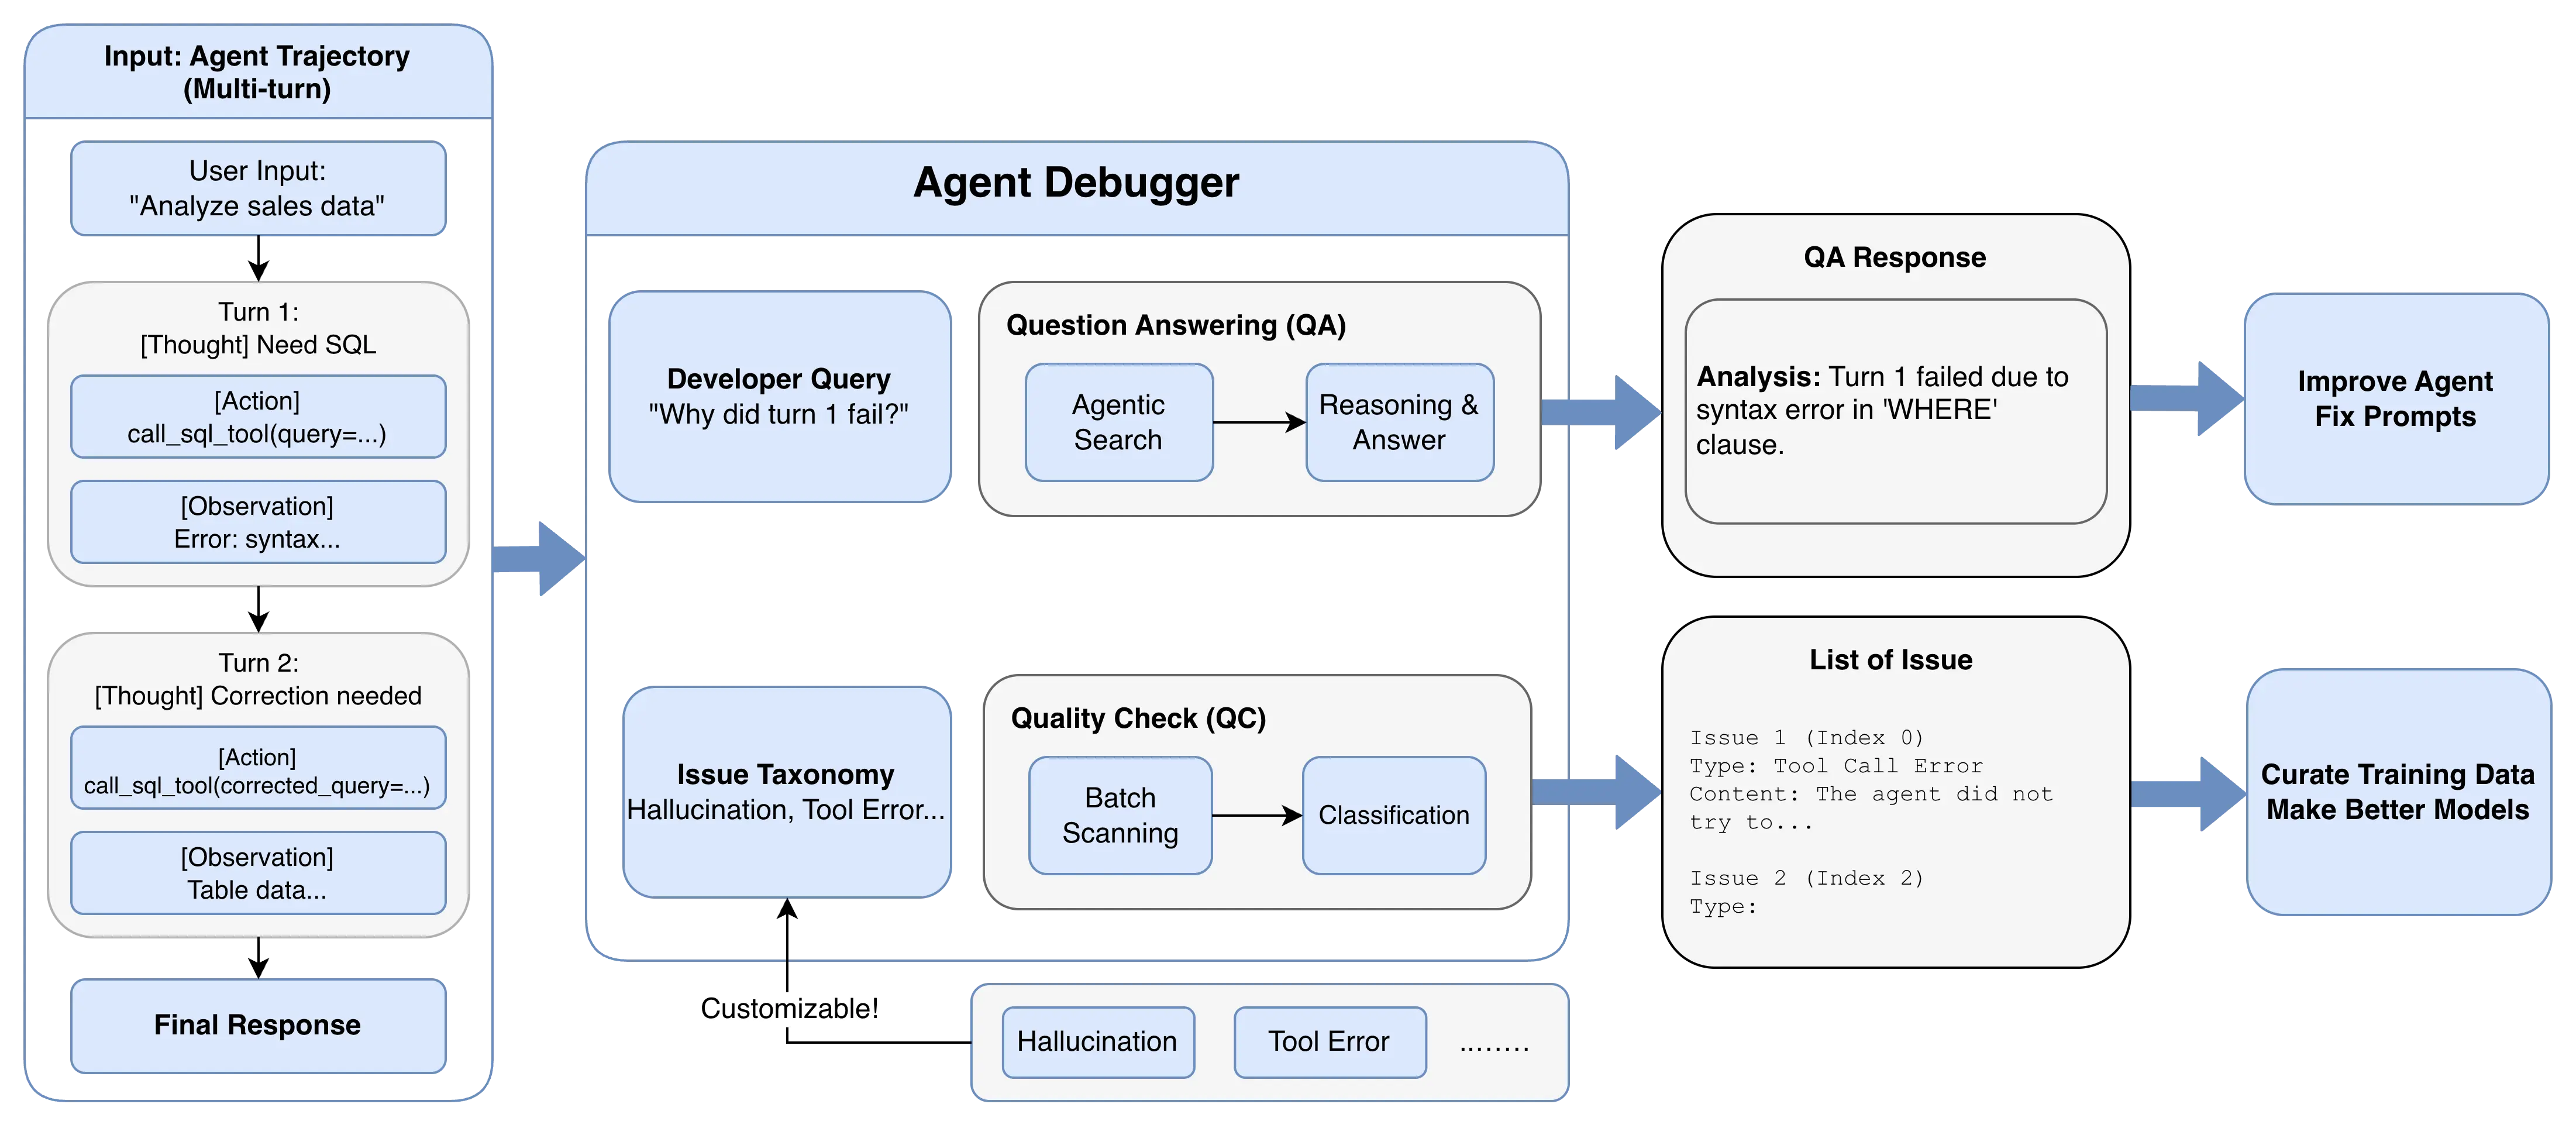
Agent 越来越流行,而每个场景都希望构建 Agent:针对自己的业务设计工具和 system prompt 来构建 Agent,乃至使用 Agent 轨迹数据训练模型,使其掌握 Agent 能力。现在有了各种框架,构建和运行 Agent 非常容易,但迭代 Agent 反而变得困难:
- 我构建的 Agent 在哪里遇到了问题,应该如何改进?
- 如何找出 Agent 轨迹数据的问题并过滤,从而得到高质量的数据集?
可以看到,迭代 Agent 的重要方式就是理解 Agent 的轨迹:Agent 解决一个问题时调用了哪些工具,进行了哪些思考。但是 Agent 往往需要多轮调用工具才能解决问题,轨迹很长,单纯靠人力无法穷尽所有线上轨迹。我们需要借助语言模型强大的语言能力来帮我们找出轨迹中的问题,借用编程的术语来说,就是需要 Agent 的 Debugger。 Agent Debugger 应该做什么呢?从上述两个问题,我们会发现有两类需求:
- 问题回答(Question Answering):针对一条轨迹,回答开发者的一系列问题,比如写 SQL 的 Agent 做错了,我们会问“为什么 Agent 失败了”;在深度研究的场景中,看到某条消息,我们会想“这个事实是哪里找到的?” 这需要分析轨迹,前后跳转来找到轨迹中的相关片段并呈现给用户。呈现给用户的可能是一段对话,也可能是一个结构化的 JSON 方便后续处理。
- 质量检测(Quality Check):针对一条轨迹,判断是否存在某些类别的问题。比如要用 Agent 轨迹训练模型前可以扫描一遍,找出存在问题的轨迹并删掉,有些类别的问题必须删掉,有些类别的问题则可以保留;或者每天定时扫描线上 Agent 得到的轨迹去检视一些问题,发现出现工具问题就去修正一下。质量检测呈现给用户的就是一个问题列表,里面会标注问题的类别,问题所在回合的索引,以及问题内容。
这两类问题可以互相转换,比如针对轨迹批量问一个问题也可以是质量检测,但往往质量检测会有一个问题分类(Taxonomy),需要检查多个类别的问题,并且要保证足够的召回率和精确度,单纯依靠一次 QA 就有些力不从心了。
Agent Debugger 设计
问答式智能体调试器
如何设计 Agent Debugger 呢?最直接的想法就是把整条轨迹喂给模型。我们统计了评测中使用的轨迹的 token 数量,很多轨迹其实没有超过现在很多模型的上下文窗口限制。直接把轨迹喂给 LLM 是可行的。但是实际测试下来效果并不好:做 QA 时会在一些地方误判,做质量检测时会漏掉很多问题。 这可能要归结于 context rot 的问题,也就是 LLM 的能力随着上下文逐渐变长而下降的现象。然而轨迹里的问题可能出现在任意位置,而且不止一个。因此我们选择让 Agent Debugger 成为一个 Agent:将 Agent 轨迹变成一个“环境”,Agent 可以使用工具去探索环境,比如使用 grep 快速定位关键词出现的位置。
基于文件系统的环境
如何把轨迹呈现给 Agent?我们选择了依托文件系统的办法,因为所有现代模型都经过基于代码库环境的 RL 训练,非常擅长使用文件系统的工具,使用文件系统的方式描述轨迹能够复用 Agent 的能力。 考虑最简单的情况,一个 Agent 轨迹就是一个 messages 数组,里面按顺序排列了一系列 message。我们为一条轨迹建立一个目录,把每个 message 变成一个 JSON 文件并标号:
trace_XYZ/
    message_all.json
    message_01.json
    message_02.json
    message_03.json
基于这个环境,QA Agent 需要如下基础工具来查看轨迹:
trace_ls查看当前目录内容,类似于lstrace_read阅读某条 message,类似于cattrace_read_batch一次性阅读多条 message,适合批量理解轨迹内容grep查找出现某关键词的消息(我们稍作封装以返回位置)
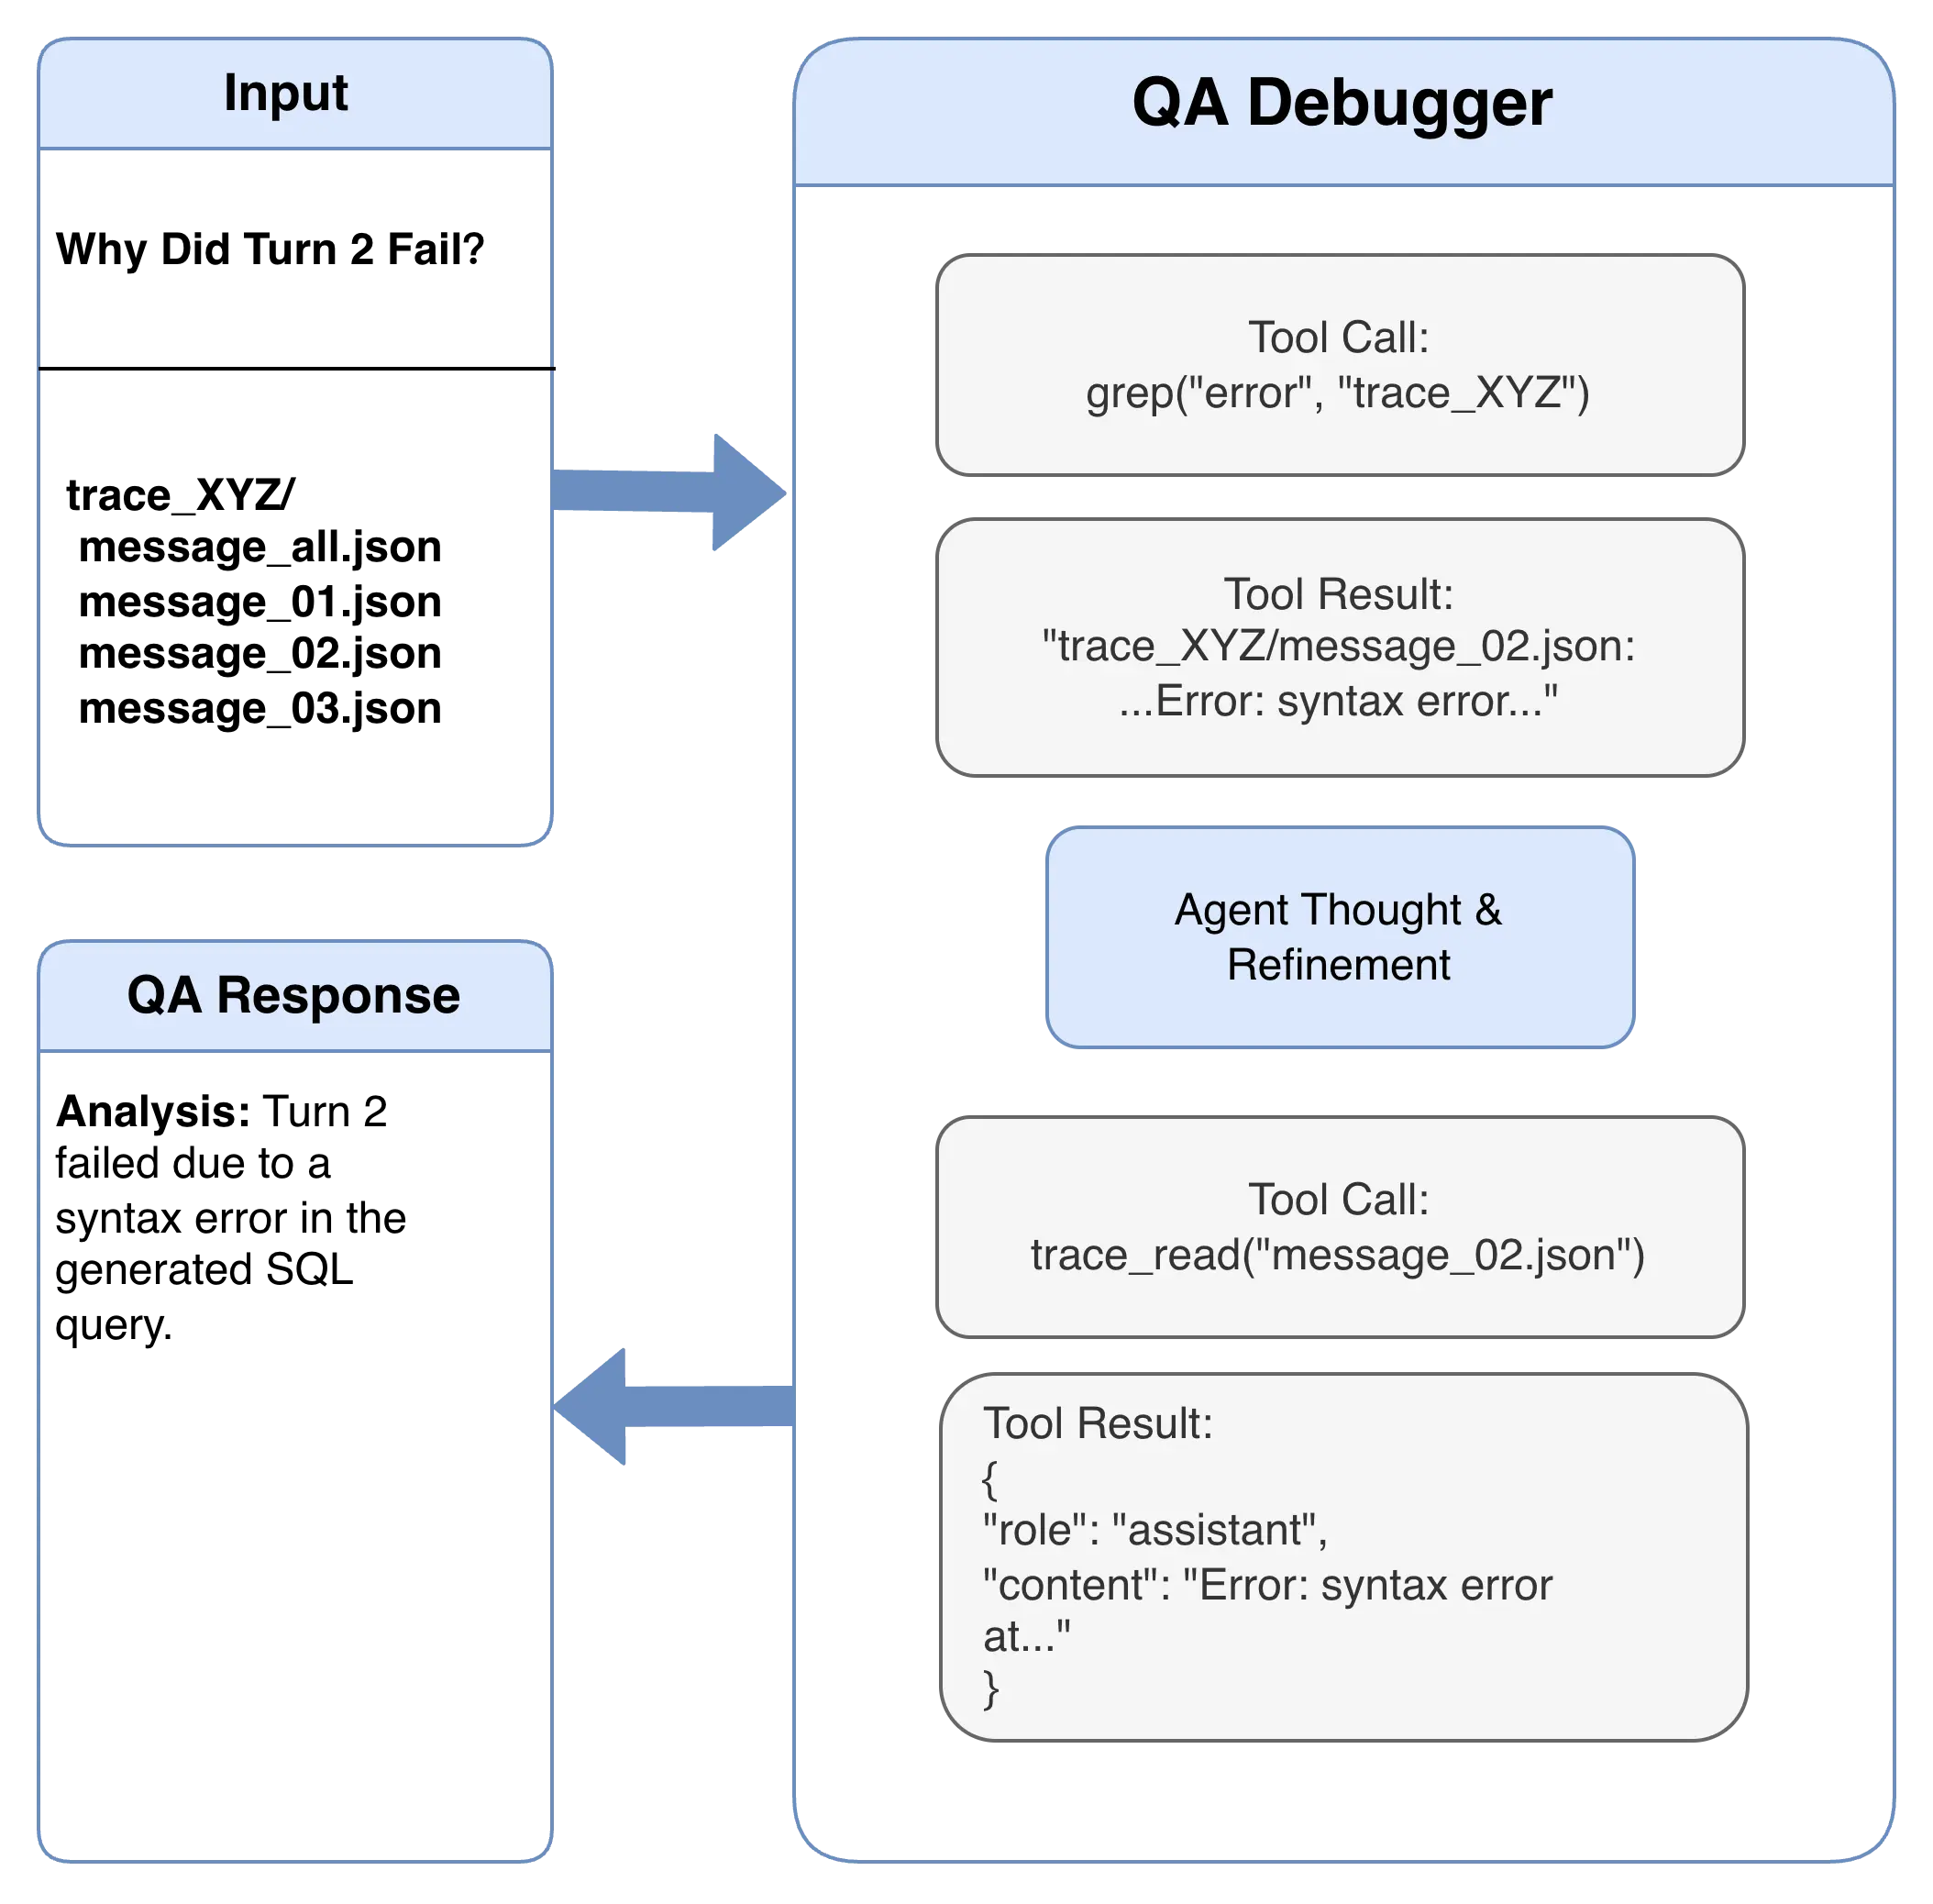
trace_ls 和 grep 都类似于 bash 命令,方便模型理解工具并使用。
此外我们还使用基于 LLM 的工具,这类似于最近提出的 Recursive Language Model 的思想(见 论文):
chunk_trace:将轨迹分块总结。我们将轨迹划分为若干批次,用 LLM 遍历并维护分块摘要,使主模型可以快速了解轨迹的主要内容。filter_trace:按某一标准使用 LLM 过滤轨迹,输出符合标准的轨迹。
轨迹格式
一些框架的轨迹会比较复杂。比如 Claude Agent SDK 和 NexAU 这种现代比如 NexAU 会有 Sub Agent:某一次工具调用可以启动一个 Sub Agent 去完成子任务,这导致轨迹是树形结构。对于 Sub Agent,我们按照相同的办法将每个 Sub Agent 放到单独的文件夹里,并在原始调用 Sub Agent 的 tool call 中添加指代。
trace_XYZ/
    message_all.json
    message_01.json
    message_02.json  # 提供指向 Sub Agent 的指针
    message_03.json
    sub_agent_01/
        message_01.json
        message_02.json
        ...
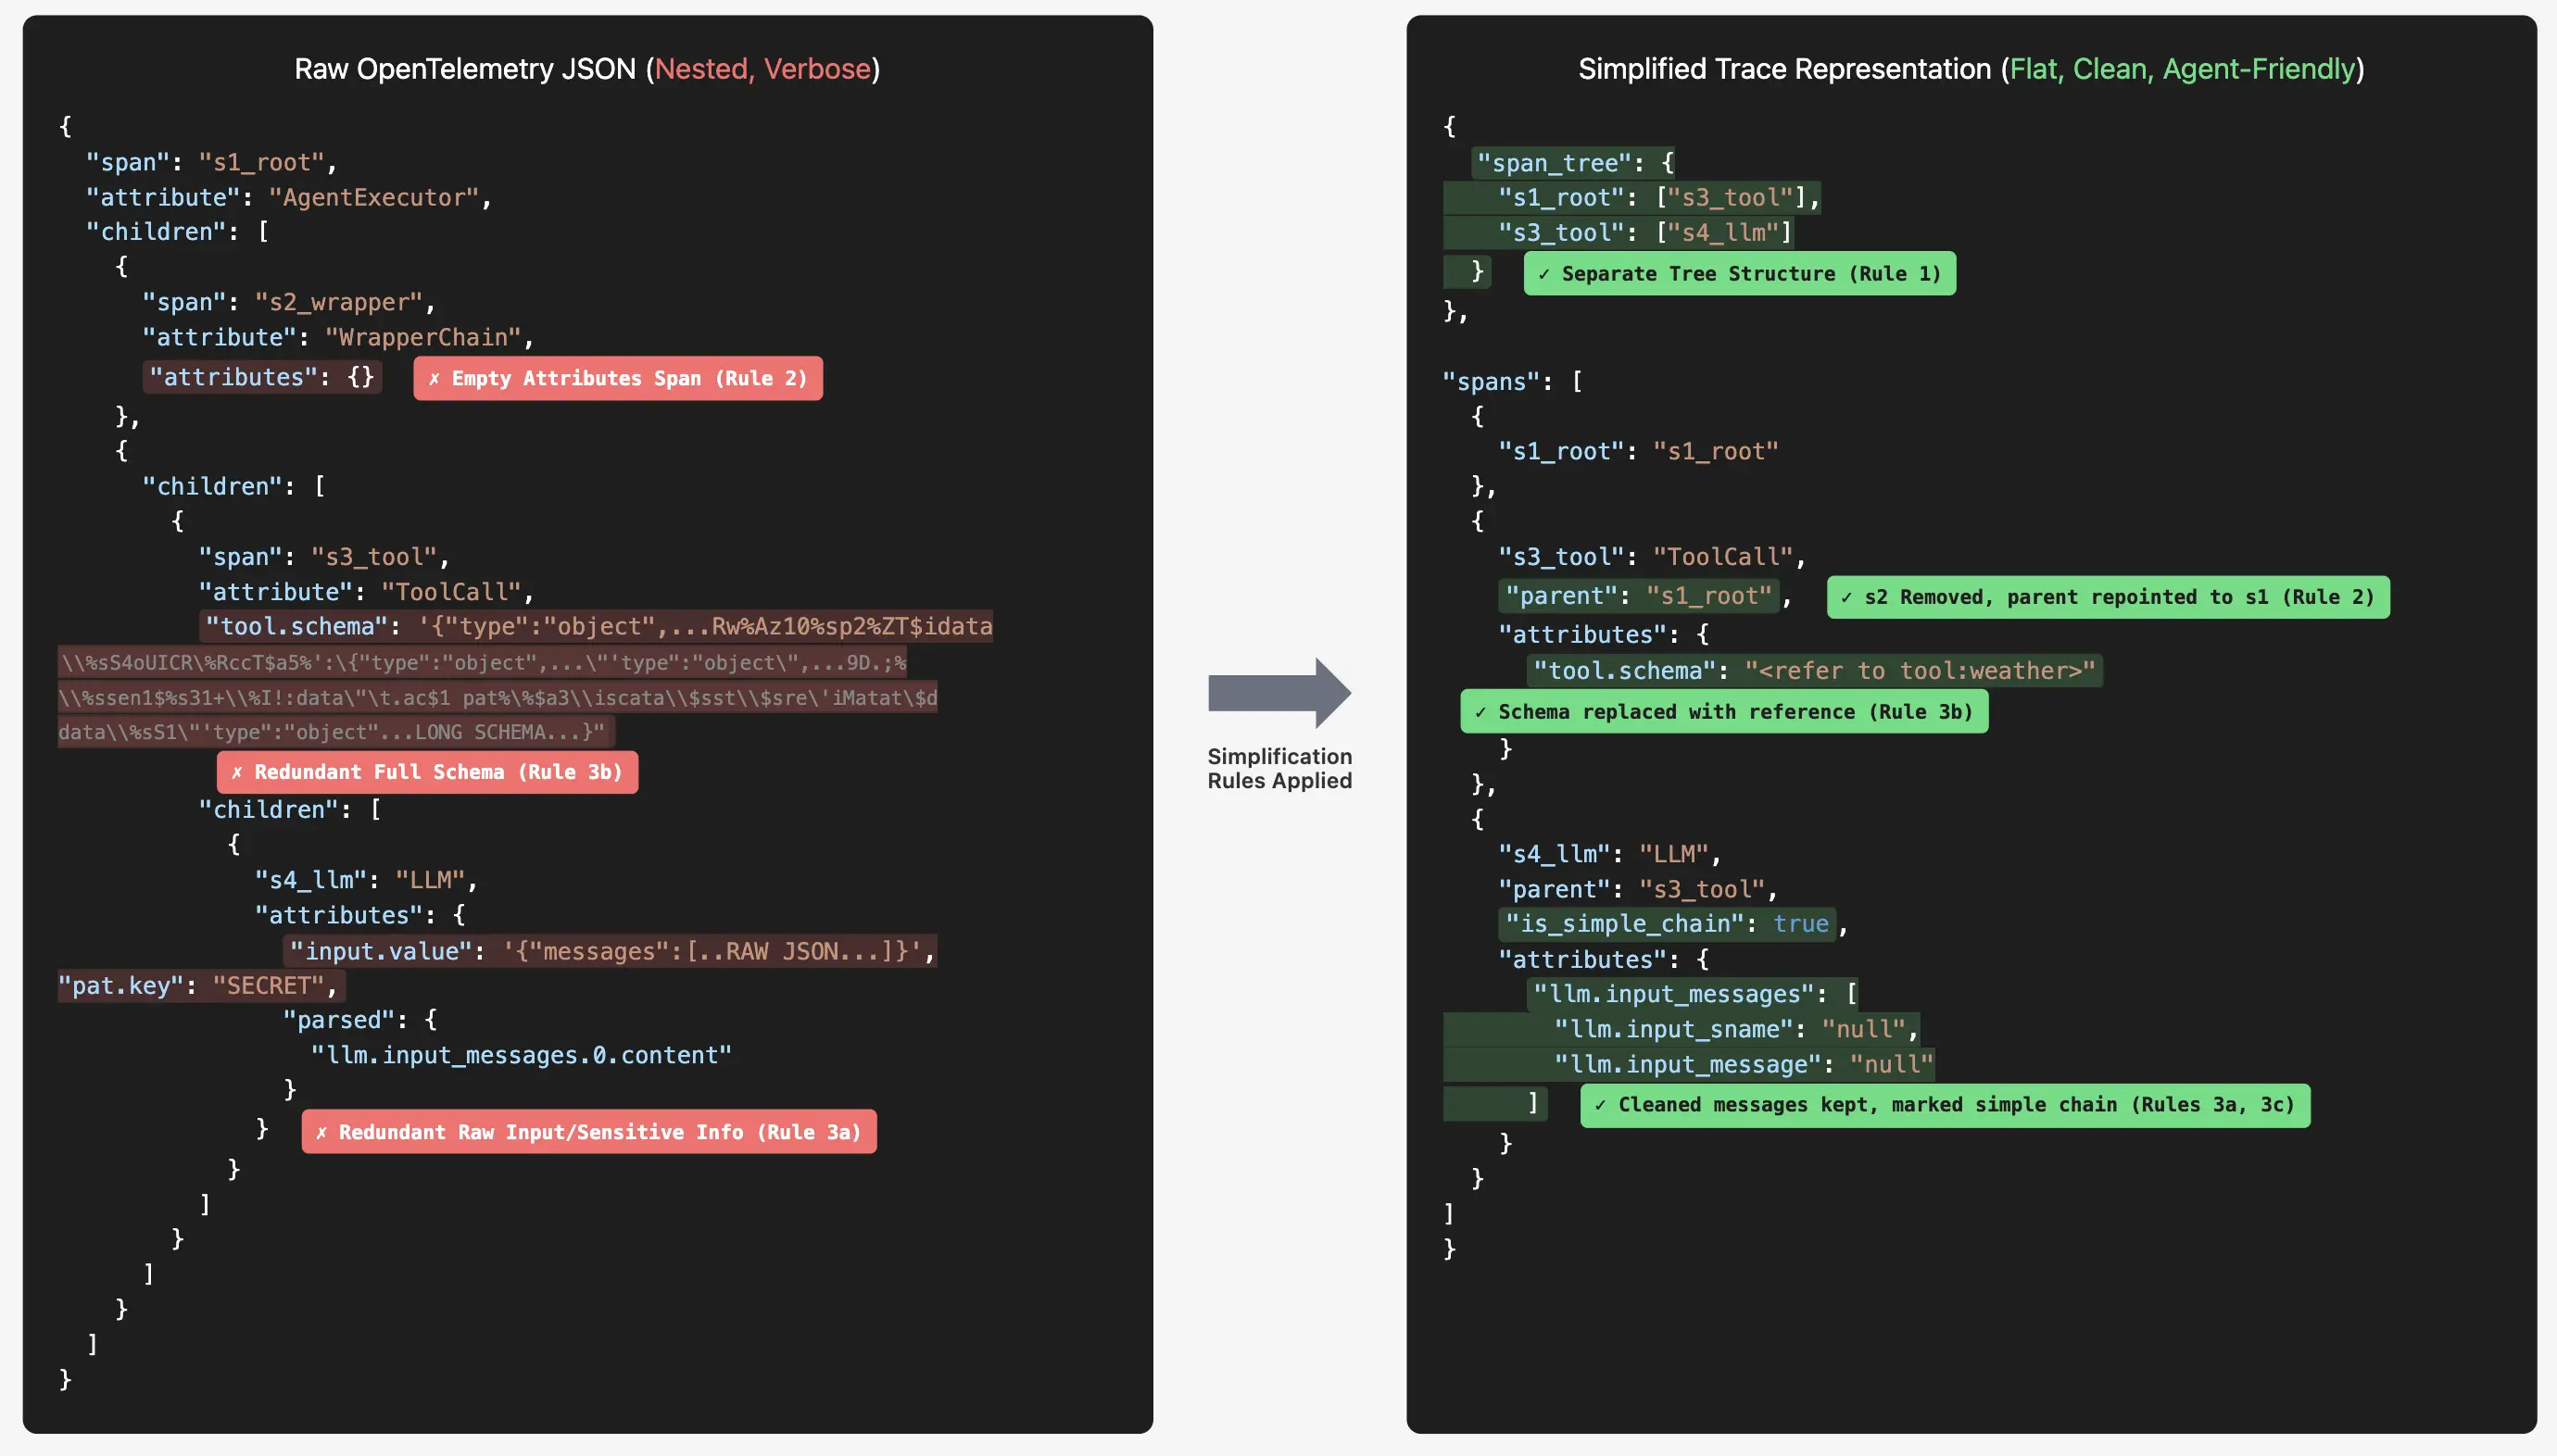
对于更复杂的轨迹和未来潜在更多的框架,应该怎么处理呢?这些框架原生支持 OpenTelemetry 格式,这种格式中一次函数调用就是一次 span,span 可以嵌套 span。一种方式就是基于这些 span,这种方式能表达任何格式的 Agent 轨迹,当然可能对 Agent 不太友好。 我们对 span 做了一系列简化来降低上下文占用:
- 提取每个 span 的
child_spans,展平,按时间戳排序,并记录一个span_tree表示 span 的嵌套关系 - 清除冗余 span,方法是删除
span_attributes里面没有任何属性的 span,这些 span 只记录了调用 - 清除 span 的冗余属性
- 对于 LLM 调用,清除冗余的
input.value/output.value、pat.*、mime_type等属性;input.value和output.value会被另外解析为llm.input_messages.*等字段,value里面是原始输入的 JSON tool_schema去重,替换为<refer to <idx>:<tool_name>>- 标记 LLM chain,也就是单纯逐轮追加 message 的一系列平级 span,这些 span 里面记录的冗余 messages 字段可以删掉
- 对于 LLM 调用,清除冗余的
质检 Agent Debugger 设计
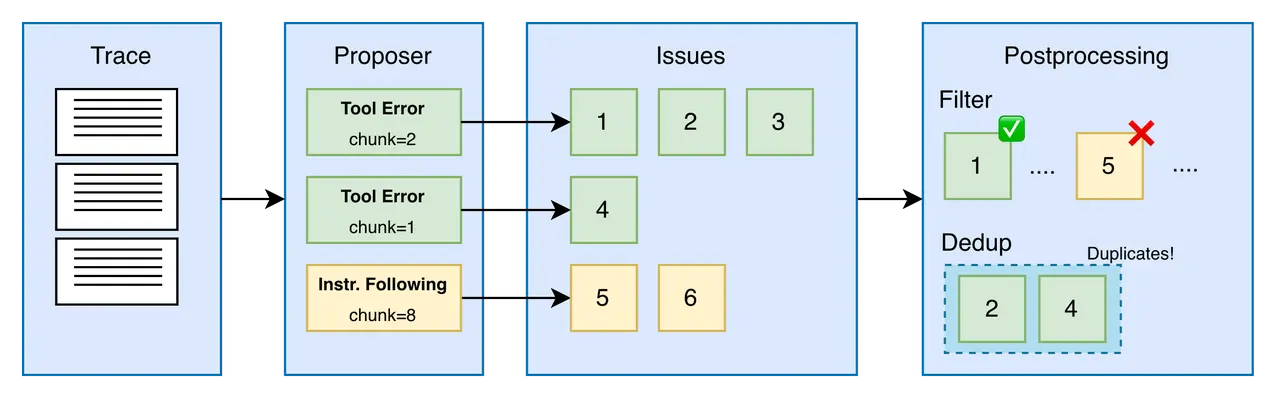
质检 Agent Debugger 的设计和 QA 有所不同,并没有使用 Agent。质检需要保证每个类别的召回率(recall)。此外我们发现很多错误其实是局部的,比如工具错误,因此可以直接并行处理轨迹的所有消息。 质检 Agent Debugger 包含 Proposer 查找问题和后处理两个部分。Proposer 负责给定轨迹的一部分,按照给定标准去查找问题。Proposer 有不同类型,可能是一个单纯借助 LLM 去产出 issue 的工作流,也可能是调用 QA Debugger 以 agentic 的方式处理轨迹。所有 Proposer 彼此没有依赖、独立运行,产出的 Issue 汇总后进行后处理;后处理包含去重和过滤,比如去除不同 Proposer 发现的类似问题,以及过滤不符合标准的问题,最终得到结果。 这是一套非常灵活的系统:用户可以自定义问题分类并编写 prompt,针对不同问题类型使用不同类型的 Proposer;对于工作流 Proposer,使用不同的 batch size。在我们的实践中,工具错误往往适合更小的 batch,而指令遵循等更“语义化”的问题则可以用更大的 batch。
针对内部的 Agent 轨迹,我们提出了以下分类:
- 工具错误:工具本身出现了问题,或设计上有问题。比如搜索工具无法正确返回结果,或者工具返回了过长的上下文。
- 不遵循指令:模型没有遵循指令,比如突然中断手上的事情去做其他事。
- 提前截断:在某一回合没有输出完整的工具调用或回复。
- 编造事实:包括不根据查找的资料确定细节,也包括使用代码生成模拟数据而不从 API 获取真实数据的行为。
- 行为循环:反复做某个事情,比如反复尝试某个命令而没有进展,或者是单纯的循环。
在迭代这套配置的过程中,我们发现有一些问题无法通过调整 prompt 来解决,因此添加了一些过滤器来剔除如下特点的问题:
- 虚假日期:模型会认为 2025/2026 年是虚假年份,这个认识无法通过简单在 prompt 里添加日期来纠正。这可能是一个比较广泛的问题,很多模型似乎永远留在了 2024 年
- 单元测试失败:有时候模型会认为单元测试失败是工具错误,但单元测试失败是调试的正常环节
- 搜索结果无关:模型会认为搜索结果无关是工具错误,而没有理解搜索引擎返回的结果无关是很正常的
质检 Agent Debugger 的使用
一个质检 Agent Debugger 对应一个配置文件,主体结构为:
{
    "proposers": [{ ... }],
    "filters": [{ ... }], # 可选
    "issue_mergers": [{ ... }], # 可选
}
其中 proposer 的结构为:
{
    "name": "tool_error_full",
    "issue_category": "工具错误",
    "prompt": "path/to/your/prompt",
    "chunk_size": 2,
    "chunk_format": "xml",
    "context": {
        "iterate_by": "message",
        "lm_response": true,
        "tool_call": true,
        "user_input": true,
        "system_prompt": false
    }
}
字段说明:
issue_category用于校验某一 proposer 能输出的 issue 类别,可以是单一类别也可以是多个类别chunk_size控制了 chunk 的大小,chunk_format调整 chunk 的格式,可以是 xml 也可以是 markdowncontext字段控制每一 chunk 的内容,可用来调整来得到最合适的输出,比如对于工具相关错误,只需要展示 tool call 即可
Proposer 会输出 Issue 列表,一个 Issue 包含 issue_type, summary, message_index 和 evidence 四个字段,描述其类型,issue 总结,轨迹中相应回合的索引和证据。
Filter 用来过滤不符合要求的 Issue,主要有 name 和 prompt 字段,其中 prompt 就是用来传给 LLM 的 prompt,需要让 LLM 输出 JSON 结构,里面包含 keep 字段,keep: true 表示保留该 issue。
相关工作
关于 Agent 轨迹诊断的评估,TRAIL 测试模型阅读超长、结构化的 Agent 轨迹,做错误定位 + 错误类型识别的能力,包含了 148 条人工标注的轨迹、841 个错误;trace 平均输入 token 极长(论文/博客里提到平均 >200k、最长到百万级 token)。AgenTracer 主要关注多 Agent 系统的错误归因。AgentRewardBench 数据集由人类专家对 Web Agent 轨迹回答“是否成功/副作用/重复性”等问题,用来检验自动评估器是否靠谱。AgentErrorBench 包含了 200 条专家标注失败轨迹,覆盖 GAIA / ALFWorld / WebShop 等测试集。 至于 Agent 轨迹诊断的系统,AgentDiagnose 是一个开源诊断框架,提供多种轨迹能力指标(如任务分解、self-verification 等)和可视化;LangSmith 的 agent-evals 通过 LLM Judge 去评估轨迹;Google ADK 的 evaluation criteria 提供了可复用的评估标准;此外还有 Lunette 这类平台提供轨迹审计/诊断服务。
实验
我们测试了质检和 QA 两个方向。
使用 TRAIL 测评质检 Agent
我们在 TRAIL 上测试了质检 Debugger 的表现。TRAIL benchmark 原始的测试方式是将整条轨迹放到 prompt 里,而我们使用质检 Agent Debugger 针对不同类型的问题做了专门调优。由于 TRAIL 的 Taxonomy 的标签非常多,如果为每个标签都添加 proposer 会导致延迟过高,因此我们选择合并性质相似且数量较少的标签。
结果显示,在该评测中 gemini-2.5-pro 的表现显著优于 gemini-3-pro。这可能有两个原因:一是我们的 prompt 调优主要基于 gemini-2.5-pro 的行为;二是 gemini-3-pro 可能存在长上下文性能问题,仍需进一步调查。
| Harness | Model | GAIA Weighted F1 | GAIA Loc. acc | GAIA Joint acc | SWE Bench Weighted F1 | SWE Bench Loc. acc | SWE Bench Joint acc |
|---|---|---|---|---|---|---|---|
| TRAIL baseline | gemini-2.5-pro | 38.9 | 54.6 | 18.3 | 14 | 23 | 5 |
| TRAIL baseline | gemini-3-pro | 29 | 35 | 11 | 25.10 | 3.21 | 0.00 |
| QC Debugger | gemini-2.5-pro | 45.35 | 80.28 | 42.59 | 65.92 | 87.83 | 27.17 |
| QC Debugger | gemini-3-pro | 57.49 | 48.36 | 18.79 | 12.8 | 13.23 | 1.97 |
使用 QA Debugger 诊断 Skill 轨迹
这方面的 benchmark 比较少,因此我们主要以定性研究为主。随着 Anthropic 提出了 Skill 这一模块化的能力提供方式,我们也开始展开对 Skill 数据的训练,但如何筛选这些数据成了一个问题。我们从 Nex 模型训练中用于训练模型使用 Skill 的相关数据里抽取了 500 条轨迹,并向 QA Agent Debugger 询问模型是否使用了 Skill,发现有 68 条并没有真正使用 Skill。这些数据本身是经过筛选的,但据了解筛选比较简单:只是将整条轨迹放到 prompt 里来询问模型。由此可见 agentic workflow 的重要性。
我们进一步分析这些未使用 Skill 的轨迹,发现大致可以分为三类:
- Skill 不可用:Skill 调用失败,缺少环境支持等。模型可能不会重试,而是直接用通用方案解决问题。
- 加载但没有深入参考 Skill:只是加载了 Skill,但没有真正使用 Skill 里的特定代码,而是写了一般性代码。
- 多次 Skill 切换中忽略先前 Skill:Skill 加载成功,但后续切换到另一个 Skill/路线,前一个 Skill 被搁置。
结论
随着 Agent 系统交互轮数增长、复杂度增加,人们需要更好的工具来理解 Agent 的行为。Agent Debugger 提供了问答和质检两种模式:既能回答关于轨迹的特定问题,也能批量扫描轨迹、进行回归性测试。在技术选型上,问答采取了 agentic workflow 的方式,将轨迹转化为一个基于文件系统的环境,让模型充分利用在代码库上训练出的探索能力,克服上下文限制来回答复杂问题;质检则采用批量扫描轨迹信息的方法,解耦不同问题类别来保证召回率和精度。
参考
- TRAIL: Trace Reasoning and Agentic Issue Localization
- AgenTracer: Who Is Inducing Failure in the LLM Agentic Systems?
- AgentRewardBench: Evaluating Automatic Evaluations of Web Agent Trajectories
- Where LLM Agents Fail and How They can Learn From Failures
- AgentDiagnose: An Open Toolkit for Diagnosing LLM Agent Trajectories
- LangSmith: trajectory evaluations (agentevals)
- Google ADK: evaluation criteria
- Introducing Lunette: auditing agents for evals and environments
- Recursive Language Model