ABC-Bench:面向真实开发场景的智能体后端编程能力评测
引言
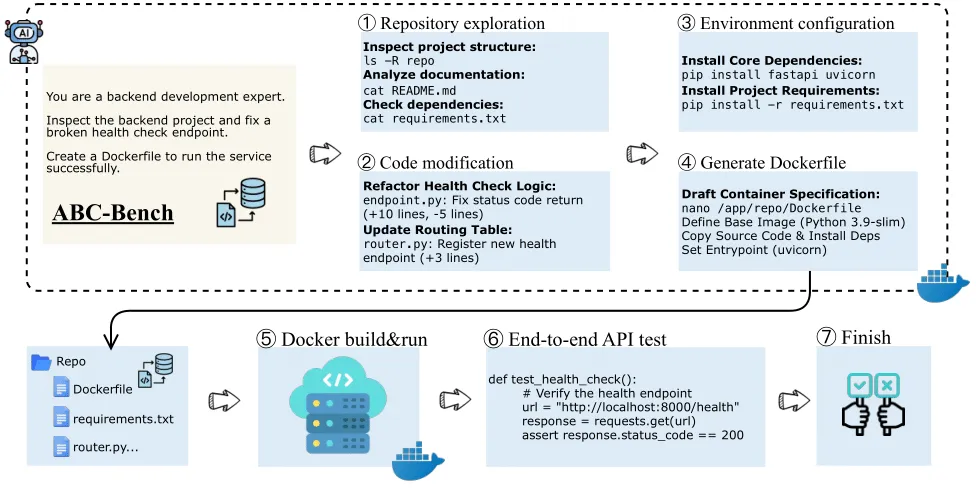 Figure 1: ABC-Bench 评测流程概览。开发阶段(步骤1-4)要求智能体分析仓库结构、解决编程问题并编写容器配置;验证阶段负责构建并部署服务(步骤5),随后通过真实 HTTP 请求验证功能正确性(步骤6)。
大语言模型(Large Language Model, LLM)正从代码生成工具演变为能够自主探索代码仓库、执行终端命令并完成复杂任务的智能体(Agent)。然而,一个核心问题仍悬而未决:这些智能体能否可靠地交付生产级后端服务?
现有评测基准存在系统性缺陷:它们主要在静态、预配置的环境中评估代码逻辑正确性,未能覆盖真实工程中的动态需求。这一局限在后端开发场景中尤为突出,因为后端开发对环境配置、依赖管理和服务部署能力有着严格要求。
为弥补上述不足,我们提出 ABC-Bench(Agentic Backend Coding Benchmark),一个评估智能体完整后端开发生命周期能力的基准测试。与以往聚焦于孤立代码编辑的基准不同,ABC-Bench 要求智能体完成从代码仓库探索到容器化服务部署的全流程任务,并通过端到端 API 测试进行功能验证。
研究动机
真实的后端开发是一个完整的工程流程,其中编码、配置与部署紧密耦合。然而,现有基准将这一流程人为割裂,仅评估其中的孤立环节。
| 基准测试 | 仓库探索 | 代码编辑 | 环境配置 | 服务部署 | 端到端测试 |
|---|---|---|---|---|---|
| BaxBench | ✗ | ✓ | ✗ | ✗ | ✓ |
| SWE-bench | ✓ | ✓ | ✗ | ✗ | ✗ |
| FullStack Bench | ✓ | ✓ | ✗ | ✗ | ✗ |
| Devbench | ✗ | ✓ | ✓ | ✗ | ✗ |
| ABC-Bench | ✓ | ✓ | ✓ | ✓ | ✓ |
表1:主流基准测试覆盖范围对比。ABC-Bench 是目前唯一覆盖完整后端开发生命周期的评测基准。
这种割裂导致了评测盲区:智能体可能擅长生成语法正确的代码,却在环境配置或服务部署环节完全失败。ABC-Bench 通过要求智能体交付可通过外部 API 验证的已部署功能性服务,有效填补了这一评测空白。
ABC-Bench 数据集
数据集构成
ABC-Bench 包含从真实开源仓库中精选的 224 个工程任务,覆盖范围如下:
- 8 种编程语言:Python、JavaScript、Java、Go、Ruby、C#、PHP、Rust
- 19 个主流后端框架:Spring Boot、Express、Ruby on Rails、Laravel、FastAPI、Gin、ASP.NET Core 等
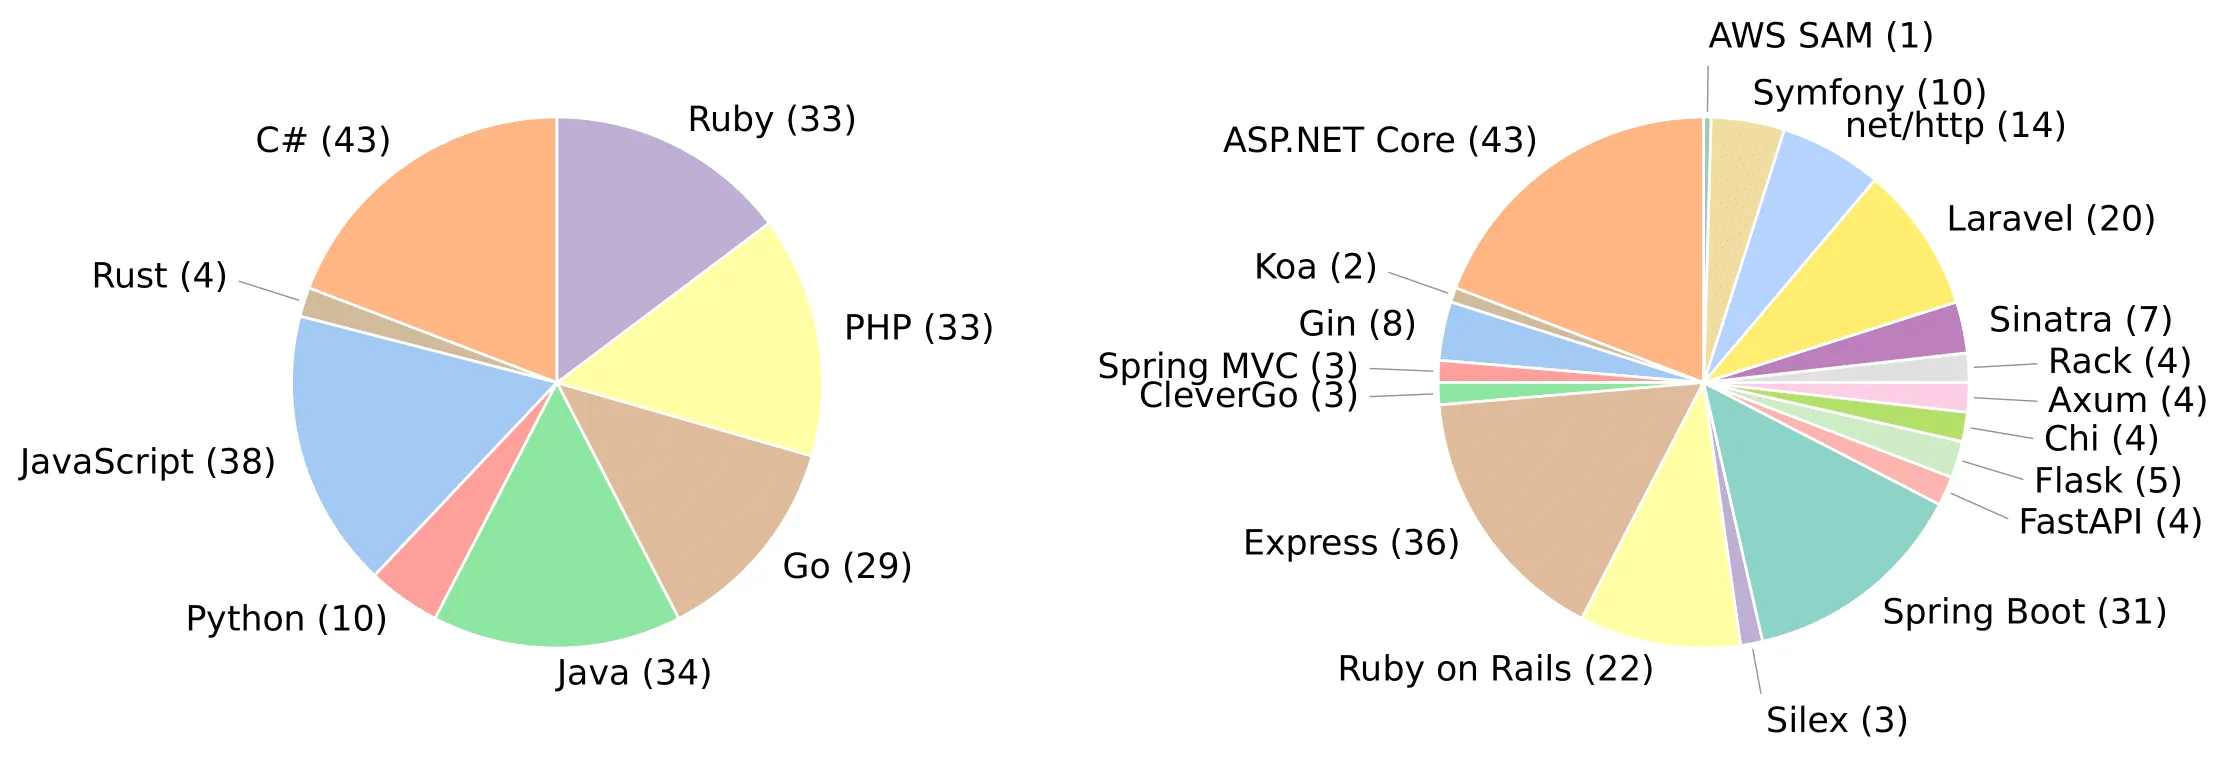
Figure 2: 任务在编程语言(左)与后端框架(右)维度上的分布情况,展示了本基准对现代后端技术生态的全面覆盖。
任务涵盖多个典型应用领域,包括内容管理系统、电子商务平台、开发者工具、数据分析服务、通信系统及基础设施服务等。
任务类型定义
ABC-Bench 将任务划分为两类:
- 逻辑实现任务(Logic Implementation, 132个):在预配置的运行环境中完成核心代码逻辑的编写
- 全生命周期任务(Full-Lifecycle, 92个):要求智能体自主完成环境配置、Dockerfile 编写及容器化服务部署
评测流程
评测流程在智能体工作空间与服务验证环境之间实施严格隔离,具体包括以下阶段:
- 开发阶段:智能体探索仓库结构、修改源代码、安装项目依赖、生成 Docker 配置文件
- 构建阶段:评测系统基于智能体生成的产物构建 Docker 镜像
- 部署阶段:在隔离容器环境中启动后端服务
- 验证阶段:通过外部 API 级别的集成测试验证服务功能正确性
任务仅在已部署服务正确启动并在外部请求下表现出预期行为时判定为通过。
实验评估
实验配置
我们采用 OpenHands 作为标准化智能体框架,对以下模型进行系统评估:
闭源模型:Claude Sonnet 4.5、GPT-5、Gemini 2.5 Pro
开源模型:Qwen3 系列(8B、32B)、Qwen3-Coder(30B-A3B、480B-A35B)、DeepSeek-V3.2、GLM 4.7、Nex-N1(32B、671B)
每个模型-智能体组合对每个任务执行三次独立运行,以确保结果的统计可靠性。
主要结果
| 模型 | 整体 | Python | Go | JavaScript | Java | Ruby | C# | PHP | Rust |
|---|---|---|---|---|---|---|---|---|---|
| Claude Sonnet 4.5 | 63.2 | 73.3 | 75.9 | 69.3 | 67.6 | 51.5 | 46.5 | 74.7 | 33.3 |
| DeepSeek-V3.2 | 50.1 | 56.7 | 64.4 | 57.0 | 57.8 | 42.4 | 38.8 | 48.5 | 0.0 |
| GPT-5 | 49.4 | 30.0 | 56.9 | 46.5 | 67.6 | 55.6 | 36.4 | 44.4 | 41.7 |
| Qwen3-Coder-480B | 43.1 | 56.7 | 55.2 | 57.0 | 52.9 | 36.4 | 24.0 | 36.4 | 16.7 |
| Nex-N1-671B | 42.1 | 60.0 | 63.2 | 49.1 | 54.9 | 30.3 | 26.4 | 34.3 | 0.0 |
| Qwen3-8B | 8.3 | 26.7 | 5.7 | 21.9 | 3.9 | 7.1 | 4.7 | 1.0 | 0.0 |
表2:ABC-Bench 评测结果(平均 pass@1,%)。表现最优的 Claude Sonnet 4.5 仅达到 63.2%,小规模模型难以突破 10%。
核心发现
发现一:全生命周期任务对所有模型均构成显著挑战
即使表现最优的 Claude Sonnet 4.5 也仅达到 63.2% 的 pass@1 准确率,表明该领域仍存在较大提升空间。全生命周期工程任务涵盖环境配置、依赖管理和功能部署等多个维度,其挑战本质不同于孤立的代码生成任务。
发现二:模型普遍缺乏跨语言鲁棒性
不同编程语言栈上的性能表现差异显著。Rust 语言构成关键性能瓶颈,多数模型(包括 DeepSeek-V3.2)在该语言上的成功率为 0.0%。仅 Claude Sonnet 4.5 与 GPT-5 展现出有意义的 Rust 处理能力(分别为 33.3% 和 41.7%)。
发现三:环境配置是性能瓶颈的主要来源
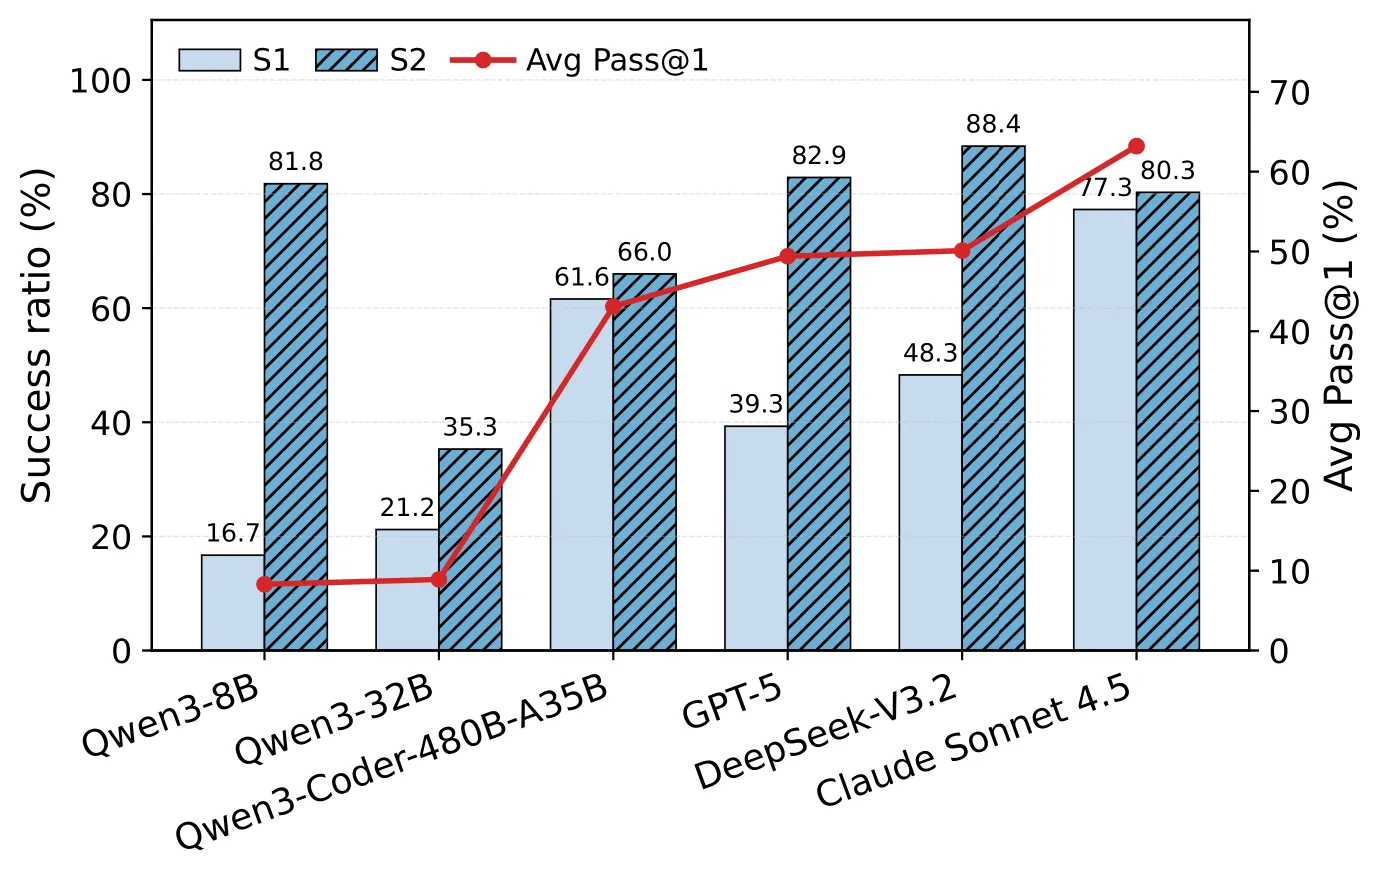
Figure 4: 环境配置能力分析。S1 表示镜像构建成功率;S2 表示在通过 S1 的任务上的功能测试成功率。
将 92 个环境相关任务分解为环境构建(S1)与功能执行(S2)两个独立阶段进行分析,揭示了显著的性能不对称模式:
| 模型 | S1(构建成功率) | S2(功能成功率) |
|---|---|---|
| Claude Sonnet 4.5 | 77.3% | 80.3% |
| GPT-5 | 39.3% | 82.9% |
| DeepSeek-V3.2 | 48.3% | 88.4% |
| Qwen3-8B | 16.7% | 81.8% |
GPT-5 和 DeepSeek-V3.2 呈现明显的阶段性能不对称:尽管 S2 阶段成功率超过 80%,但 S1 阶段成功率不足 50%。这一结果表明,环境配置能力而非代码逻辑能力是制约整体性能的主要瓶颈,当前评测方式在一定程度上掩盖了模型的算法推理能力。
发现四:交互深度与任务成功率呈强正相关
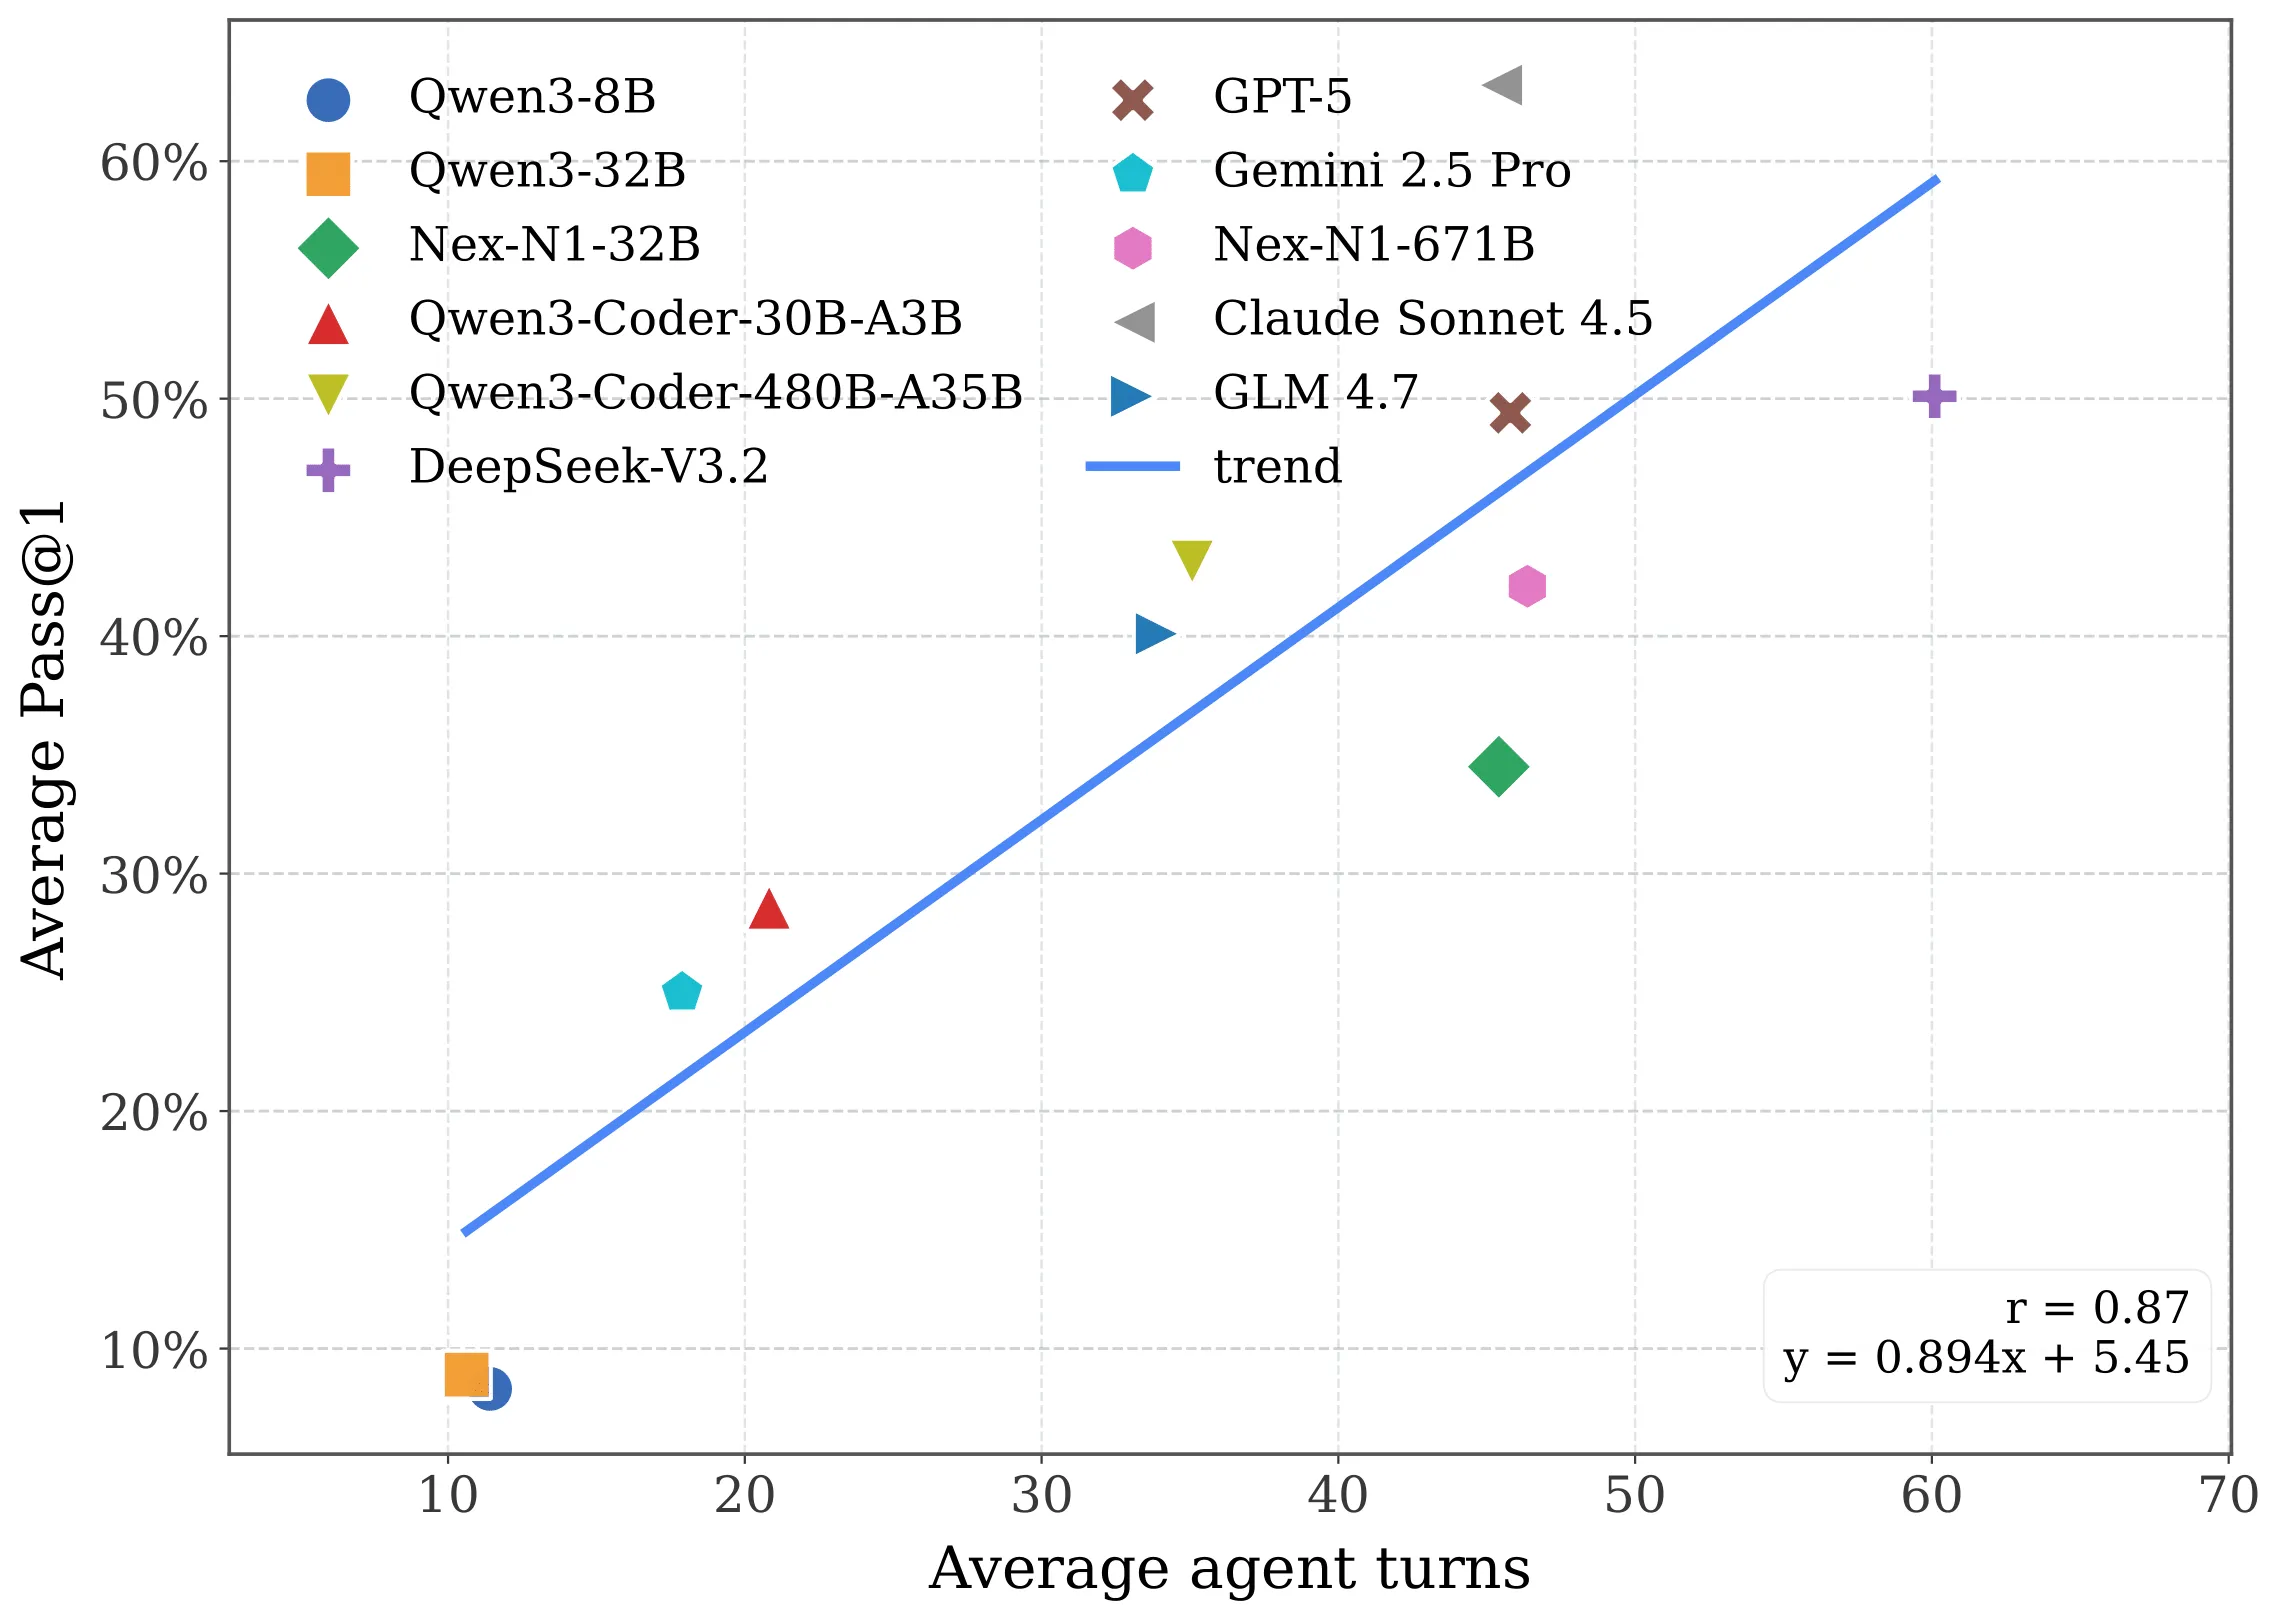
Figure 5: 智能体交互轮次与 pass@1 准确率的关系分析。皮尔逊相关系数 r = 0.87。
高性能模型倾向于维持更长的执行轨迹(Claude Sonnet 4.5:平均超过 60 轮交互),而低性能模型则倾向于过早终止任务(Qwen3-8B:约 10 轮)。这一现象表明,全生命周期任务的成功完成依赖于迭代式探索、错误信息解析和多轮调试的能力。
深入分析
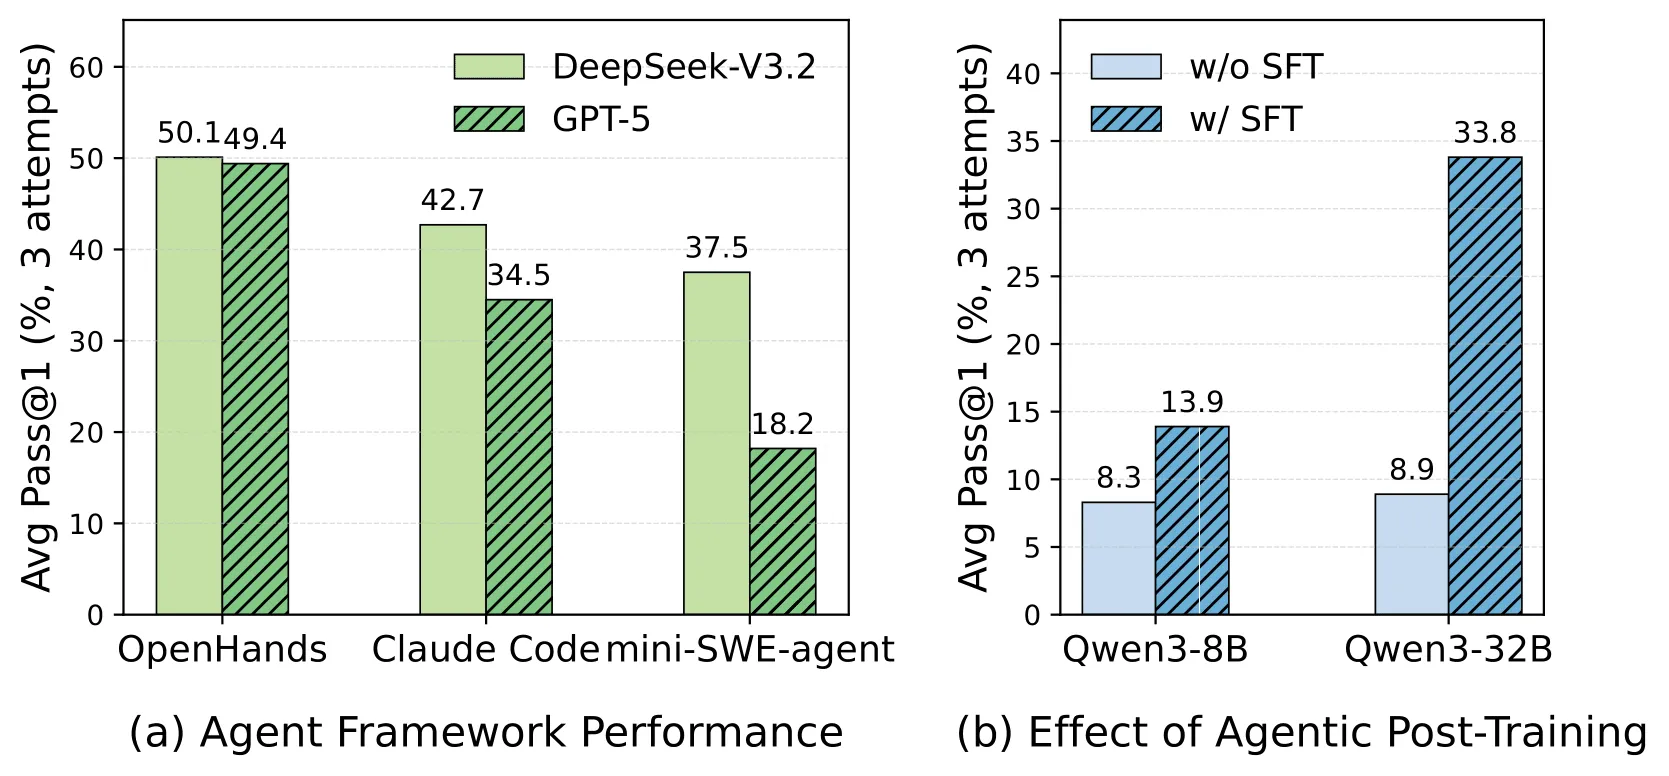
Figure 6(a): 不同智能体框架的性能对比。Figure 6(b): 智能体风格监督微调(SFT)对 ABC-Bench 性能的影响。
智能体框架的影响
智能体框架的选择对最终性能具有显著影响。OpenHands 框架使两个模型均达到最优表现,而 mini-SWE-agent 框架将 GPT-5 的成功率降至 20% 以下。该结果表明,ABC-Bench 评估的是完整智能体系统的能力,框架层面的交互策略设计与底层模型能力同等重要。
智能体后训练的效果
在智能体编码轨迹数据上进行监督微调可带来显著性能提升:Qwen3-8B 的 pass@1 准确率从 8.3% 提升至 13.9%,Qwen3-32B 从 8.9% 提升至 33.8%。实验结果表明,较大规模模型在后训练阶段展现出更高的数据利用效率。
错误类型分析
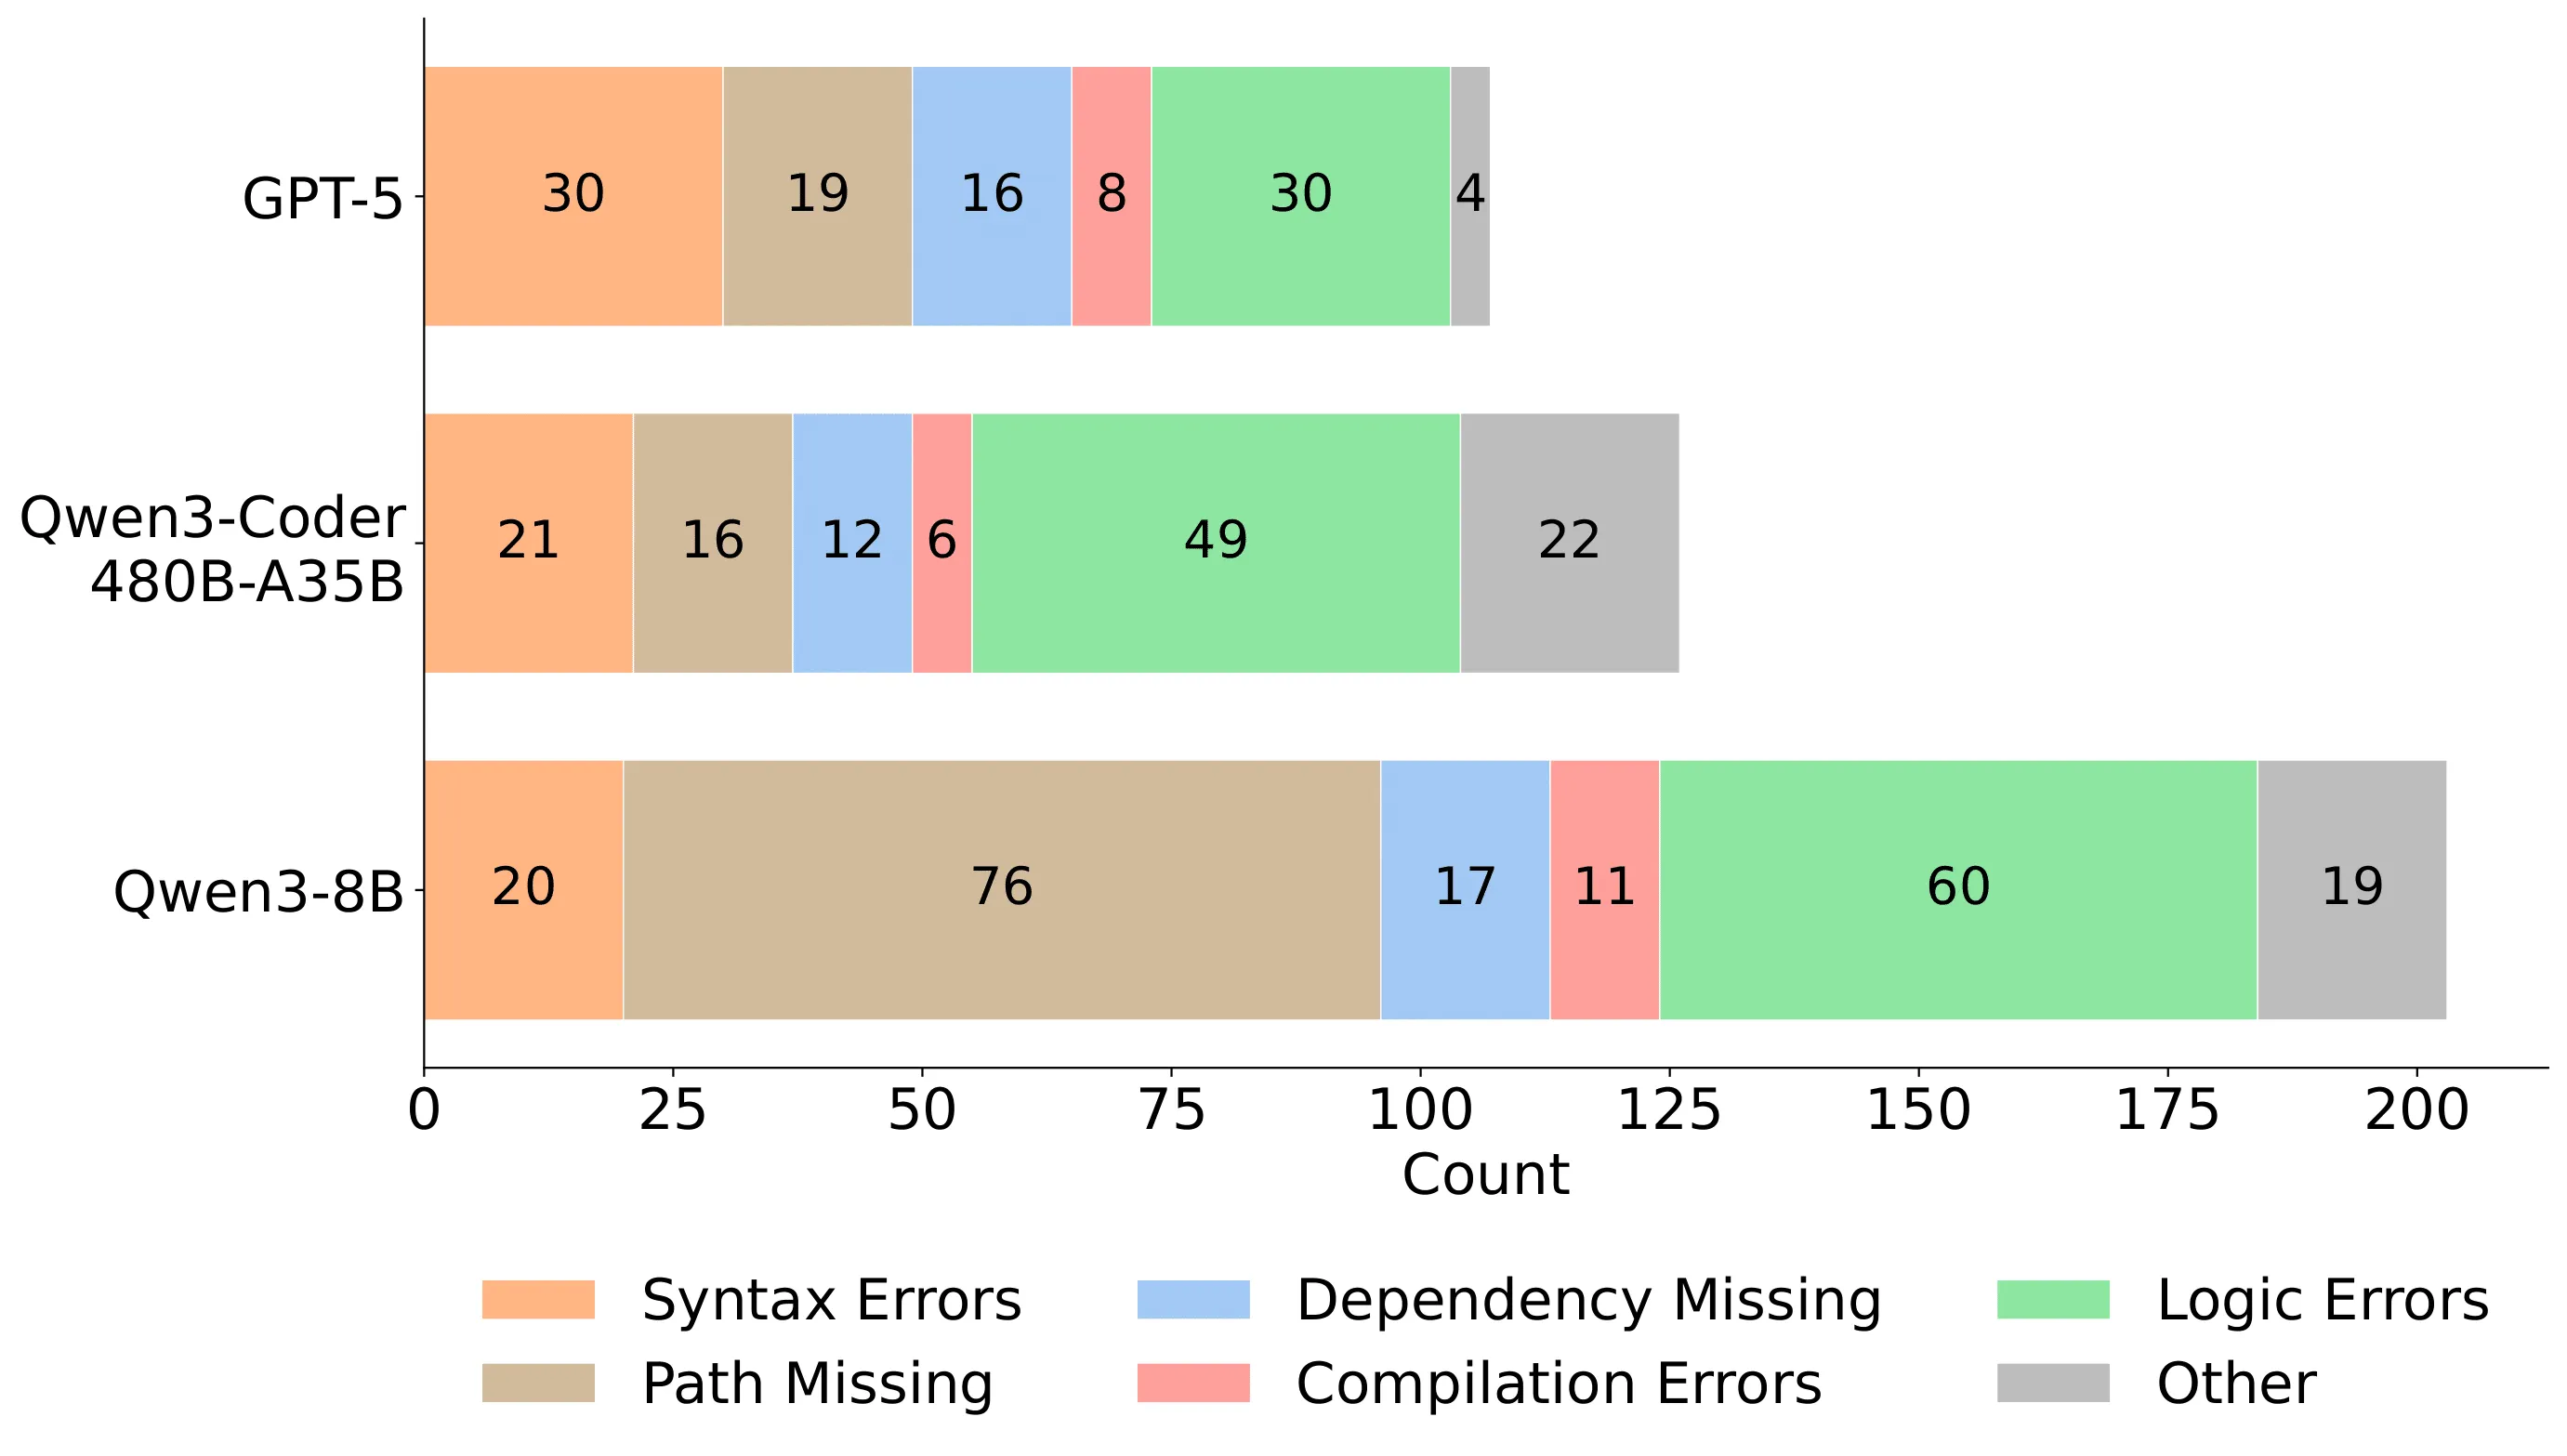
Figure 8: 不同模型的错误类型分布。环境相关错误(路径缺失、依赖缺失)是贯穿各能力水平模型的持续性挑战。
对错误类型的系统分析揭示了不同规模模型的失败模式差异:
| 错误类型 | Qwen3-8B | Qwen3-Coder-480B | GPT-5 |
|---|---|---|---|
| 路径缺失 | 76 | 17 | 19 |
| 依赖缺失 | 16 | 8 | 16 |
| 语法错误 | 20 | 12 | 30 |
| 逻辑错误 | 60 | 49 | 30 |
上述数据呈现两个关键模式:
-
环境配置构成普遍性瓶颈,但严重程度随模型能力呈负相关。小规模模型在基础性路径缺失错误上表现尤为薄弱。
-
错误复杂度与模型规模正相关。随着模型在语法和编译层面能力的提升,主要失败模式逐渐转向逻辑错误,表明挑战前沿正从实现机制层面转向算法推理层面。
任务领域分析
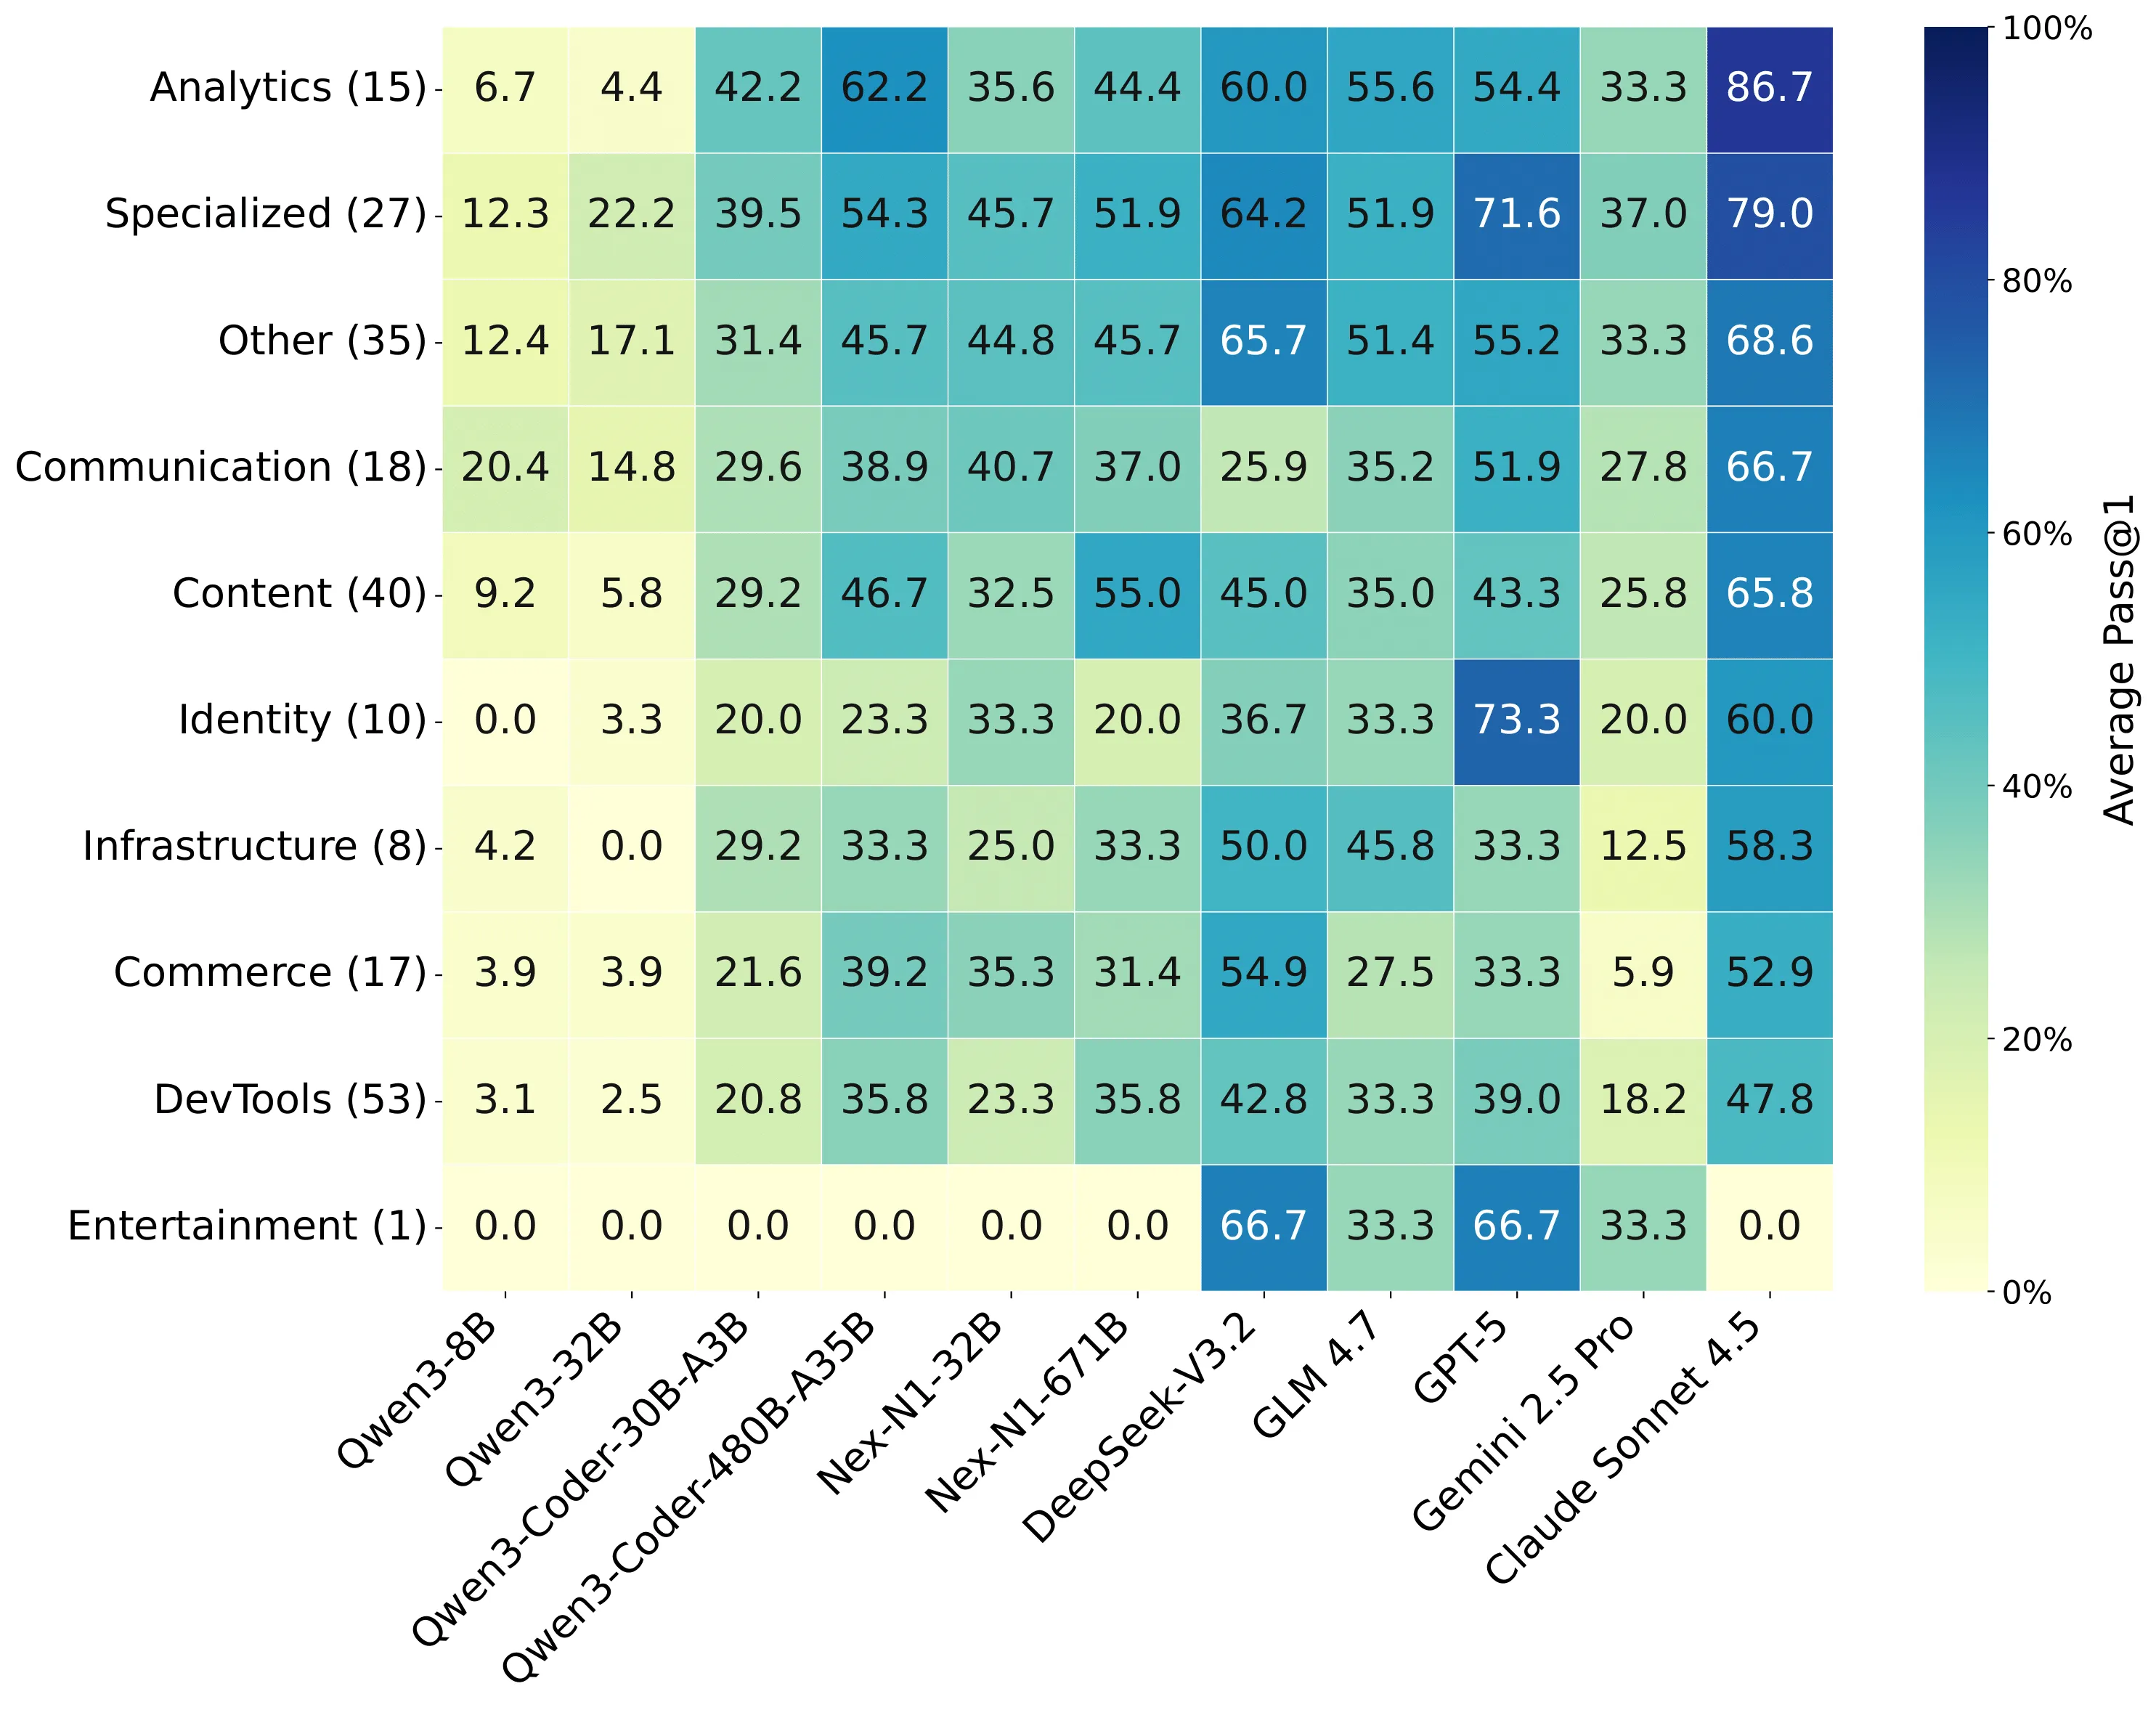
Figure 7: 不同任务领域与模型组合的 pass@1 准确率热力图。开发者工具(DevTools)类任务对所有模型均构成显著挑战。
跨应用领域的性能分析揭示以下规律:
- 数据分析(Analytics) 类任务成功率最高(Claude Sonnet 4.5:86.7%)
- 开发者工具(DevTools) 作为最大任务类别(N=53),对所有模型均构成挑战(全部低于 50%)
- 存在领域特定的性能差异:GPT-5 在身份认证(Identity)任务上优于 Claude Sonnet 4.5(73.3% vs 60.0%)
结论
ABC-Bench 构建了一个严格的评测框架,用于系统评估基于大语言模型的智能体在完整后端开发生命周期中的工程能力。我们的主要贡献如下:
-
全生命周期评测基准:包含 224 个工程任务,覆盖 8 种编程语言和 19 个主流框架,要求智能体自主完成仓库探索、环境配置、服务部署及 API 功能验证
-
关键能力瓶颈识别:实验表明,环境配置与服务部署是当前智能体的主要能力短板,往往在代码逻辑验证之前即阻断任务执行
-
全面的基线评估:对多种模型与框架组合的系统评估揭示了当前智能体能力与生产级需求之间的显著差距
上述发现表明,提升后端编程智能体的整体能力需要在环境推理与系统工程知识方面进行针对性研究投入,以补充代码生成能力的持续改进。