Skill-JIT:让 Agent 边做边学,边学边沉淀
- 开源仓库 👉 https://github.com/china-qijizhifeng/Skill-JIT
- 一句话简介 🌟 Skill-JIT 是一个 Claude Agent 插件(🦞 兼容 OpenClaw),帮助 Agent 在需要时调研并生成可复用的技能(Agent Skills)。
- 一键安装 🏠
# Claude Code
claude plugin marketplace add china-qijizhifeng/Skill-JIT
claude plugin install skill-jit@skill-jit-marketplace

# OpenClaw
openclaw plugins install skill-jit --marketplace china-qijizhifeng/Skill-JIT
研究动机
最近我养了一只小龙虾(OpenClaw)。接了个开源模型,想让它帮我管点日常杂事——盯着 GitHub notifications、定时做点重复的运维之类的。
只可惜,第一个任务就翻车了。你现在看到的这个博客就是用 Dioxus 开发的(别问为什么,问就是 btw, I use Rust)。我在集群里维护了一套公共环境,每次 Dioxus 更新后都要升级一遍。我们集群有个特点:系统自带的 glibc 版本比较低,也不太方便升级,所以每次都得用 musl 来静态编译 OpenSSL,再链接到 Dioxus 的构建链里。这套流程说不上多难,但步骤不少,挺适合交给 Agent 来干的。结果呢,模型每次都坚持用系统自带的 glibc 去链接,编译失败了也不知道怎么解决,就在那反复重试,换各种编译参数碰运气。我手动教它一遍 musl 的流程,它总算搞定了。下次 Dioxus 更新,同样的活,新 session,又从 glibc 开始试起,又挂。
除了 OpenClaw 场景,类似的事情也反复发生。我用 Zig 写一个小工具,Zig 语言本身还在快速演进,语法和标准库都还不稳定。模型写出来的代码总是旧版语法,编译不过,而且它自己修不好——满脑子都是旧的那套,怎么改都绕不出来,每次都得我手动让它去查最新的 language reference。查完改对了,下次写新函数又用回旧语法。
还有一个更头疼的场景:我们内部有好几个迭代很快的项目——API 隔三差五就变。让 Agent 帮忙写点对接代码,它用的是上周的接口签名,调用直接报错。每次它都要重新去查最新的源码或文档看看哪些接口改了,一查又烧掉了不少 token。
除了知识过时,模型写代码的一些坏习惯也很烦人。比如它特别喜欢无脑加 try-catch,把每个操作都包一层,catch 里面只打个 log 就继续往下走。表面上跑得好好的,不报错,但实际上关键步骤早就失败了,错误全被吞掉了。你还得自己一层层把 try-catch 拆开,才能找到真正的问题在哪。教过一次"别这么写",下次照旧。
真正让人崩溃的是:这些坑,换个 session 全部要重新踩一遍。musl 编译流程要重教,Zig 照样写旧语法,内部 API 照样用过期接口,try-catch 照样满天飞,让用 uv 管理 Python 环境过了几轮就直接写 python xxx.py 了(找不到 Python 他还知道试试 python3 xxx.py),让用 conda 装包老用 apt 直接装到系统里...昨天踩的坑、我手把手教的正确做法,全没了。
每天训小猫分辨萝卜和纸巾,或许就是这种感觉,令人感慨——
不是模型笨,是系统没给它一个「学会了就记住」的机制。
这个方向上有一个现成的切入点:Agent Skills。Skill 是一份操作手册,告诉 Agent 碰到某类任务该怎么干——调哪些工具、按什么顺序、哪些地方容易踩坑,把能力编排好,让它不用每次都从零摸索。
听起来不错,但实际用下来,Skill 生态也有自己的问题:
- 找 Skill 很麻烦。 社区里有近百万个 Skill,但搜索和分类做得很粗糙,找到你真正需要的那个全靠运气。
- 找到了也不一定能用。 别人的 Skill 可能是在 Ubuntu + Podman 环境下写的,你是 Windows + Docker,拿来就不对。况且同一个 Skill,不同模型的理解和执行效果也不一样,可移植性本身就存疑。
- 给了 Skill 模型也不一定听。 这是最头疼的。模型经常无视已有的 Skill,按自己的认知来;或者装了个新 Skill 以后,原来好好的那个反而不触发了。
所以我想,与其在一堆不匹配的 Skill 里翻找,不如让模型自己去调研,根据当前的环境量身写一个。它也可以去看看别人的 Skill 是怎么写的,集百家之长,再生成一个适合自己的。
这就是 Skill-JIT 想做的事。
Skill-JIT 方法
为什么叫「JIT」?
JIT(Just-In-Time)本来是编程语言里的概念:代码不提前编译,而是在运行时按需编译成机器码,编译一次后缓存起来,下次直接用。
Skill-JIT 做的事情类似,只不过「编译」的对象从代码变成了知识:
- 传统做法:把所有知识塞进 system prompt 或预写好一堆 Skill → context 维护成本高,还容易过时
- Skill-JIT 做法:平时不管,碰到不会的任务再临时调研 → 把调研结果「编译」成一个 Skill → 缓存起来,下次直接加载,并在需要时更新
说白了就是:边做边学,边学边沉淀
整体架构
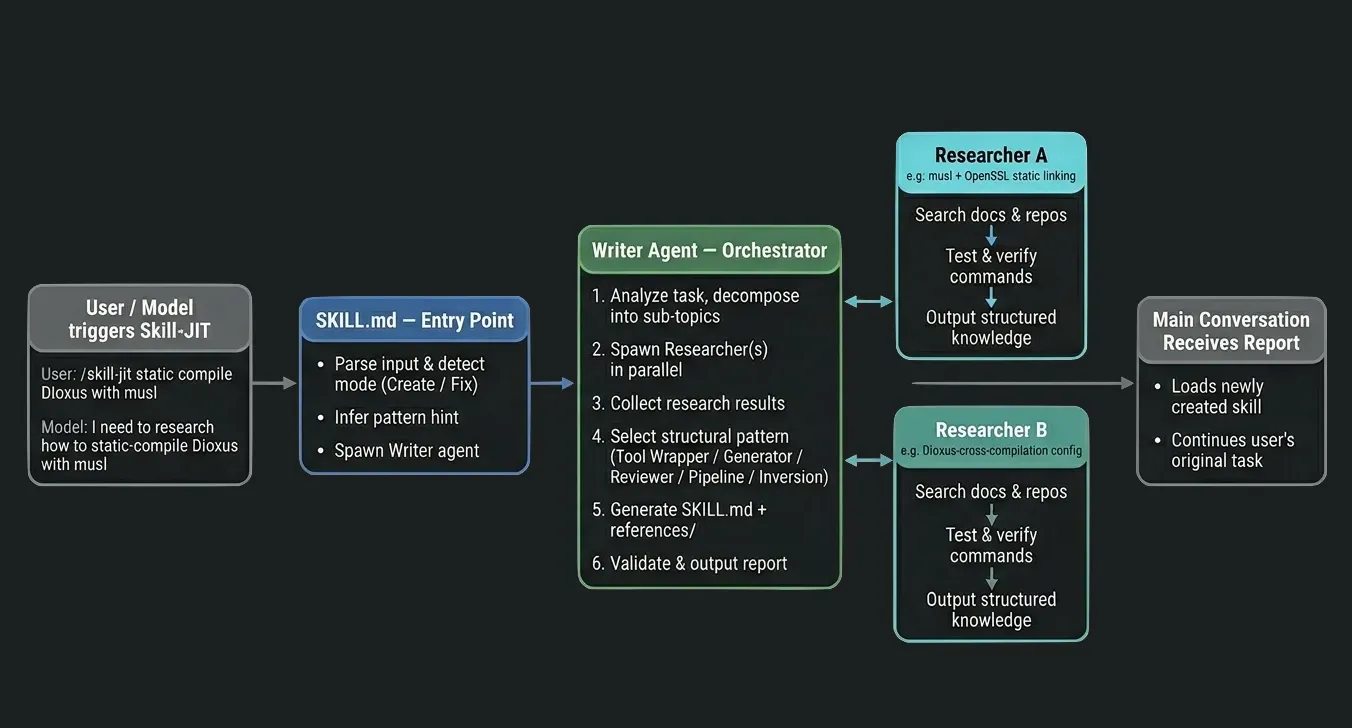
Skill-JIT 插件本身包含一个技能和两个子智能体。技能本身也叫 skill-jit,用户可以通过斜杠指令 /skill-jit <描述> 来触发,模型也能在遇到需要调研的任务时自动触发。加载 skill-jit 后,模型会启动 Writer(技能作者)子智能体来编写技能。收到编写技能的任务后,Writer 会根据需要派出 Researcher(调研员)子智能体来查资料,最后结合调研结果和插件提供的技能设计模式,生成一个新的技能。任务复杂时,Writer 智能体还会把技能拆成多个子技能,分别调研、编写。整体工作流如下如所示:
Writer:技能作者
Writer 是把知识「编译」成 Skill 的核心智能体。核心原则叫 Explicit by Default(默认显式)——Skill 要写得足够明确,任何模型都能一步步照着做,不需要猜。每一步都写清楚做什么、怎么做、怎么验证做对了。
具体来说,每个步骤都遵循 What → How → Verify 三段式:
- What 说清楚目标,没有歧义
- How 给出可直接执行的命令
- Verify 提供可检查的成功标准,模型知道自己做没做对
当然,某些时候确实存在需要「根据情况判断」的场景,为此,我们要求 Writer 还会讲清楚每一步为什么这么做。这样即使具体参数变了,模型也能根据原理去适应。
另外,不同类型的任务天然适合不同的 Skill 结构。Writer 会根据任务性质选择结构模板,我们参考 Google Cloud 总结的 Agent Skill 设计模式,内置了五种:
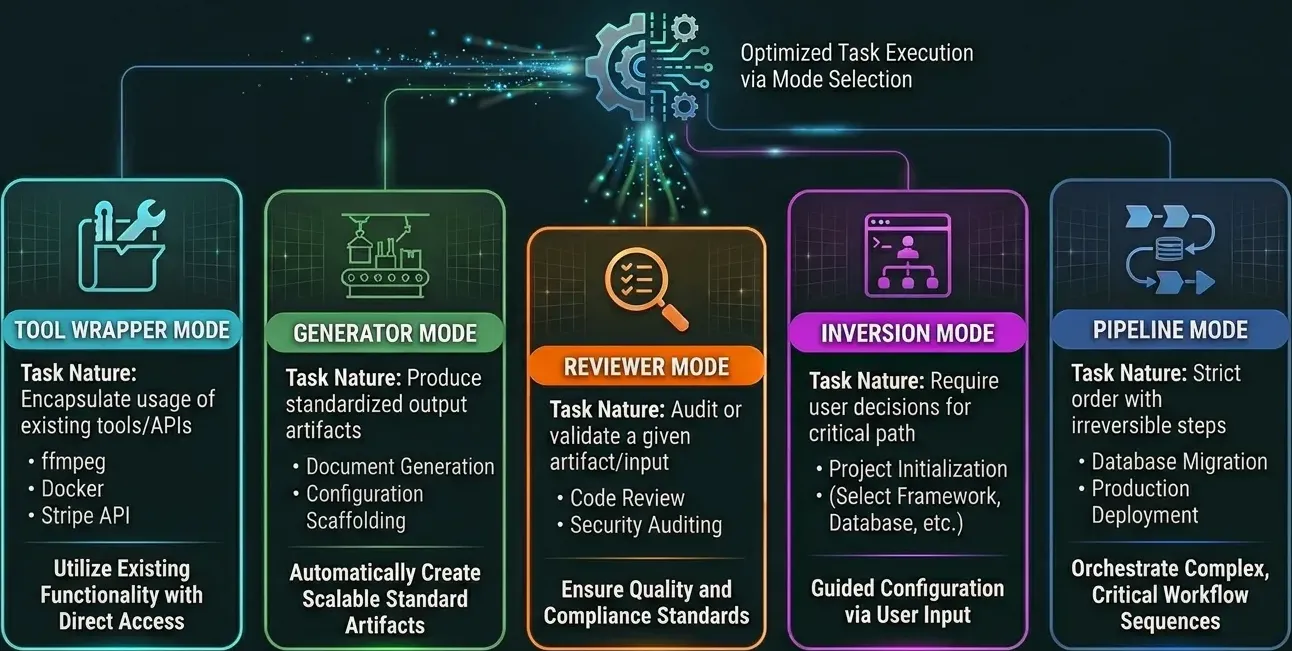
这些模式也可以组合。比如"项目脚手架"就是 Inversion(先问用户要什么)+ Generator(按模板生成),"带审查的部署流程"就是 Pipeline + Reviewer。
Researcher:调研员
Writer 会按需派出 Researcher 调研员。调研范围没有限制——CLI 工具、API、编程语言、框架、内部项目,什么都能查。除了 Claude 自带的搜索功能,我们还为 Researcher 预置了 context7、DeepWiki 和 GitMCP 工具,同时提示它从社区的其他 Skill 中获取灵感。Researcher 不会盲目相信搜索得到的信息,他还会在可能的情况下直接运行有关的脚本来实验,保证生成的 Skill 在本地环境中能可靠运行。
调研完成后,Researcher 会输出一份结构化的知识文档,里面把内容分成三类:稳定的参考资料(直接写进 Skill)、容易过时的资源(只保留查找指针)、可复用的脚本片段。这个分类会直接影响 Writer 后面怎么组织 Skill。
三种工作模式
Skill-JIT 支持三种工作模式:
- Create:从零生成新 Skill。Writer 分析任务、派出 Researcher 调研、生成 Skill 文件。
- Fix:修复已有 Skill。定位出错的步骤,针对性调研和更新,保留没问题的部分不动。
- Dry-Run:预览模式。走完整个流程但不写入文件,先看看效果再决定要不要保存。
纯 Markdown,零构建,零运行时
最后值得一提的是,Skill-JIT 整个插件都是纯 Markdown 文件,没有任何代码需要编译或构建。Agent 定义、Skill 模板、模式参考。因此,虽然我们为 Claude Code 开发,但 Skill-JIT 也基本兼容 OpenClaw,甚至其他未来的 Agent 平台。
使用场景
a. 学习超出预训练知识范围的新能力,纠正模型认知偏差
Motivation 里的几个例子根源都一样:模型预训练时没见过,或者见过的已经过时了。
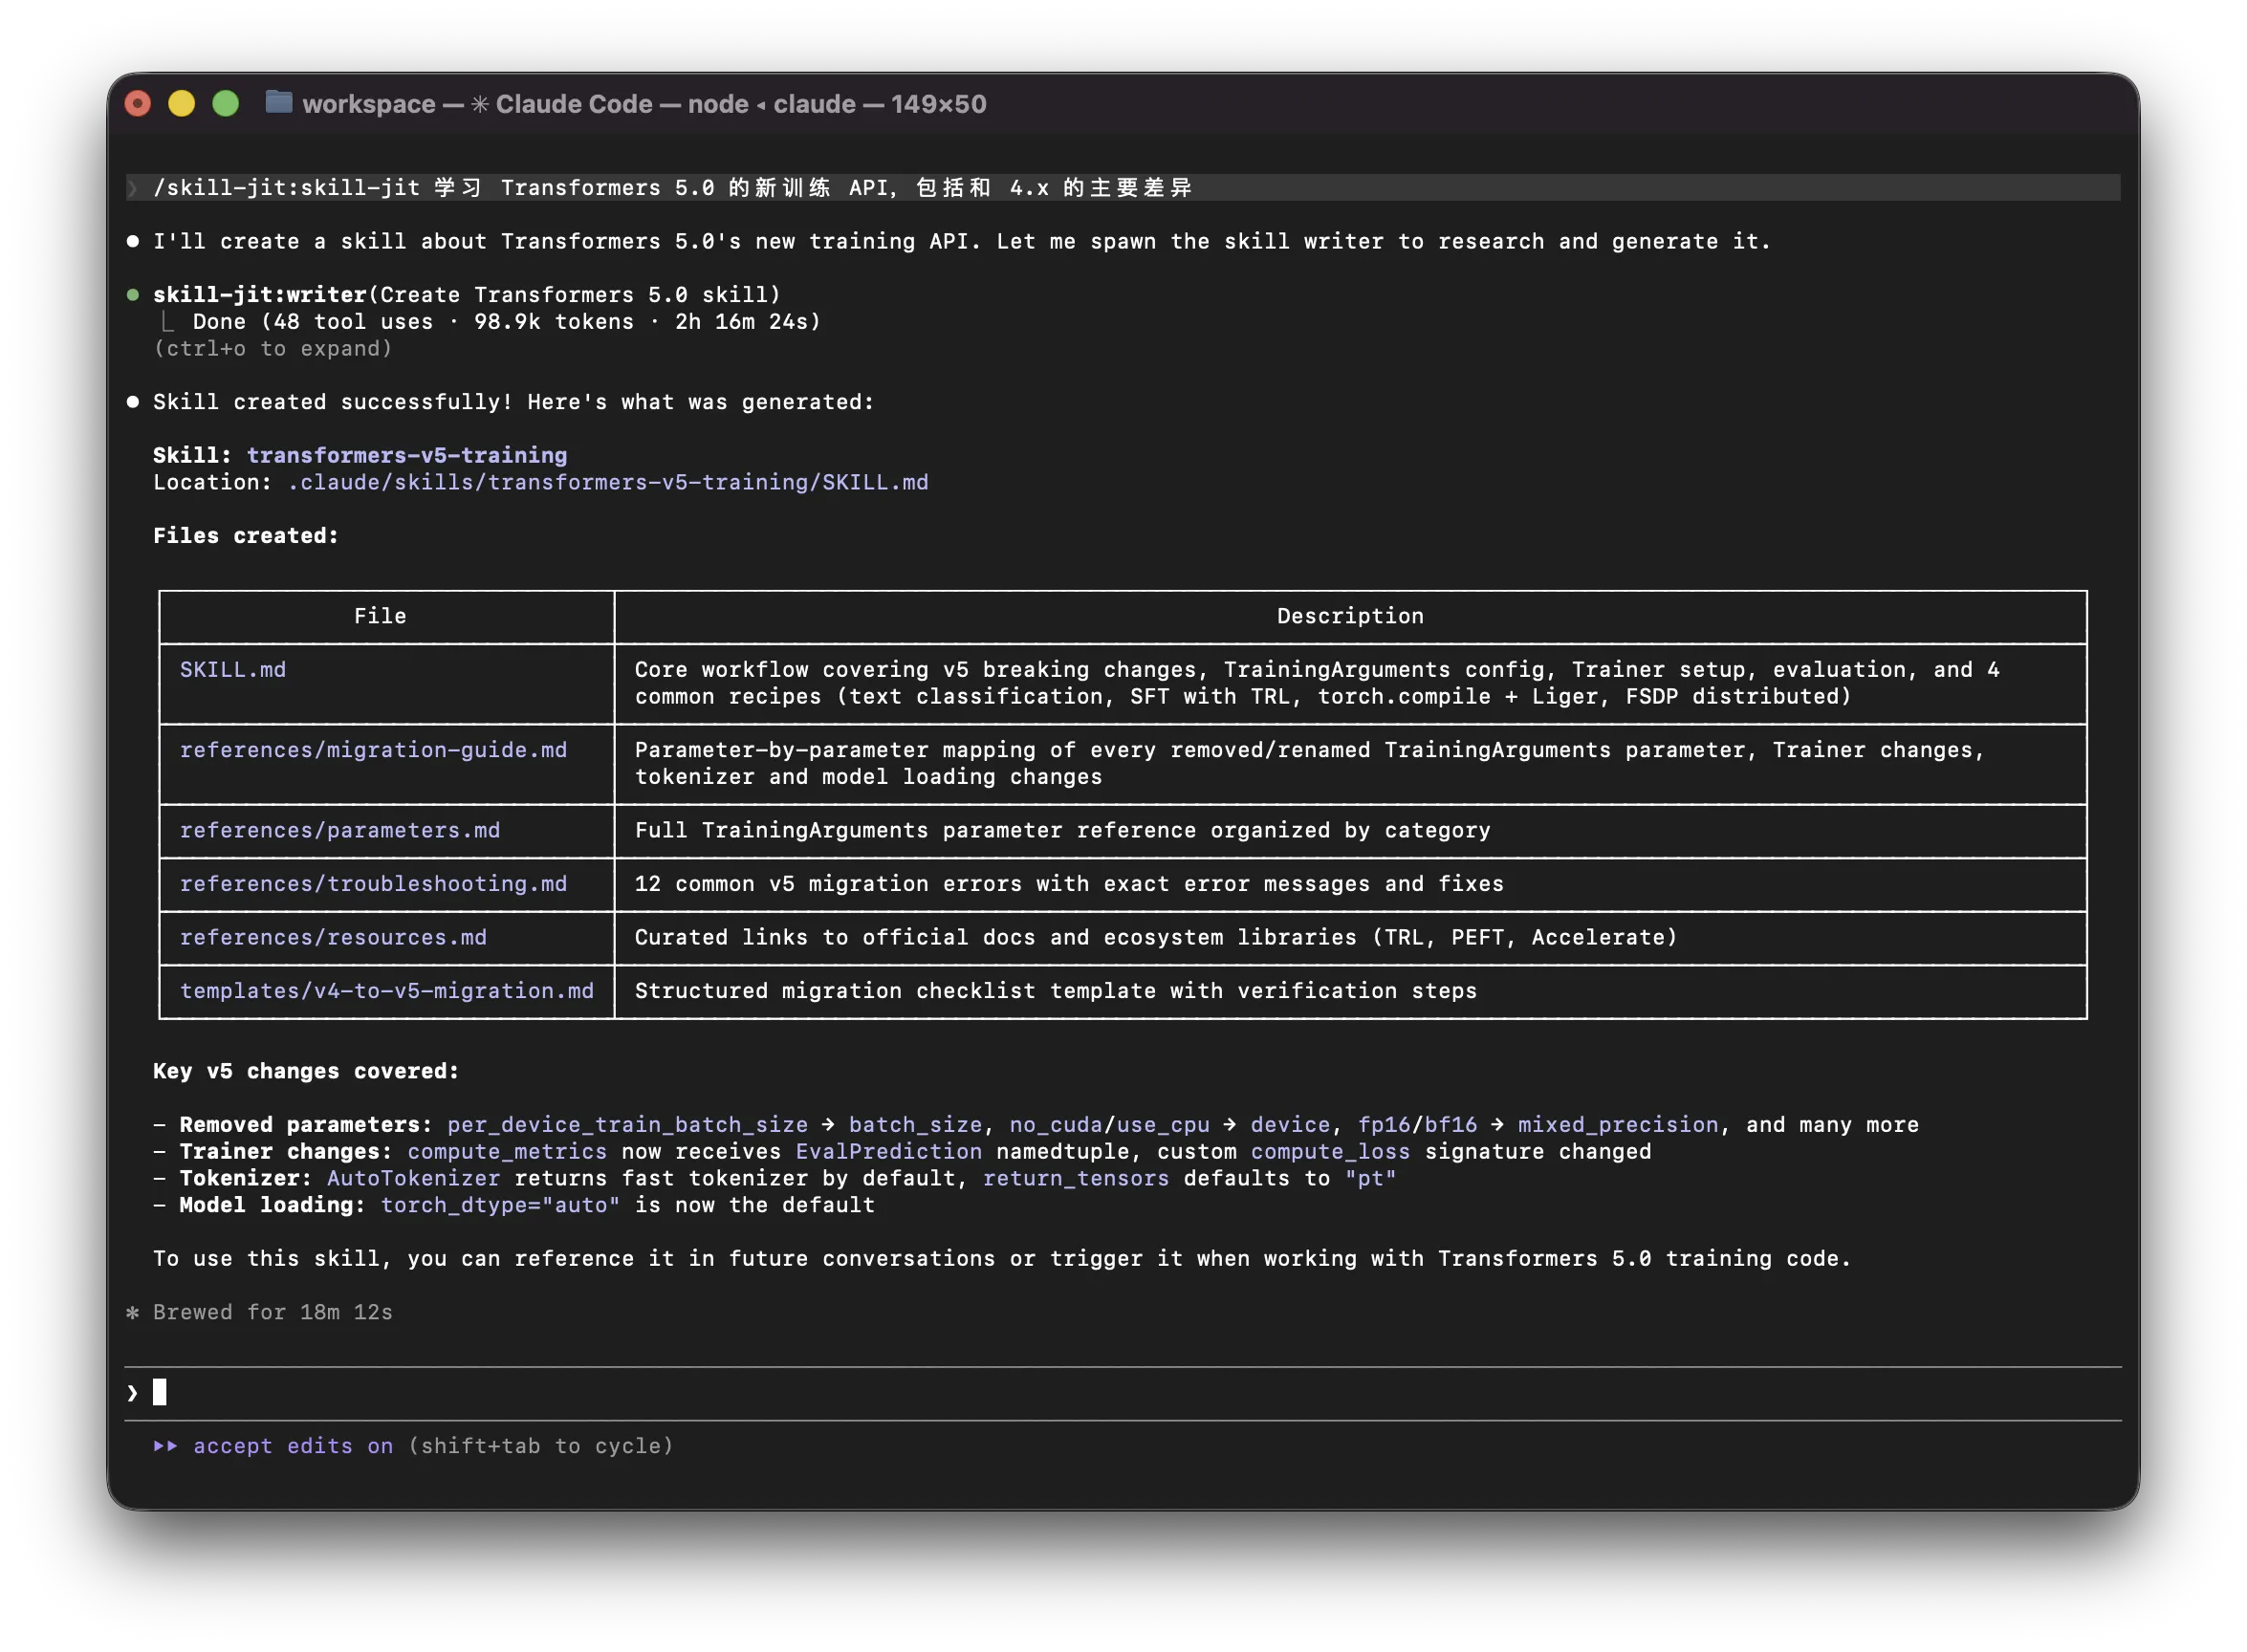
有了 Skill-JIT,碰到这类问题时不需要人工手把手教。比如 Hugging Face transformers 5.0 刚发布,许多 API 都有变化,模型脑子里还是 4.x 那套写法:
/skill-jit 学习 Transformers 5.0 的新训练 API,包括和 4.x 的主要差异
Researcher 会去查官方文档和 migration guide,记录和旧版的关键差异。Writer 把验证过的知识写成 Skill,包括新旧 API 的对照和常见迁移陷阱。下次再碰到 transformers 相关的任务,Agent 加载这个 Skill 就能用正确的 5.0 写法,不会再写出一堆 deprecated 调用。
b. 一次调研多次使用,提升智能体完成重复任务的效率和成功率
Motivation 里反复出现的场景:同样的任务,新 session 要从头来过。Skill-JIT 生成的 Skill 保存在项目的 .claude/skills/ 目录下,跨 session 持久化。第一次花时间调研和生成,之后每次秒加载。
我们拿 Blender 3D 特效做了个实测。第一个任务:「帮我用 Blender 做一个 Nex-N1 的 3D 特效文字动画,要有科技感,做视频片头用。」
不装 Skill-JIT,Opus 也能搞定——先用 WebSearch 和 Context7 查 Blender Python API,再写 bpy 脚本,中间 debug 了好几轮,最终花了 68k token。装上 Skill-JIT 再跑同一个任务,消耗 75k token,反而多了一点——因为这次它不仅完成了任务,还把调研到的 Blender 知识「编译」成了一个可复用的 Skill。
真正的差距在第二次。换一个类似但不同的任务:「用 blender 做一个赛博朋克风(蓝色和紫色故障风)的3D 文字特效视频,标题是"Skill-JIT",副标题是"Let Agents Learn and Persist Skills on the Fly"」这次 Opus 直接加载已有的 Blender Skill,跳过了调研和反复 debug 环节,只用了 48k token。
| 无 Skill-JIT | 有 Skill-JIT(首次) | 有 Skill-JIT(复用) | |
|---|---|---|---|
| 调研环节 | 每次从零查 API | 调研 + 生成 Skill | 直接加载 Skill |
| Token 消耗 | 37k | 44k | 17k |
第一次多花的 7k token 是「学费」,之后每次都是净赚。任务越重复,收益越大。
这个模式也适用于跨模型复用:用 Opus 跑一次 Skill-JIT 生成 Skill,遵循 Explicit by Default 原则,写得足够明确,换一个便宜的小模型来执行也能做对。调研用大模型保证质量,执行用小模型控制成本。
c. 自动维护 Skill,让知识保鲜而不是腐烂
Skill 写完不是终点,而是维护的起点。工具在升级,API 在变,文档在更新——今天能跑的 Skill,过几周可能就挂了。如果 Skill 不能自我修复,最后只会变成一堆过时的操作手册,比没有还糟糕。
这不是假设。2025 年 8 月,OpenAI 宣布废弃 Assistants API,要求所有用户在 2026 年 8 月前迁移到全新的 Responses API。这不是小修小补——Threads 变成了 Conversations,Runs 变成了 Responses,连对话管理的心智模型都换了。如果你之前用 Skill-JIT 生成了一个基于 Assistants API 的对接 Skill,里面的创建线程、轮询运行状态等步骤会直接失效。但 Skill 里关于 prompt 设计、错误处理、重试逻辑的部分都还是对的——坏掉的只是 API 调用那几步。
类似的事情在 2025 年下半年密集发生。Next.js 16 把 v15 中临时保留的同步请求 API 兼容层彻底移除,params 和 searchParams 必须 await,缓存行为也再次调整——之前不缓存的页面现在缓存了,之前缓存的反而不缓存了。Terraform AWS Provider v6 更是一次大清洗:16 个 OpsWorks 资源整个删掉,布尔值不再接受字符串 "1"/"0",部分默认值静默翻转——Redshift 集群的 publicly_accessible 从 true 变成 false,encrypted 从 false 变成 true。
传统做法是发现 Skill 过时了就整个删掉重写。但这些 Skill 里大部分步骤可能还是对的——OpenAI 对接的认证和错误处理逻辑没变,只是 API 端点和对象模型变了;Next.js 的路由结构和组件设计没变,只是数据获取方式需要加 await;Terraform 的整体部署流程没变,只是某几个资源参数需要调整。
Skill-JIT 的 Fix 模式就是为此设计的。当 Agent 按 Skill 执行时某一步失败,Fix 模式会自动介入:
- 定位:根据报错信息,精确锁定 Skill 中失败的步骤
- 调研:Researcher 只针对出错的部分去查——翻 changelog、读 migration guide、在本地实际跑一遍确认新写法能用
- 修复:Writer 只更新受影响的步骤,其余部分原封不动,版本号自动 patch bump(如 0.1.0 → 0.1.1)
整个过程不需要人工介入。Skill 不是写一次就丢在那里等着腐烂的静态文件,而是会在使用中自动维护的活文档。 每一次失败都是一次进化——Skill 越用越准,Agent 越用越聪明。
开发 Skill-JIT
2025 年下半年,智能体记忆是个很热的研究方向——怎么让 Agent 积累经验,不至于每次都从零开始。学术界提了不少方案,但大多停留在论文里,真正在生产中大规模落地的很少。问题在于,能落地的方案必须兼容现有的各种智能体框架,而不是要求用户换一套全新的基础设施。年底 Agent Skills 标准的发布和 OpenClaw 的爆发让我看到了契机:Skill 本身就是各大平台已经支持的标准格式,不需要改框架,只需要在上层做文章。如果能让 Agent 自己生成和维护 Skill,那就等于在现有基础设施上加了一层可持久化的经验记忆。
最初的版本很糙——就是在 prompt 里告诉模型"去调研,然后写个 Skill"。很快就发现不行:模型的调研不够深入,写出来的 Skill 质量参差不齐,有些步骤根本没验证过就写上去了。于是我开始认真研究怎么写好一个 Skill。Anthropic 官方的 Skill 设计指南和 Agent Skills 标准是基础,但光看官方文档不够——社区里已经有近百万个 Skill,大量实战经验值得借鉴。一开始我只想到让 Agent 调研 CLI 工具、依赖库之类的使用方式,后来看到 Google Cloud 总结的五种 Skill 设计模式,才决定吸纳进来,这就有了后来的 Pattern-Aware 生成。
开发过程本身就挺 meta 的——用 AI 来开发一个教 AI 学习的工具。整个过程中有三个角色配合:我负责定方向、读文档、做设计决策;Claude Opus 负责写核心 prompt 和设计测试用例;Nex-N1 负责批量调研社区 Skill 的写法并总结优秀经验,同时作为验证对象,测试生成的 Skill 好不好用。之所以让 N1 来跑社区调研,是因为量太大了,我不可能自己一个个看,Opus 又太贵,N1 刚好合适。
测试的时候我让 Opus 出题去考 N1,如果 N1 做不出来,就让它借助 Skill-JIT 生成一个 Skill 再试。这样能直接验证生成的 Skill 到底有没有用。结果发现 N1 其实很善于自己去找答案,反倒是 Opus 经常低估它的实力。还有个有趣的事:写 Skill-JIT 的 Writer prompt 时,我给 Opus 启用了 Anthropic 官方的 skill-writer 技能来辅助。而 Skill-JIT 做完以后,本身就相当于 skill-writer 的加强版——算是某种自举吧。
得益于 Opus 和 N1 的能力,初版只用了一两天就写完了。不过这是工作和科研之余的项目,后续打磨花了一个多月,主要是 Pattern-Aware 生成、Fix 模式和各种边界情况的处理。
局限性与下一步
说到底,Skill-JIT 只是一个很小的改进。它解决的是"怎么让 Agent 把经验沉淀下来"这一个环节,但可持续进化的 Agent 是一个从模型到框架的全栈系统工程,远不是一个插件能搞定的。
往下看模型层:模型需要具备"遵循外部指令优先于自身认知"的能力——给了 Skill 就按 Skill 来,而不是按自己预训练时学到的(往往已经过时的)认知去干活。目前大部分开源模型在这方面的训练还不够,Skill 写得再好,模型不听也白搭。
往上看框架层:智能体框架怎么设计 Skill 的加载、触发和优先级机制,怎么在 Skill 之间做冲突仲裁,怎么在不膨胀上下文的前提下让模型"看到"最相关的 Skill——这些都是框架需要解决的问题,不是 Skill-JIT 能管得了的。
这两层加起来才是一个完整的闭环:生成 Skill、正确加载和触发、可靠地遵循执行、出了问题自动修复。因此,我们正在为新的模型训练相关能力,特别是通过专门的训练来提升模型对 Skill 的遵循和使用能力,目标是让 Agent 在 OpenClaw 等场景下真正做到「越用越聪明」。敬请期待~
作者备注
- 我没有训过小猫分辨萝卜和纸巾。
- 我也没有养过小龙虾(Procambarus clarkii)。
- 我终于把「技能 Agent 之歌」找了个地方发出来了(x
传统的 Agent 是把工具调用连成一条线👈😠👉,好无趣🎵,好无聊🎶,而技能 Agent💪,就是在传统的 Agent🤔,加入技能——好好玩⚡️(要爆了🤯)。
参考资料
- Agent Skills: 开放的 Agent Skill 标准,最基础的定义。
- Agent Skills 概览 - Claude API Docs: Claude Agent Skills 官方文档,展示了 Anthropic 对 Skill 最初的理解与设计。
- Agent Skills 最佳实践 - Claude API Docs: Anthropic 对如何编写有效的技能的建议。Skill-JIT 在设计时参考了这些内容。
- 5 Agent Skill design patterns every ADK developer should know - @GoogleCloudTech - X: Google Cloud 对 Agent Skill 设计的五大 Agent Skill 设计模式总结。
- 使用 skills 扩展 Claude - Claude Code Docs: Claude Code 对 Agent Skills 的实现,包含一些通用标准里没有的特性,比如动态字符串替换、参数传递、动态上下文注入和上下文分支等。
- 创建插件 - Claude Code Docs: Skill-JIT 的开发参考了这个文档。OpenClaw 不一定支持这里的全部特性。
@misc{2026-skill-jit,
  title   = {Skill-JIT Let Agents Learn and Persist Skills on the Fly},
  author  = {Honglin Guo in collaboration with others at Dawning Road},
  year    = {2026},
  url     = {/blog/skill-jit/},
  note    = {Blog post},
  urldate = {2026-10-24},
}