NexRT:超低延迟大模型解码引擎
面向低延迟 1-batch 推理的定制 CUDA 内核与完整解码 CUDA Graph。
NexRT 是由上海奇绩智峰的 NEX 团队 打造的通用 LLM 解码引擎。该引擎的设计目标是在受支持的模型上支持普通解码、MTP 和 DFlash;当前实现专门针对 Nex-N2.5-Pro 优化,重点是降低 batch size 为 1 时的延迟。
在 batch size 为 1 时,每一次内核启动、每一个同步点、每一次访存往返,都直接位于生成下一个流式输出 token 的路径上。NexRT 的设计目标就是压缩这些执行间隙。
NexRT 是一款专用解码引擎,可在 8 张 H100 或 H200 GPU 上运行普通解码、MTP 和 DFlash。
在预填充到解码的交接处,SGLang 通过一个精简的适配器,将受支持的 1-batch 请求交给 NexRT。SGLang 负责预填充;NexRT 负责对延迟敏感的解码路径。
在 8×H100 上,NexRT DFlash 在 8K 上下文下约达到每秒 1,059 个 token,按假设的平均提交长度 5.5 计算。
NexRT DFlash 性能
在 8×H100 上,一次完整的 NexRT DFlash(M=8)轮次在 8K 上下文下约耗时 5.20 ms。按假设的平均提交长度(每轮 5.5 个输出 token)计算,对应约 每秒 1,059 个 token。在 128K 上下文下,对应速率约为 每秒 974 个 token。
优化完整的解码步骤
在 batch size 为 1 时,模型会产生一长串相对较小的 GPU 操作。每个阶段都有各自的访存、依赖与通信。仅优化单个矩阵乘法,只能解决生成下一个 token 所需时间的一部分。
NexRT 优化的是完整路径。嵌入、注意力、Gated DeltaNet、混合专家(MoE)计算、输出头和采样,都有专门的 CUDA 实现。它们的启动配置、融合边界和中间结果存储,都是针对受支持的模型和解码形状来选择的。
我们将普通解码步骤捕获为单张 CUDA Graph,覆盖全部 60 层解码器以及最终的 token 决策。重放这张 Graph 即可推进模型的设备状态。序列位置与 token 状态存放在设备缓冲区中,因此随着上下文增长,同一张 Graph 可以服务连续的解码步骤。
普通解码循环还使用一个小型的主机映射控制缓冲区。GPU 发布已完成的 token 与位置,主机则可在观察到上一次结果的同时,将下一次重放排入队列。这样可以把逐层的 Python 调度排除在重放路径之外,并减少 token 之间所需的协调。
把残差更新融合进归约收尾阶段,省去了单独的加法内核。设备端控制缓冲区让连续的重放可以使用同一张 Graph。内核边界决定了哪些中间值会写入内存,以及下一阶段何时可以开始。
复用权重并重叠计算
对于大型混合专家模型,搬运专家权重是解码性能的核心。NexRT 的 M=8 路径围绕验证块中被选中的专家来组织计算。使用同一专家的 token 可以共同分担加载该专家权重分块的工作。
内核直接读取目标模型原始的 K-major FP8 MoE 布局。在当前的预填充集成中,这些路由专家权重及其缩放因子与预填充引擎共用 GPU 存储。预填充和解码都保持常驻,所选投影与草稿状态则按各自的执行需求做好准备。
在内核内部,异步拷贝会在 Tensor Core 处理当前分块的同时,预先暂存后续的权重分块。共享内存布局考虑了 bank 访问模式,激活量化与缩放因子处理都是计算中的显式环节。
我们还在 M=8 的 MoE 阶段使用了 Programmatic Dependent Launch。在前一阶段仍在收尾时,down 投影内核即可开始独立的准备工作和权重预取,并在使用上游内核产出的激活值之前进行同步。这样既为重叠留出了空间,又保持了数据依赖。
同样对边界的关注也延伸到了多张 GPU 之间。选定的归约与发布阶段使用了 NVLS 多播和自定义的设备端协议。计算、对等交换与残差更新被一起编排在已捕获的执行路径之中。通信因此成为内核设计的一部分。
降低长上下文注意力的访存流量
随着对话变长,完整注意力在生成每个新 token 时要读取的 KV 状态也越来越多。这改变了计算、访存流量和通信之间的平衡。
在较短的上下文中,权重搬运占主导。随着上下文增长,读取 15 个全注意力层的 KV 状态成为不可忽视的开销。在 TP=8 下,每个 KV head 在四个 rank 上各复制一份,因此四张 GPU 会重复读取同一段历史。对于使用 BF16 KV 的普通解码,粗略估算下,历史 KV 的读取量在 8K 上下文时约为每张 GPU 每步 120 MiB,到 256K 时升至约 3.75 GiB。
NexRT 为这一场景提供了专用的上下文并行注意力路径。在共享同一 KV head 的四 rank 小组内,每个 rank 针对该组的全部 query head,各自处理上下文中不同的四分之一。随后,该小组合并各部分注意力结果,并将输出分发给各自所属的 rank。CP 与非 CP 使用同一份 KV cache;变化的只是读取的归属,从而减少重复的访存流量。
这减少了小组内重复的 KV 读取,代价是额外的 query 侧计算和一次合并。NexRT 同时提供标准注意力路径和上下文并行注意力路径。
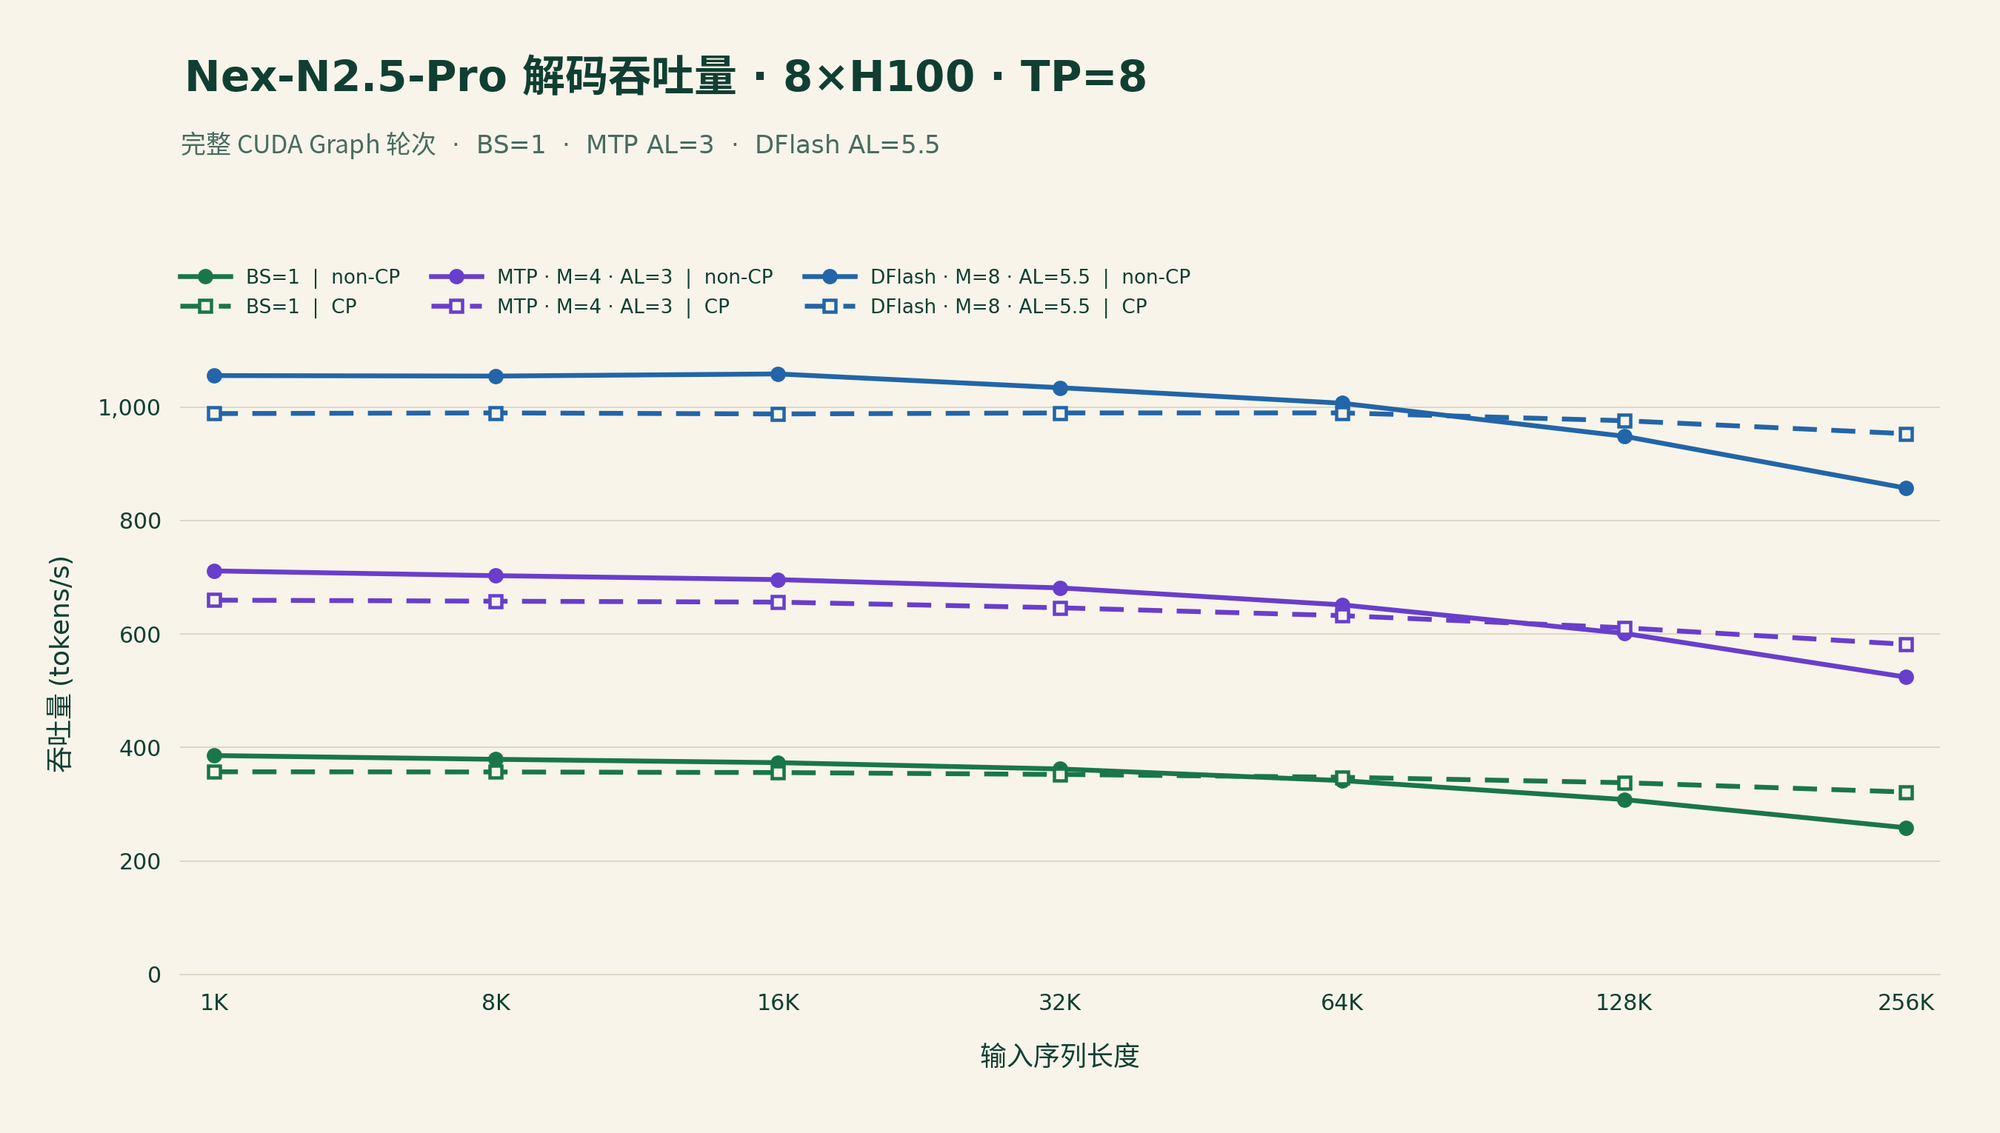
CP 增加了 query 侧计算和跨 rank 通信,因此其收益取决于上下文长度。在图 1 中接近 256K 处,CP 使普通解码的吞吐量提升约 24%,MTP 与 DFlash 各提升约 11%。
完整的投机解码轮次
投机解码带来了另一个机会:用一次目标模型验证,提交多个输出 token。同时它也增加了工作量。草稿生成、验证、状态更新,以及向下一轮的过渡,都会增加延迟。
NexRT 为每种受支持的模式提供各自的执行路径:
| 模式 | 解码方案 |
|---|---|
| 1-batch 解码 | 每个解码步骤产出一个目标 token。 |
| MTP (M=4) | MTP 解码,使用四个位置的目标验证。 |
| DFlash (M=8) | DFlash 解码,使用八个位置的目标验证。 |
每个引擎在启动时选定一种模式。MTP 或 DFlash 验证块中的多个位置都属于同一个请求。
对于 MTP 和 DFlash,被捕获的轮次包含草稿计算、目标验证和提交逻辑。M=4 与 M=8 路径各有自己的内核和控制状态,因此可以针对这些形状调优其执行。目标验证决定提交的输出;接受长度决定每一轮交付多少有用的输出。
吞吐量同时取决于轮次延迟和接受长度。NexRT 专注于所选解码方案的高效执行,包括围绕目标验证的相关工作。
融入推理工作流
在预填充到解码的交接处,随着预填充分块完成,KV 行被迁移过来,循环状态被最终确定,目标特征则用于初始化所选的草稿路径。适配器让这次状态传递保持显式,同时由 NexRT 接管后续的解码执行。
目标权重保持常驻,供后续请求使用。共享大型 MoE 张量使预填充与解码共置变得可行,同时为所选模式的工作状态留出空间。
仓库附带一个示例服务器和一套冒烟测试(smoke)工作流,可用你自己的提示词尝试完整的预填充到解码路径。适配器把这条工作流与专用的解码实现连接起来。
关于北坡
北坡(上海奇绩智峰智能科技有限公司)是一家全栈式企业级 AI 智能体公司。我们构建模型、平台与交付能力,让大型组织能够把 AI 智能体可靠、安全、规模化地投入真实的生产工作。
以 Apache-2.0 协议开源
NexRT 以 Apache-2.0 协议开源。当前实现支持在 8 张 H100 或 H200 GPU 上运行 Nex-N2.5-Pro,要求 TP=8 且支持 NVLS 多播。
仓库包含 CUDA 内核、解码 CUDA Graph、投机执行路径与预填充适配器,并附有运行受支持配置的说明。