AI 智能体时代的记忆:记忆机制与综述背后的故事
论文链接: https://arxiv.org/abs/2512.13564
本篇 blog 只作导读,关于细节和精确陈述的内容并不在此铺开,欢迎读者访问论文链接查看原文。作者为朝闻道成员,也是本篇综述的核心作者。
引言
毫无疑问,有关于 LLM memory、agent memory 的探究是2025年的聚光灯话题。从层出不穷的学术文章,到 mem0、MemOS 等知名开源项目,以及 Ilya、Shunyu Yao 等热门学者访谈,AI memory 被不断提及、重视、宣告,它似乎无处不在:情感陪伴、文档分析、科学发现、长文推理、多跳问答、Web 任务、GUI 操作、视频生成、具身智能等等。这些琳琅满目的工作,都声称各自“实现”、“利用”了 memory,来完成相应的下游任务,但他们各自的设计往往天差地别。
那么,到底什么是记忆?
这便是我们想要写这篇论文的初衷:用一套分类学,一统所有文章。我们想给出一个视角,一个话语体系,这样所有的记忆相关的文章都能找到对应的坐标,能被正确地理解、审视,并且在各自的生态位上各司其职。我们希望能给社区一种全景式的描述,以增强社区的凝聚力而不至于割裂。这套体系应具备兼容性和前瞻性,能够无缝衔接今年井喷的 memory paper,又能以 position paper 的形式给一些未来课题做潜在预测。并且,这套体系应当直观清晰,方便初学者入门,并汇总相关的资源与评测,提供从理论到实践的指导。
因为我们相信:AGI 的实现中,memory 不可或缺。
概念辨析
在被称为 agent 元年的 2025 年,我们要面对的是 agent memory,因此我们首先要遇到的就是概念辨析:agent memory 和 LLM memory 关注点有什么区别?
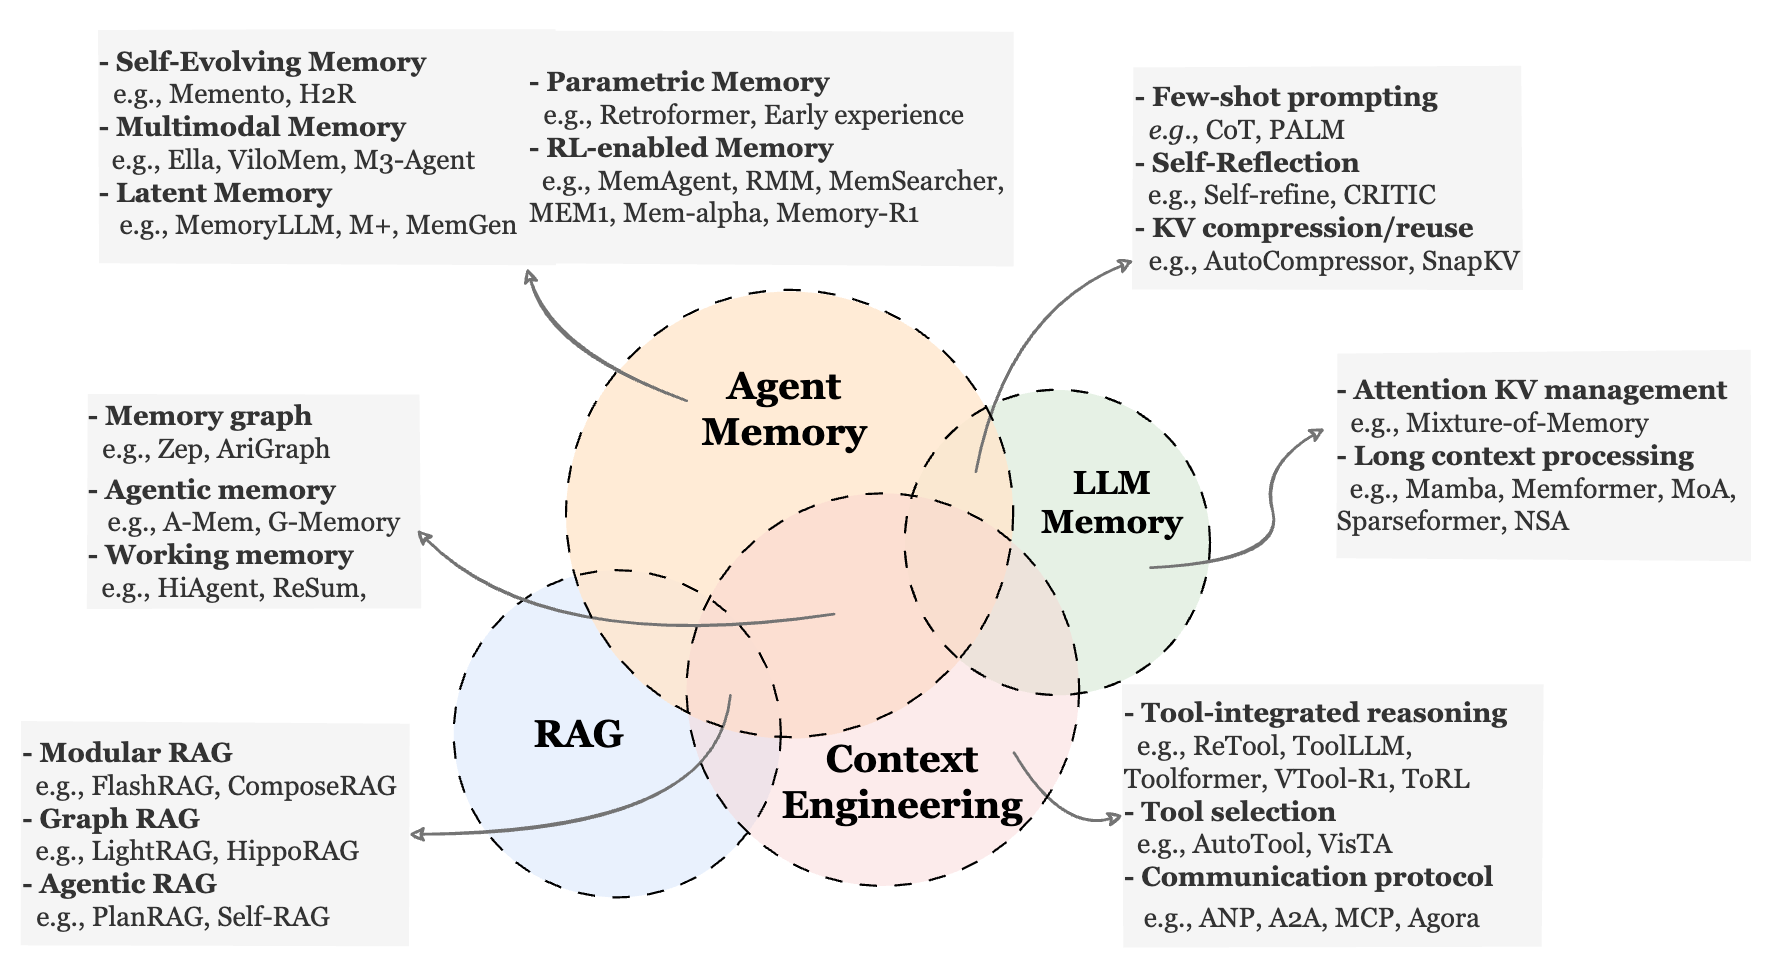
对比分析 LLM memory、RAG、context engineering 这几个概念,我们可以大致理解为:LLM memory 是 agent 范式确定前的研究范畴,RAG 则是标准的一套方法论,context engineering 则是以 context 为核心的技术范畴。agent memory 在适用领域、研究方法上,和这几个领域互有交叉。
写这一章是回应如此一种感觉:好像 memory 在干的事情和 xxx 差不多、这个不就是 xxx 吗,新瓶装旧酒罢了。有些读者对于记忆的讨论本身产生了某种偏见,认为是故事会、灌水文章。“这也能硬蹭吗?”
我们不回避、不视而不见,我们必须承认这些方法之间的 overlap 是客观存在的,承认他们相互耦合、相互借鉴。agent memory 现在就是一个涵盖了多个任务领域、多个方法类别的庞杂的研究主题,也正是现在割据混战局面下导致了行内行外人的模模糊糊似懂非懂的印象,因此我们想要尽可能厘清,尽可能用一个框架来打破这种局面。
我们为 memory 正名。一篇研究文章真正的价值,是一个基于关键领域、核心问题、优美方法、扎实实验、细致分析、深刻洞见的多元非线性组合结果,从而反映在工作的讨论度、引用数等市场机制下的真实反馈信号上。我们希望读者通过我们的框架,能够快速判断节约时间,不至于陷入到云里雾里的名词之中,让真正有意义的文章能够得到认可,同时,让 memory 领域内的水文能被甄别。
分类速览
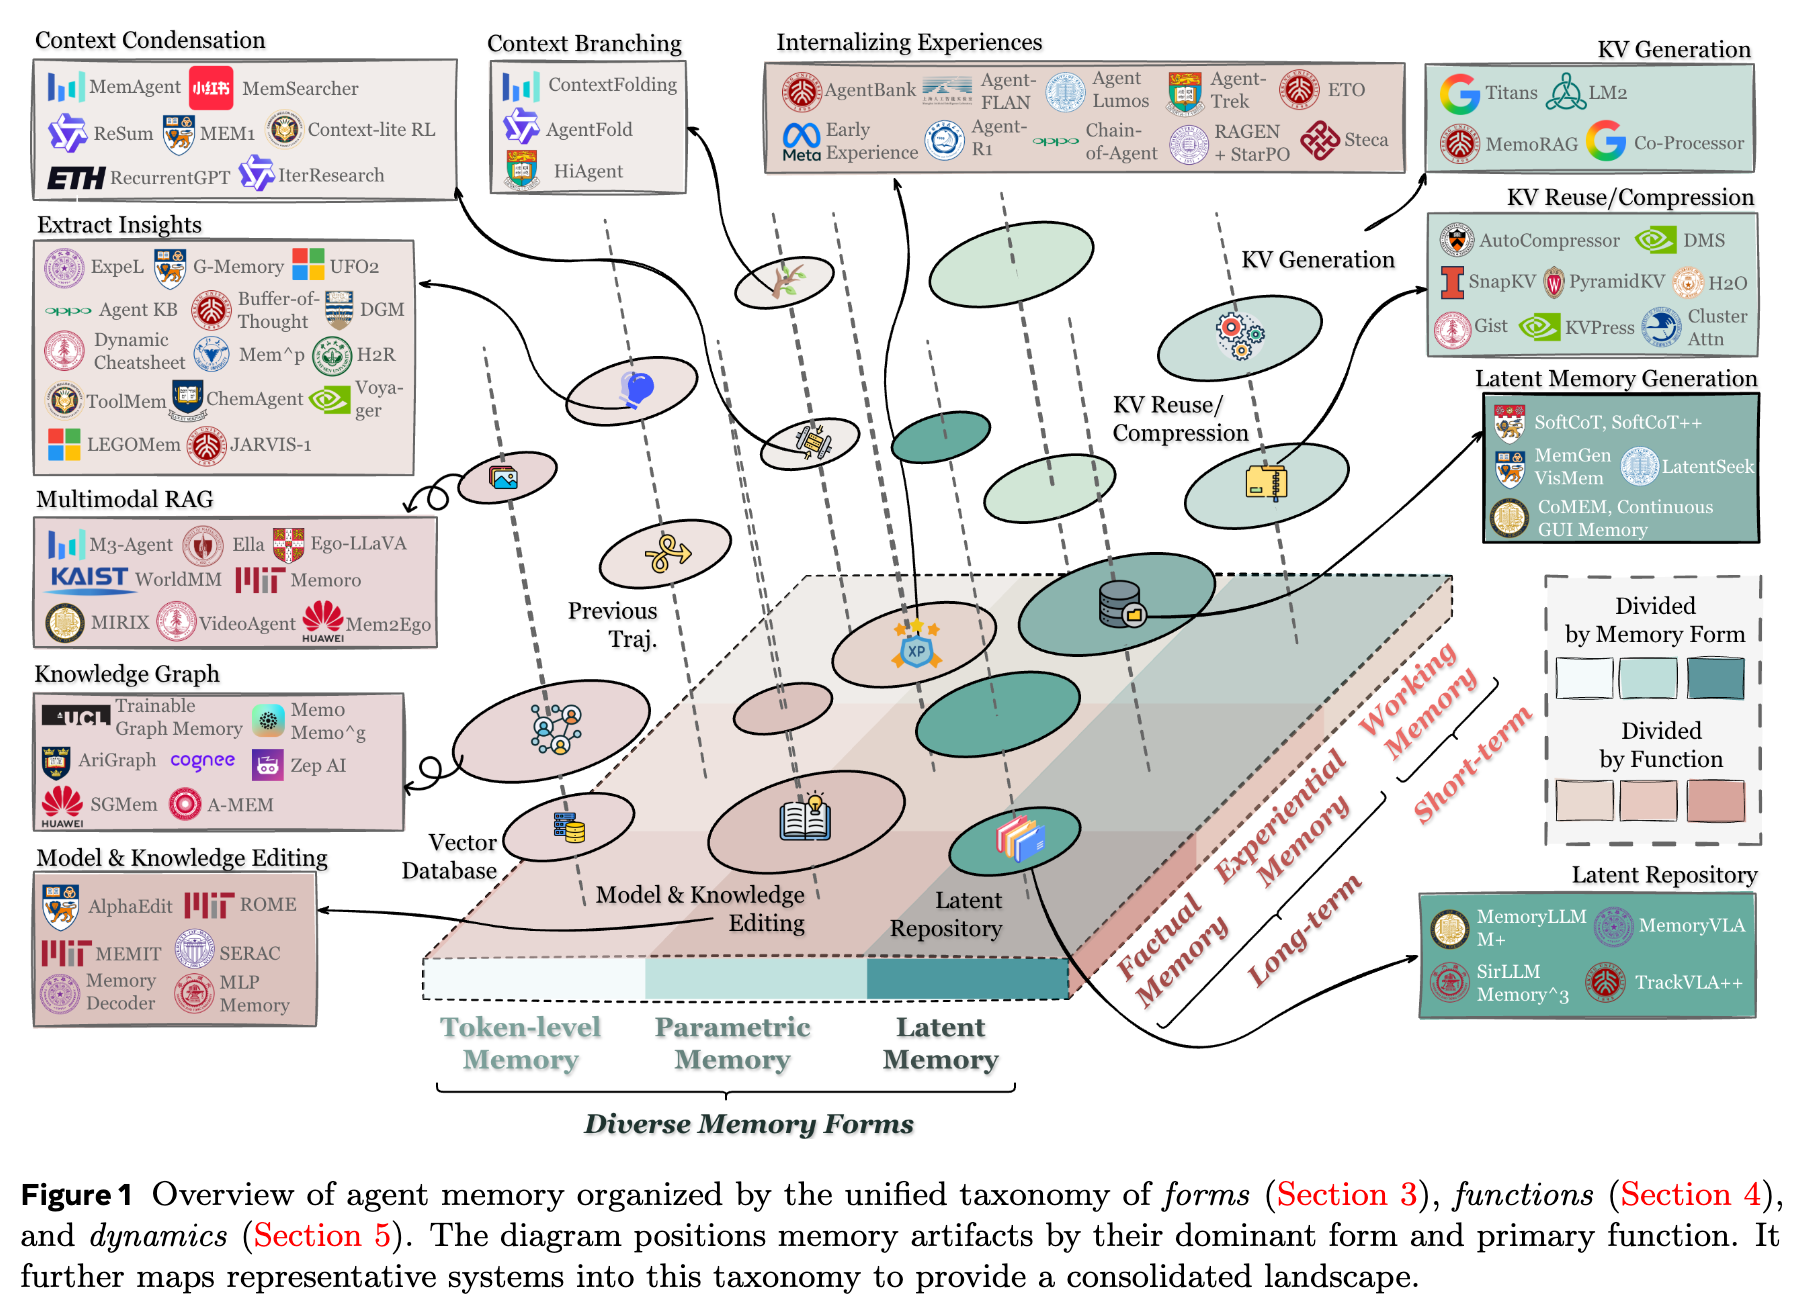
正如综述的副标题而言,我们为 agent memory 划定了三个坐标轴,这是三个视角。form 是记忆形式,关乎其架构和表示形式;function 是记忆功用,表示其职责、目的、场景;dynamic 是记忆动态,是方法论上面的高度抽象。前两者是对于记忆工作所在位置的一种快速定位,方便 match 到同类工作与相近场景,构成了一个在平面上 xy 轴的 9 个象限;dynamic 是一种时间维度,构成了 z 轴,贯穿所有工作,是一套方法论角度上的理解模板。我们接下来展开这三个维度。
记忆形式
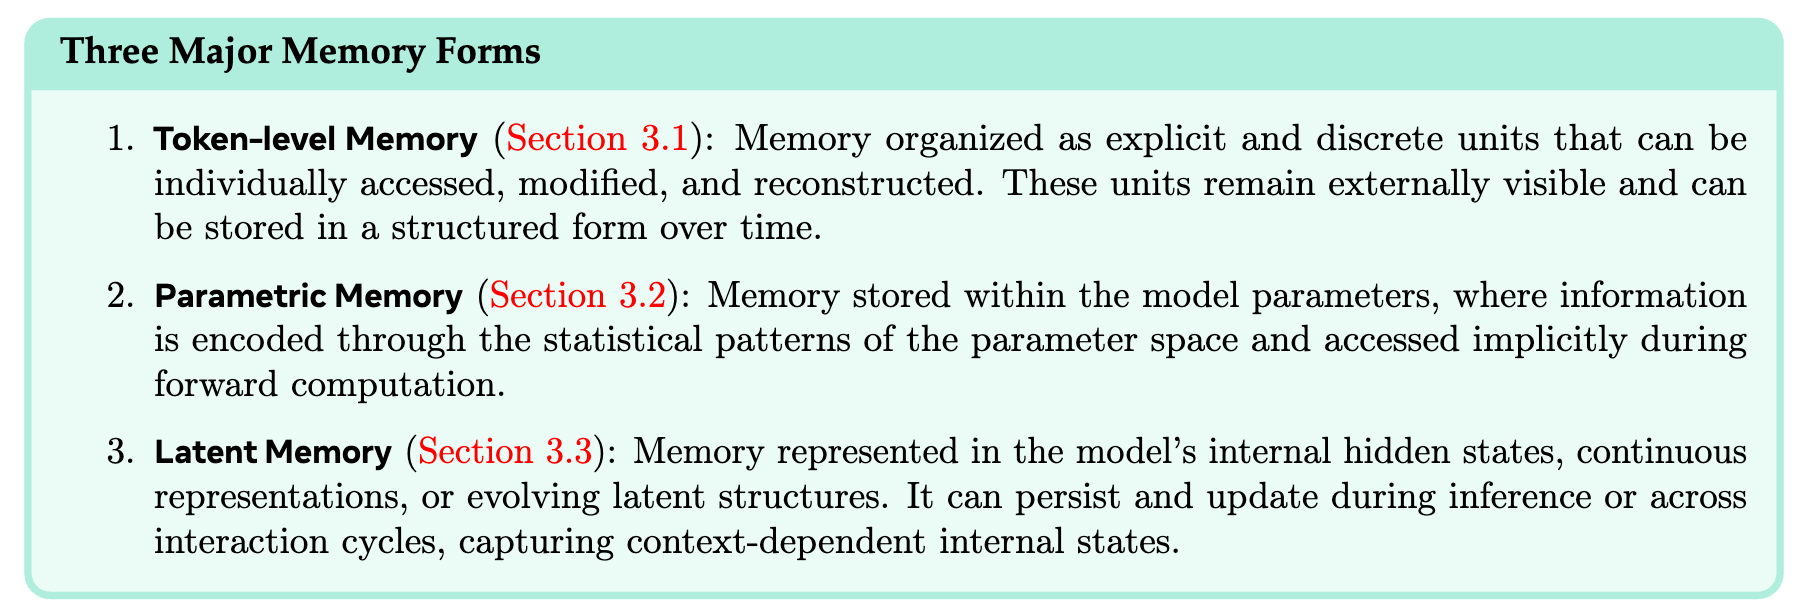
记忆形式是依据记忆的存储位置和表示方式分成了三大类:Token-level、parametric、latent。
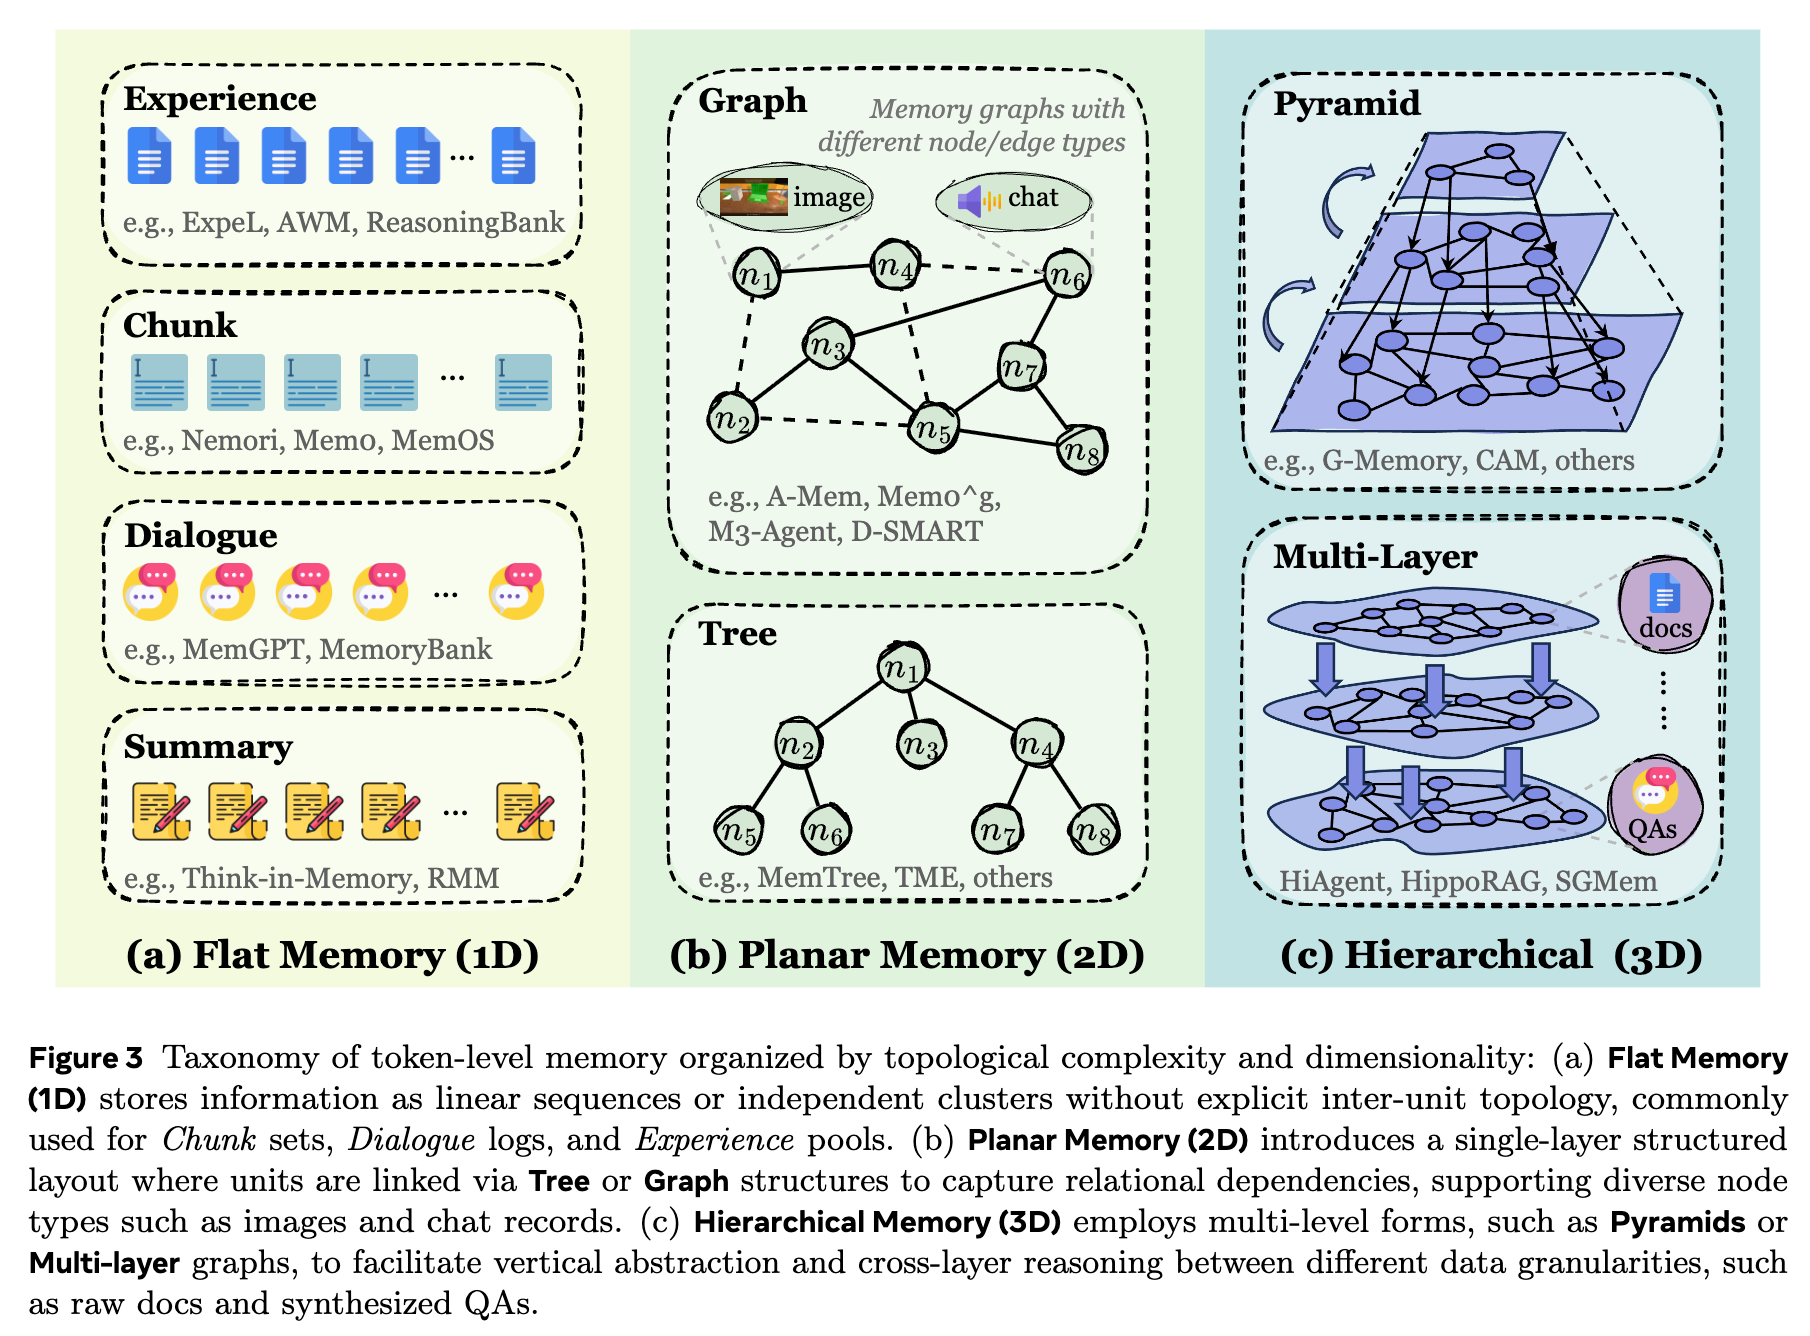
Token-level memory 核心特征就是能够在 inference 时通过检索或其他利用方式以 token 形式离散地输入给模型,显式,外置,可插拔。想必有读者好奇为什么是一个复合形容词,其实我们也考虑过 semantic、textual 之类的陈述,但似乎在多模态领域就不太适合。直接叫 external/explicit,那么与之相对的其他类型就全部都是 internal/implicit 了,虽说是比较符合认知科学那边的分法,但是在 agent memory 这边就有点为了追求形式对称而一刀切之嫌。(或许读者在看完第三节之后有更好的命名建议可以联系我们)
Token-level memory 不只是词表中的 token,还可以是视觉 token、audio frame 等可被离散化的元素。这种形式清晰、可编辑、可解释,天然适合计算机的各种检索、存储、路由、冲突处理,因此研究最多、最广。根据 token 之间的关系,有可以分为 1D,2D,3D 不同的组织形式。
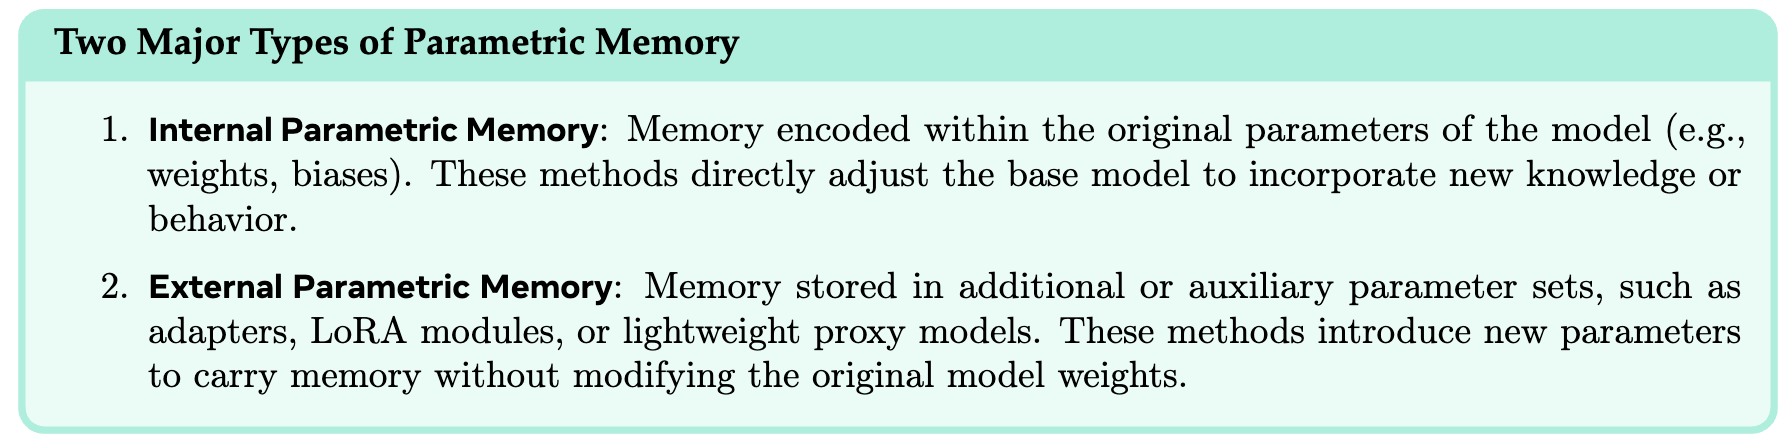
Parametric memory 包括了内部和外部参数,我们这里内部外部的对象主体是放在单一的 model 上面。内部参数,基本上就是在 pretrain、mid-training、post-training 不同阶段去 tune 一个模型,从而引入相关的知识和记忆。这里包括了一些对齐、模型编辑相关工作。外部参数,比方说把一些外部 document 转为 lora,推理时引入来缓解知识冲突问题,或者是引入其他类型的外部的参数结构。
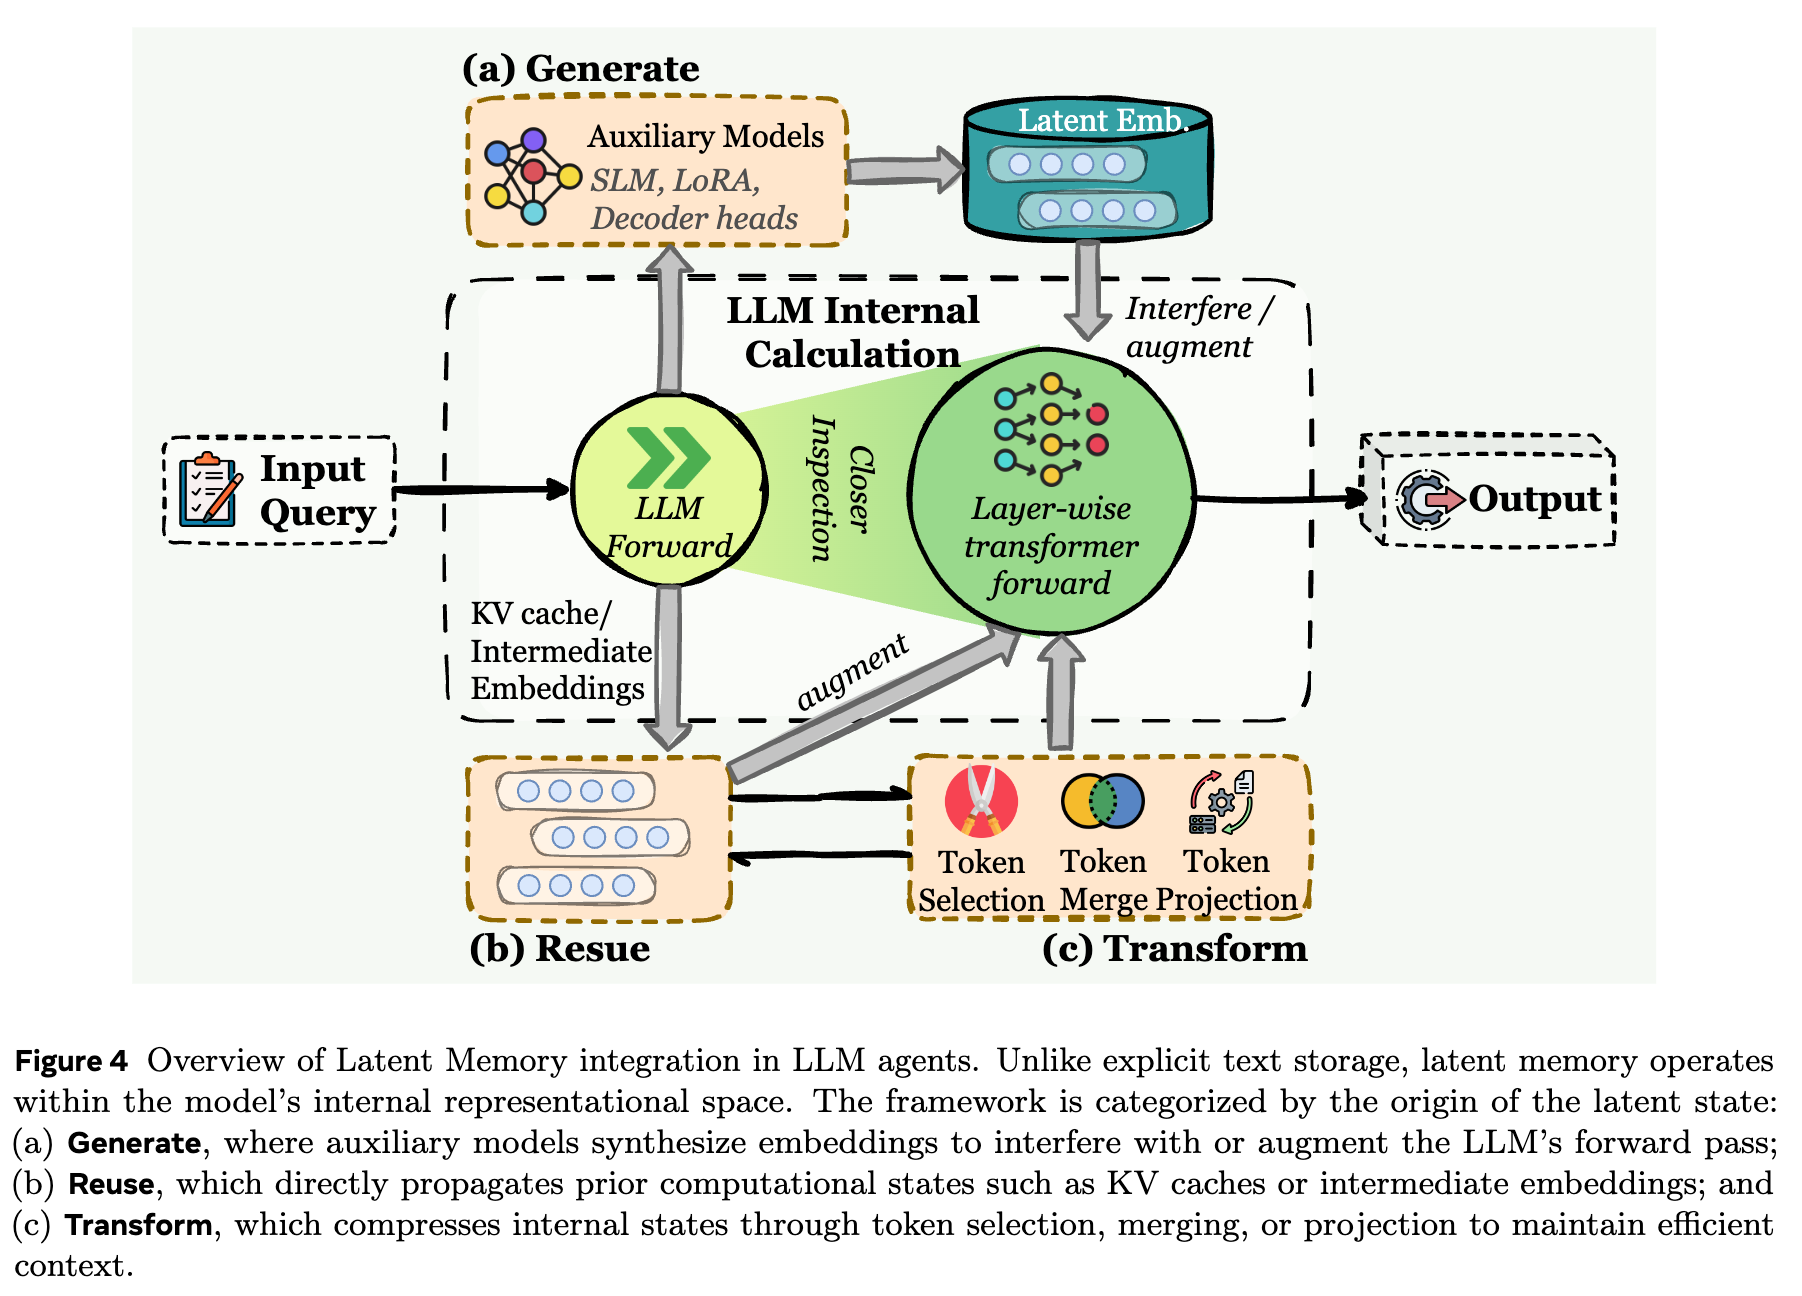
Latent memory 今年比较火。这是一种介乎显式 token 以及完全参数化的中间形态。latent memory 的核心载体是 latent token,是一段 dense vector,压缩了离散形态的记忆内容但是保留了更多的上下文。虽然不是人类可读的但是信息密度更高。这里是从来源分类得到了3种类别:生成、复用、转换。
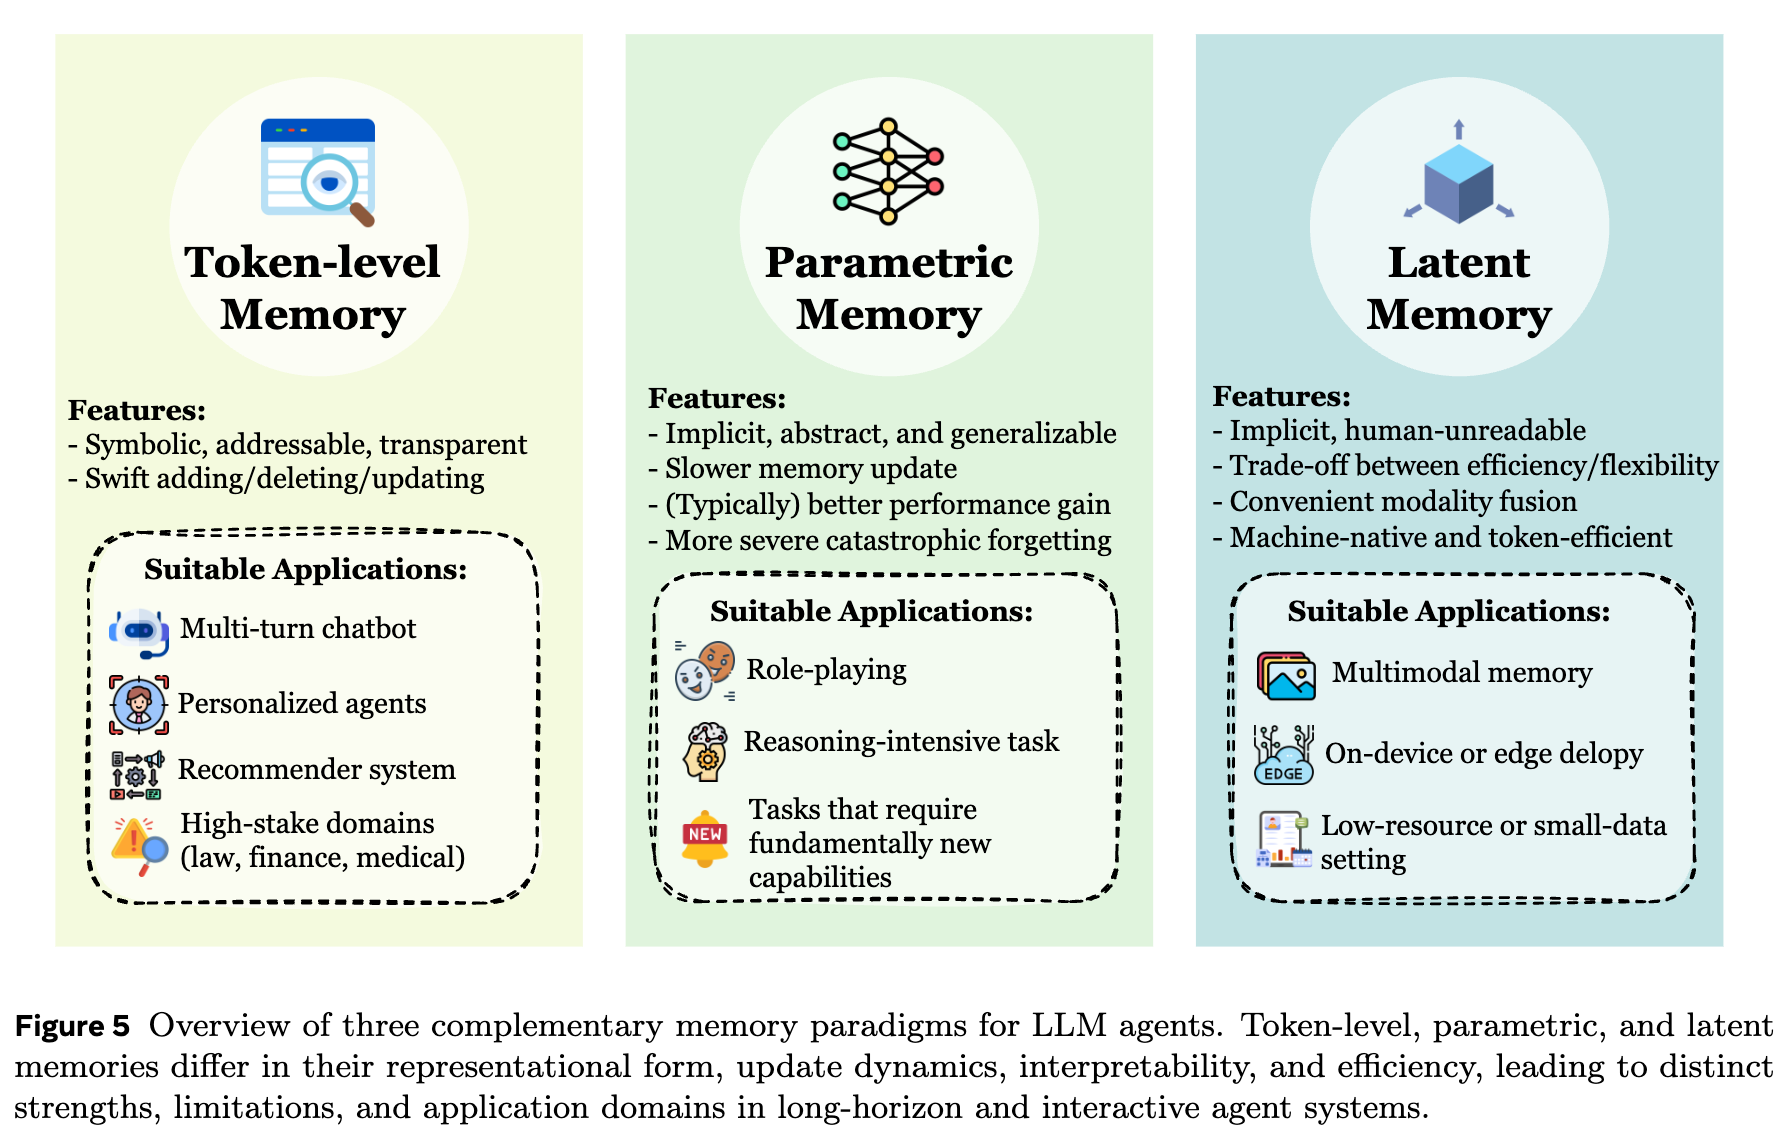
不同的记忆形式存在各自的特征和优缺点。需要注意的是,没有哪种记忆形式的设计一定是全局最优的,一切都取决于业务场景。我们专门写了 section 3.4 来说明记忆形式和任务场景的mapping。
记忆功能
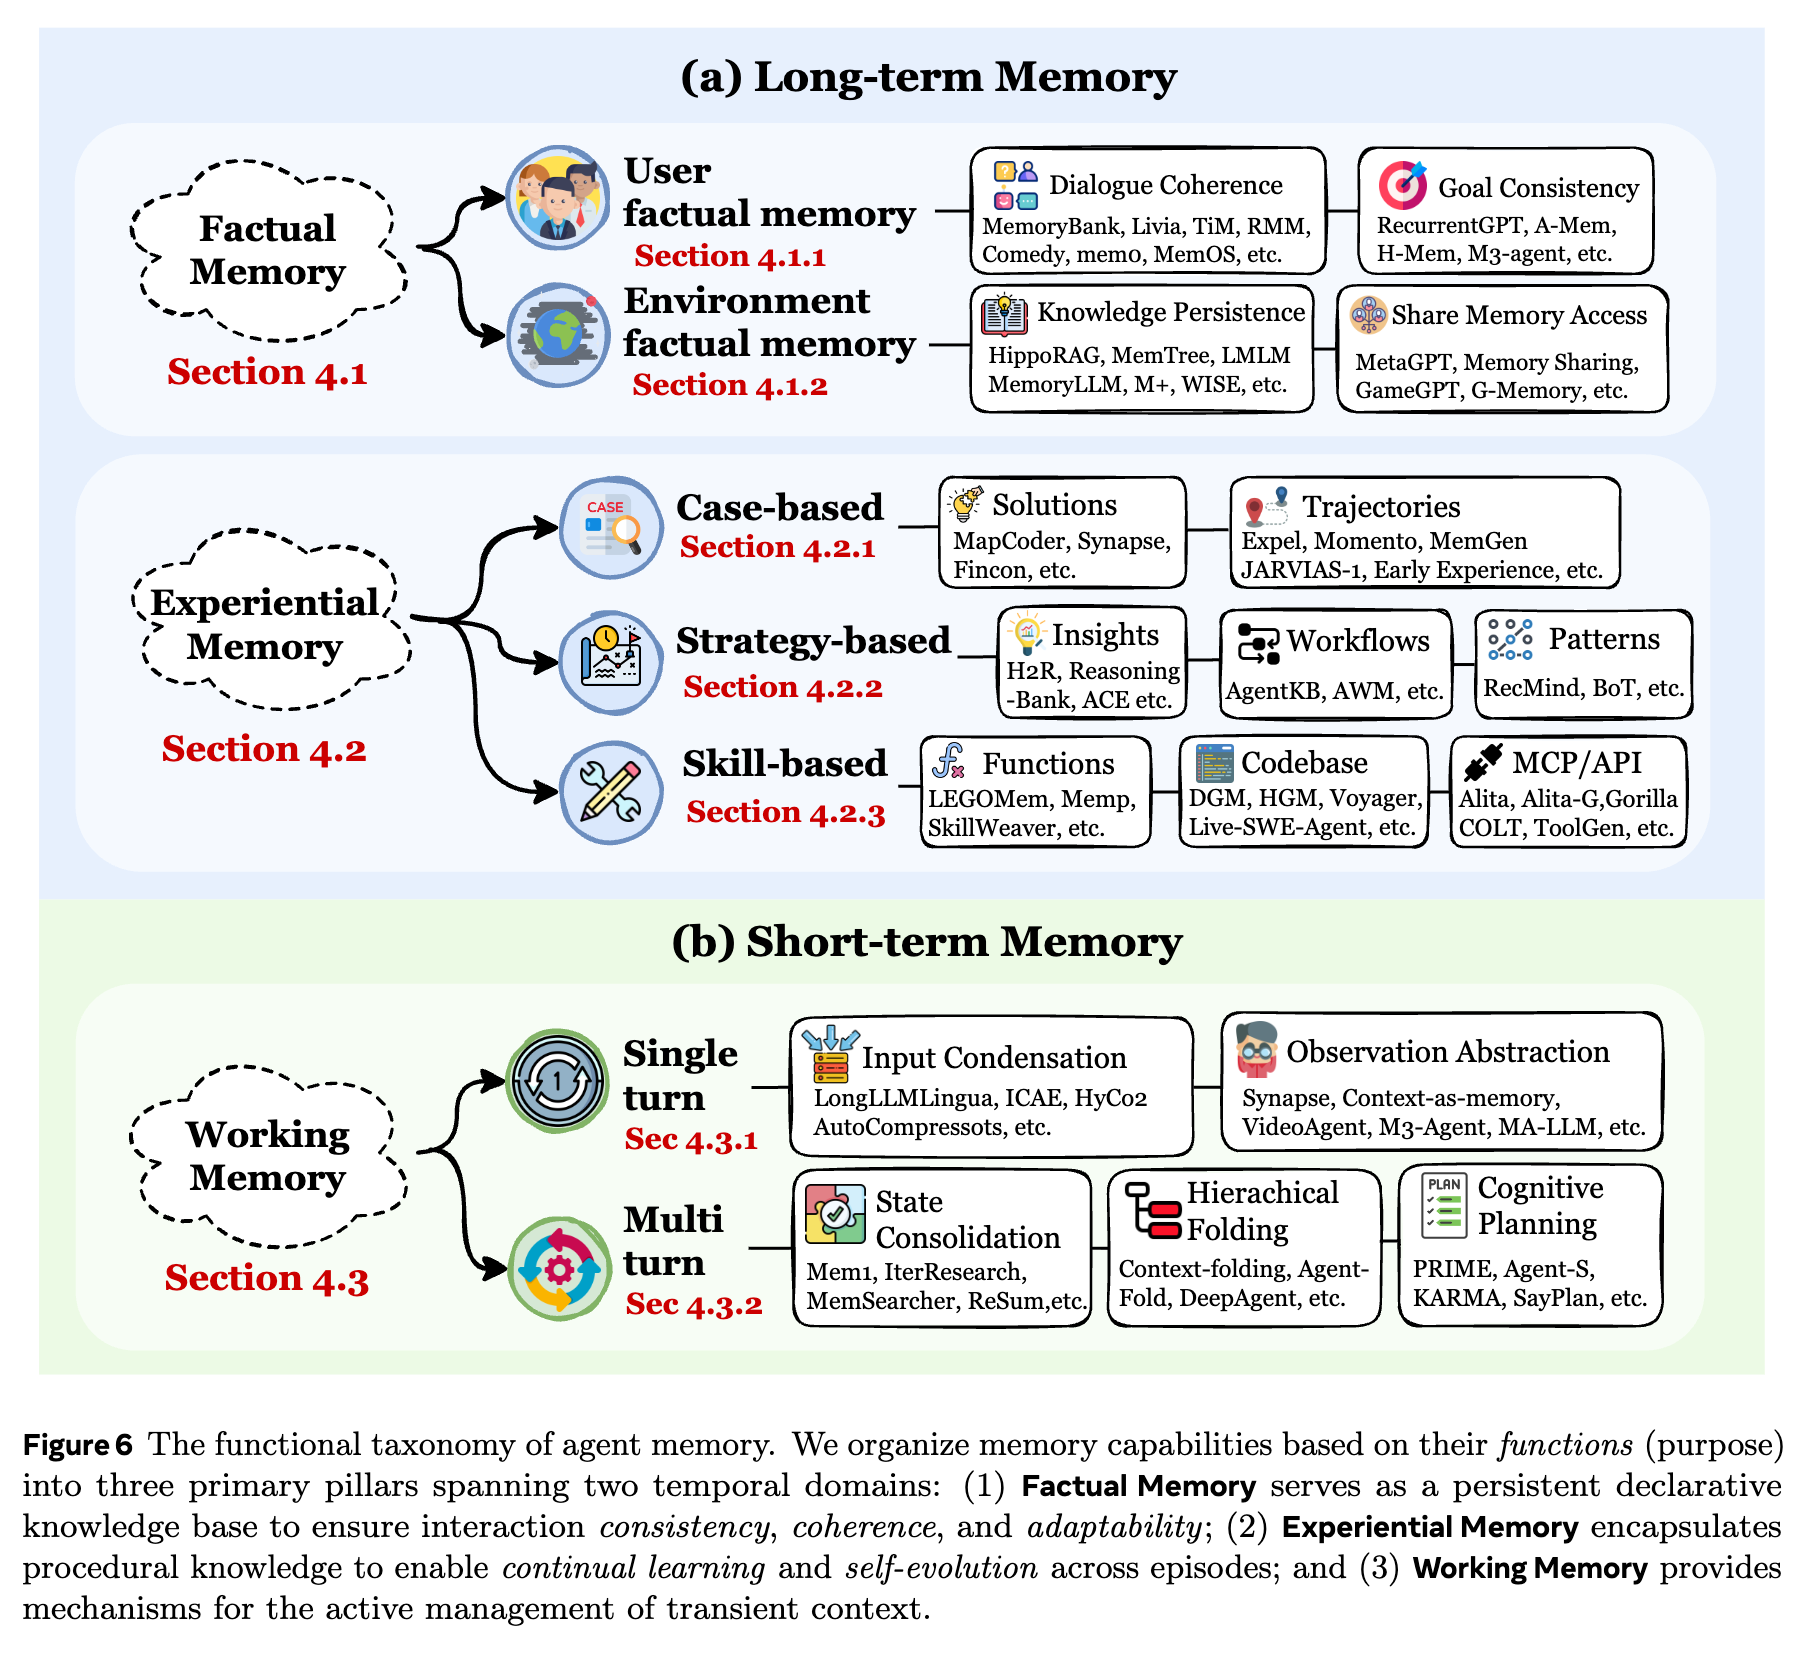
记忆的功用有三种不同的场景:事实型记忆、经验型记忆、工作记忆。三种不同的场景又对应了三种不同的目的、能力。一些文章在设计的时候会跨越多个不同的目的和场景来设计,并不是排他的。相关场景和工作看图就行。 (有读者又要说了,第三个命名完全不对称啊。但是笔者也没想到更好的广为接受的名称……)
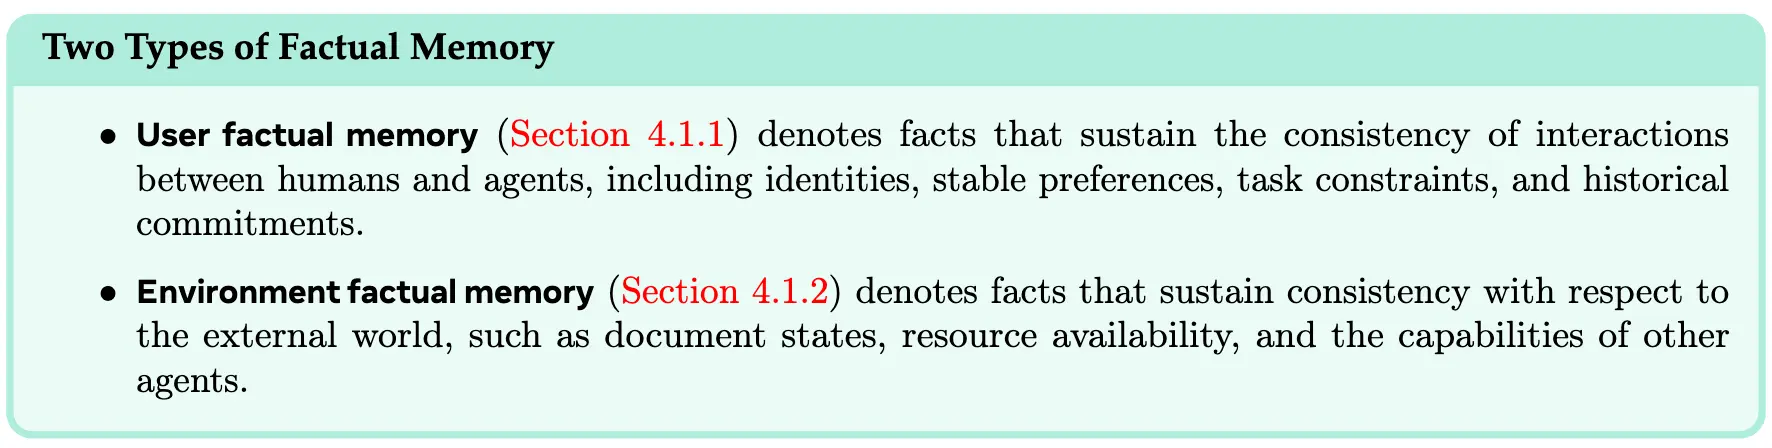
事实记忆涵盖了对话历史、用户偏好、事件、世界知识等等。如果从人类记忆的视角观察,大体上对应了 episode memory 和 semantic memory,但 agent memory 可能两者都存并不对立。其存在目的在于:一致性、连贯性、适应性。一致性体现在行为和自我呈现在时间上的稳定性,避免自相矛盾和立场随意转变;连贯性体现在上下文感知,agent 保持主题的连续性,从而确保响应形成逻辑连贯的对话;适应性是指能够根据已存储的用户画像和历史反馈来个性化行为,响应方式和决策过程会逐步与用户的特定需求和特征保持一致。
因为内容比较多,所以又细分了两大类,一类是用户事实记忆,一类是环境事实记忆。
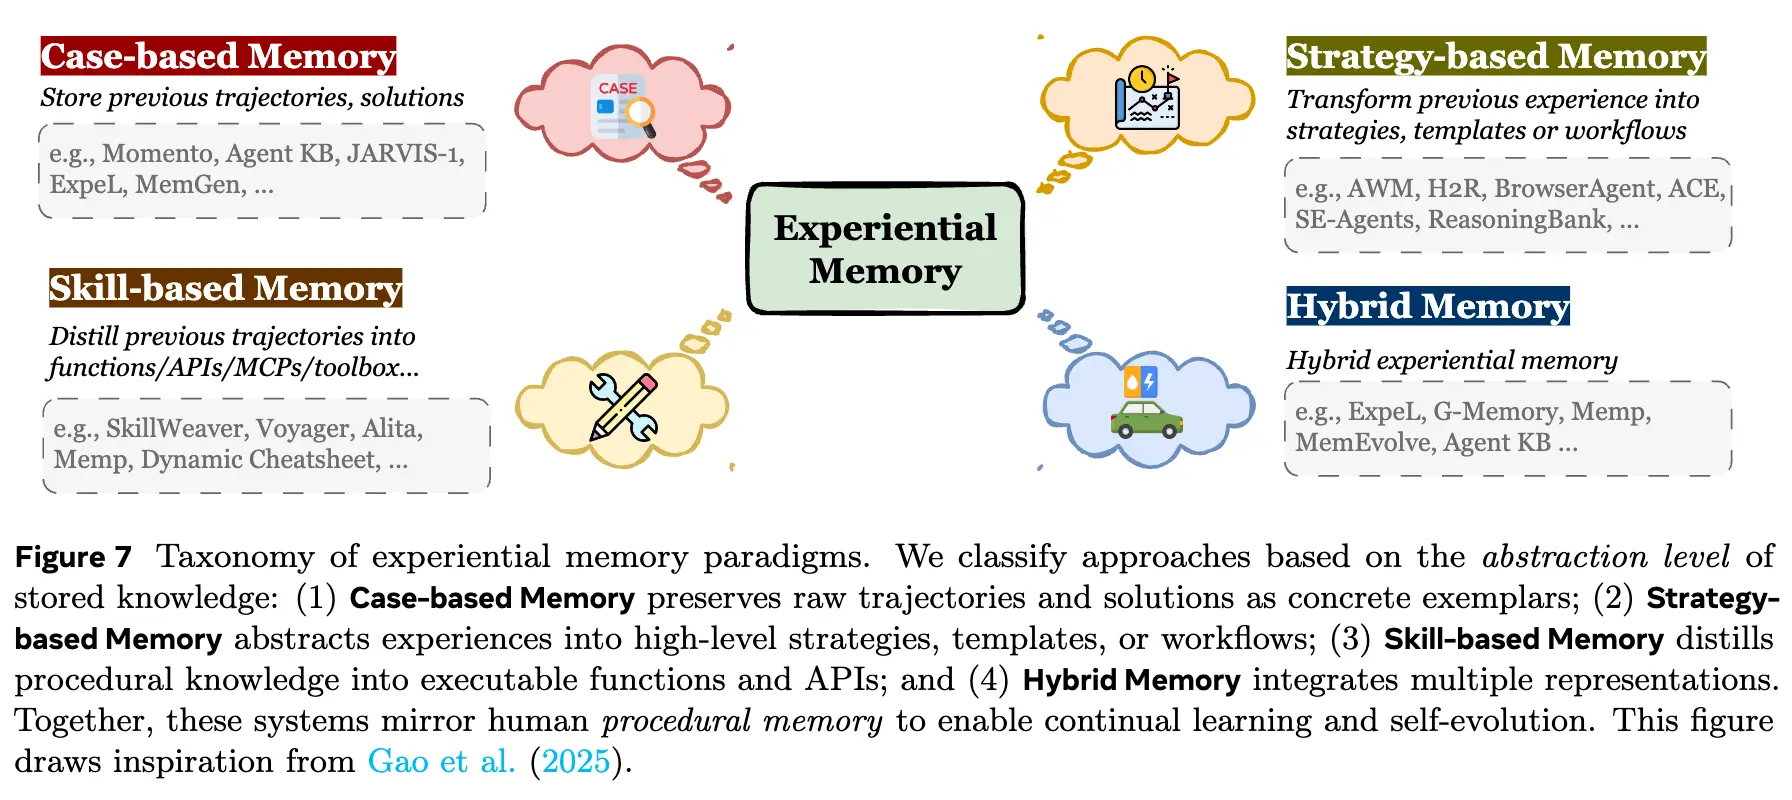
经验记忆则是一个强任务导向的:我有一个困难的任务,我下一次如何能做的更好?因此,经验记忆需要将历史轨迹、提炼出的策略和结果进行存储、组织。其目的在于:实现 agent 的持续学习与自我进化。通过维护结构化经验库,agent 能够实现非参数化的适应路径,从而避免频繁参数更新带来的高昂成本。这种机制通过将交互反馈转化为可重用的知识,有效地闭合了学习闭环。主要是三大类分类:case-based、strategy-based、skill-based,另外加就是混用的 hybrid 设计。
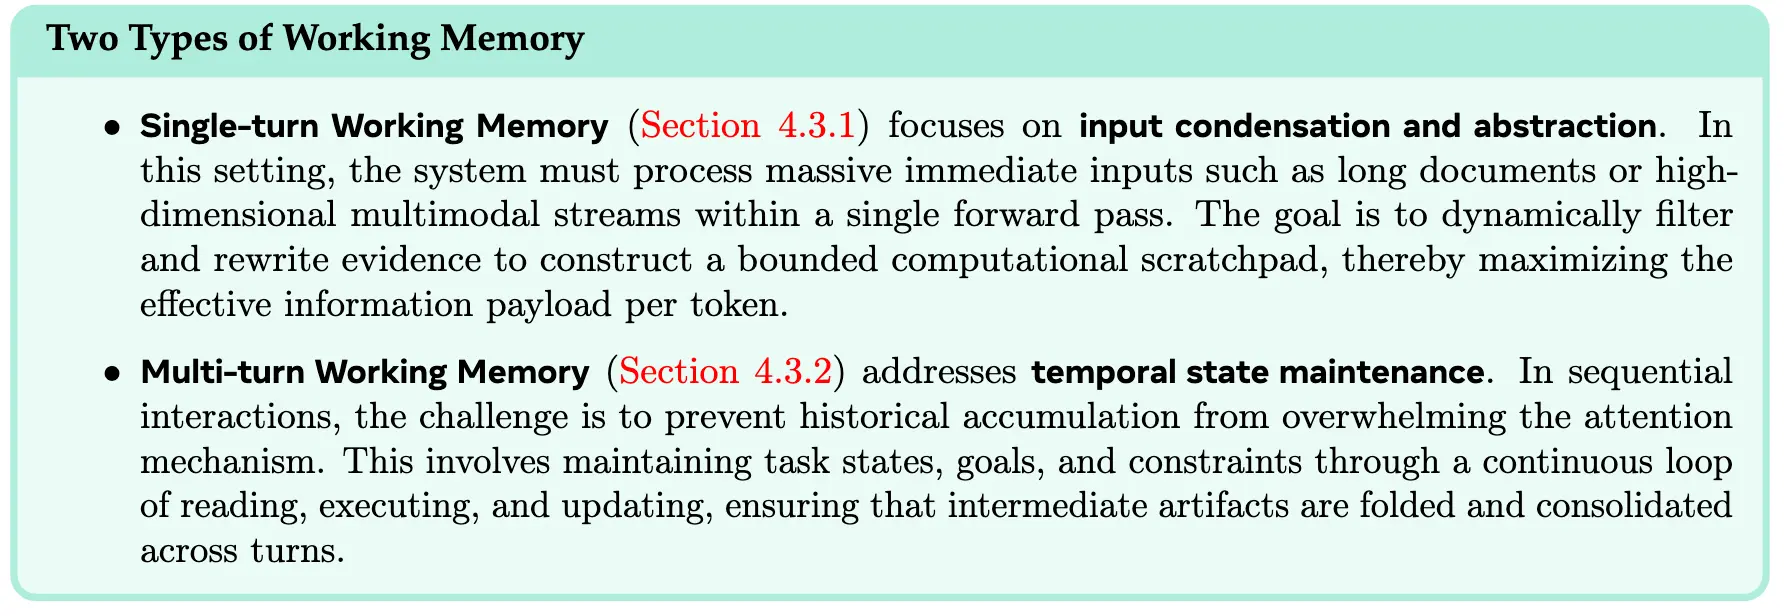
工作记忆则是在一次 trial 内部,通过即时选择、维持和转换与任务相关的信息来支持高阶认知,是最接近于原生认知科学 working memory 的概念。工作记忆定义为主动管理机制,大部分与 context engineering 的研究课题 overlap,但严格追溯起来,显然是 working memory 这个概念更先被提出。目的在于,在有限的 context window 里面完成超长的 agentic task 所需的记忆管理,这并不仅仅是“无限上下文”这一个目标,而是一种“遗忘”:什么是重要的,什么是冗余的,什么需要被记录到小本本上面后面想起来了再去查。只在有限的工作记忆中保留最重要的内容,不把 attention 浪费在无关 token 上面。
记忆演进
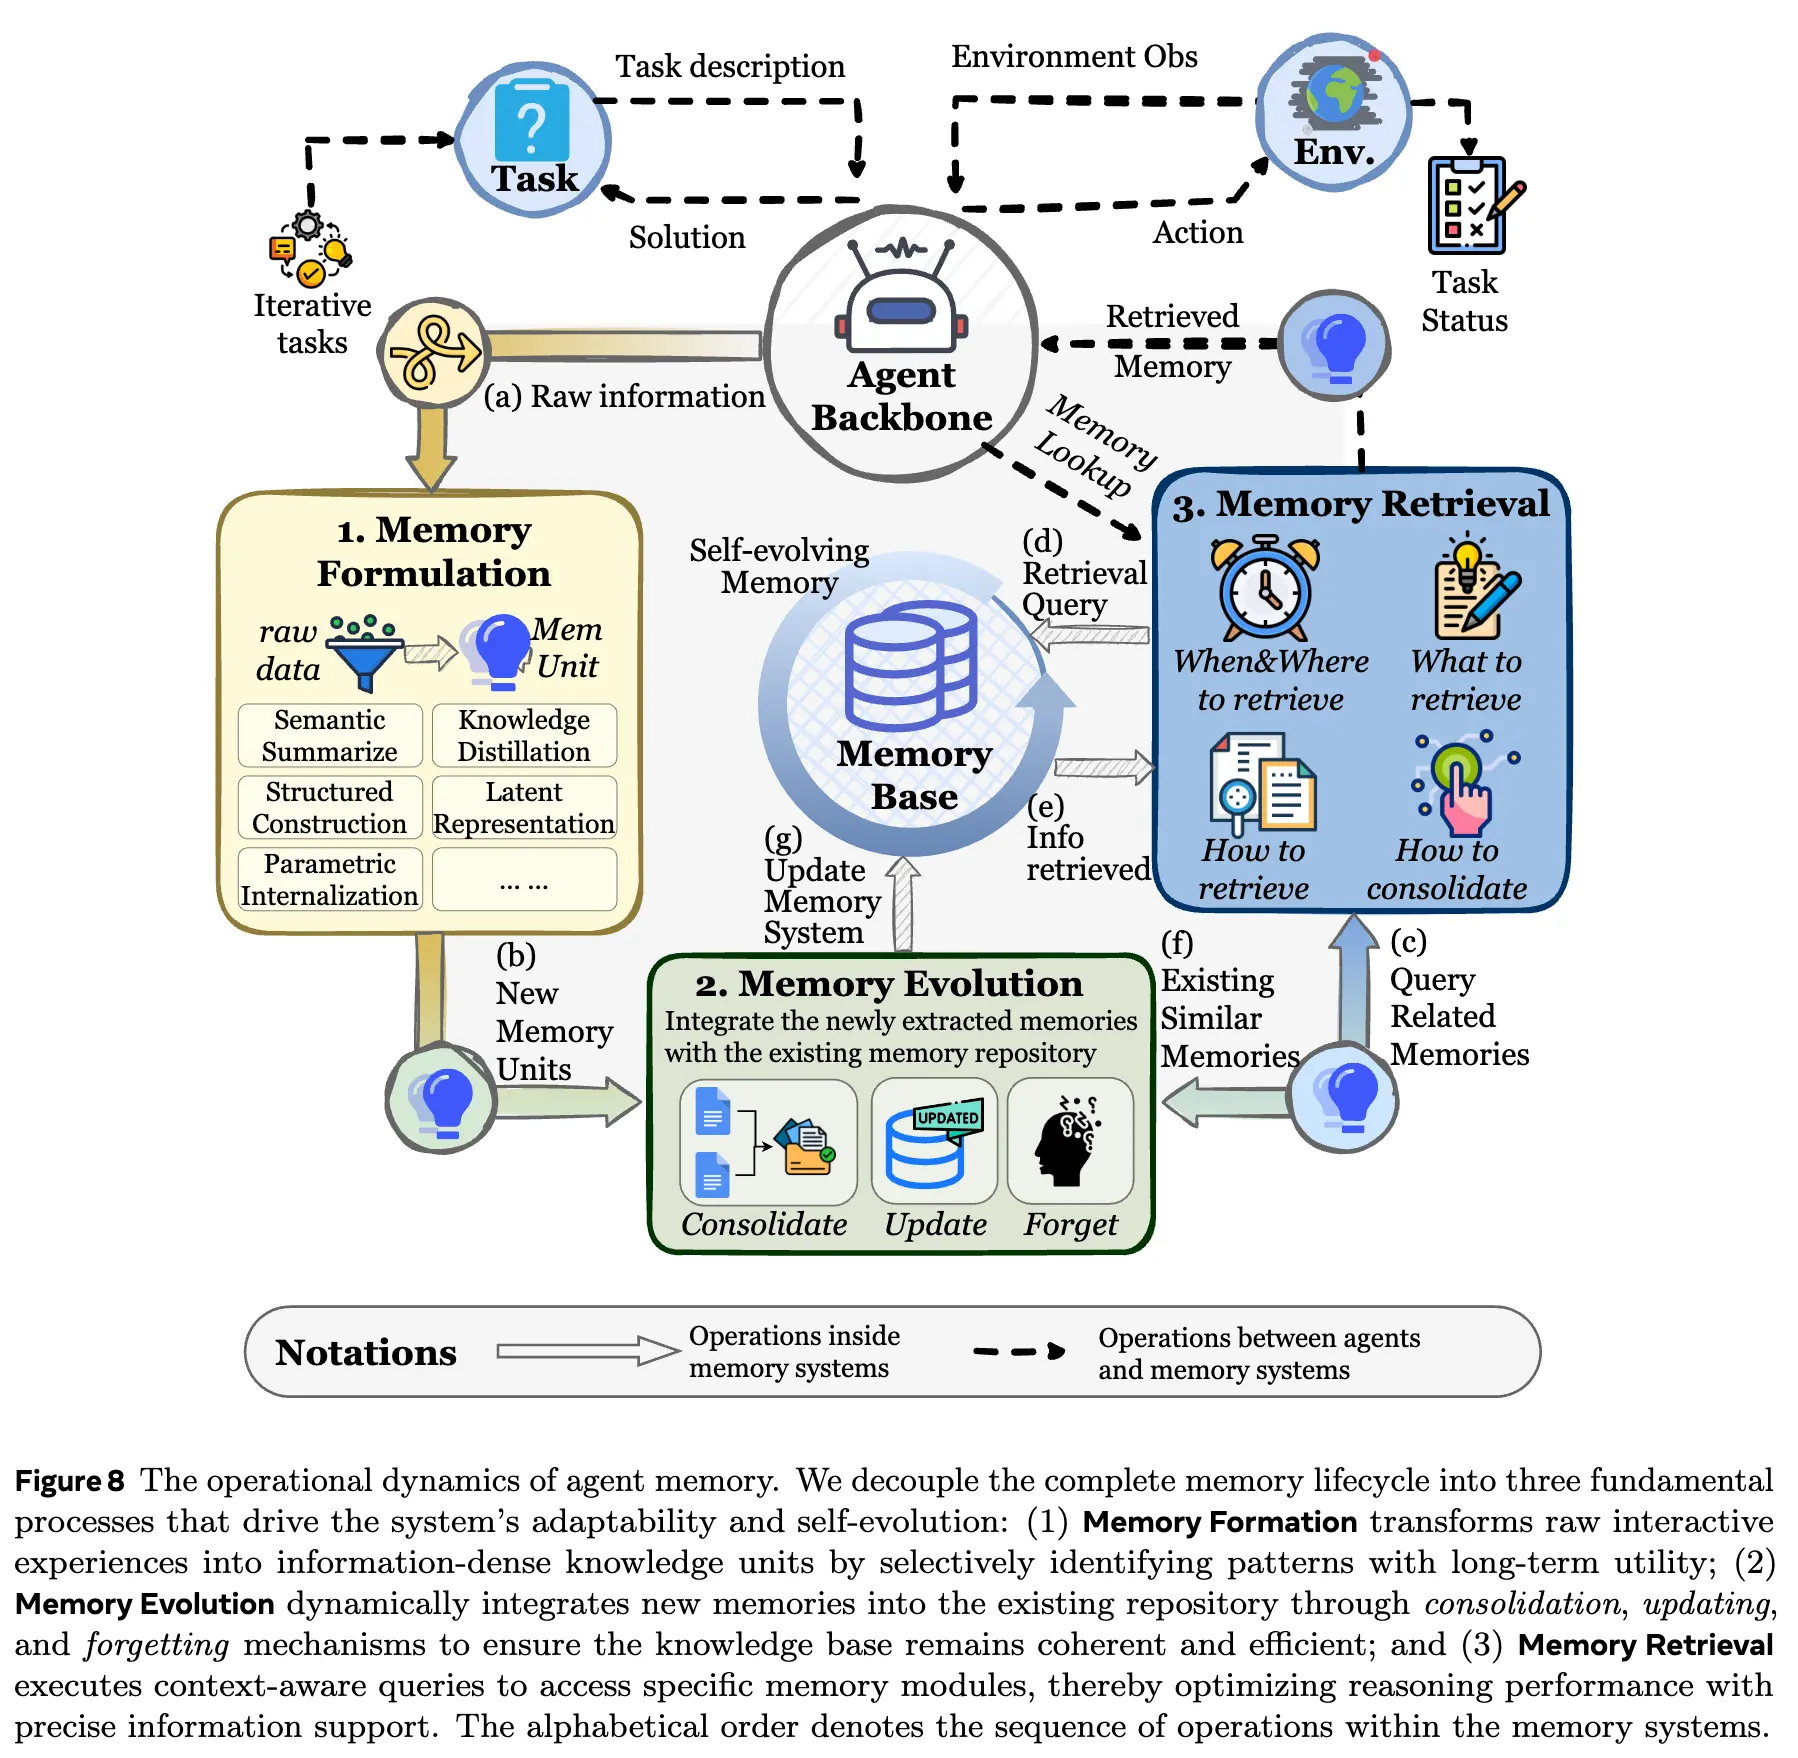 记忆动态是从一个记忆从“出现”到“完成使命”的全生命周期。笔者在 9 月多写的 blog 中给 agent memory 工作的流程总结为“获取-组织-利用”,在此我们给出更加优雅的表达:形成 formulation - 演化 evolution - 检索 retrieval。记忆动态并不是一个分类视角(区别于前两个维度),而是一种认识论角度,把大部分的 agent memory 工作还原到这三个基本流程上面,快速抓住核心。这三个过程三位一体,环环相扣,每一块的设计都不是独立的,必须同时考虑到其他两块的设计与优化问题。
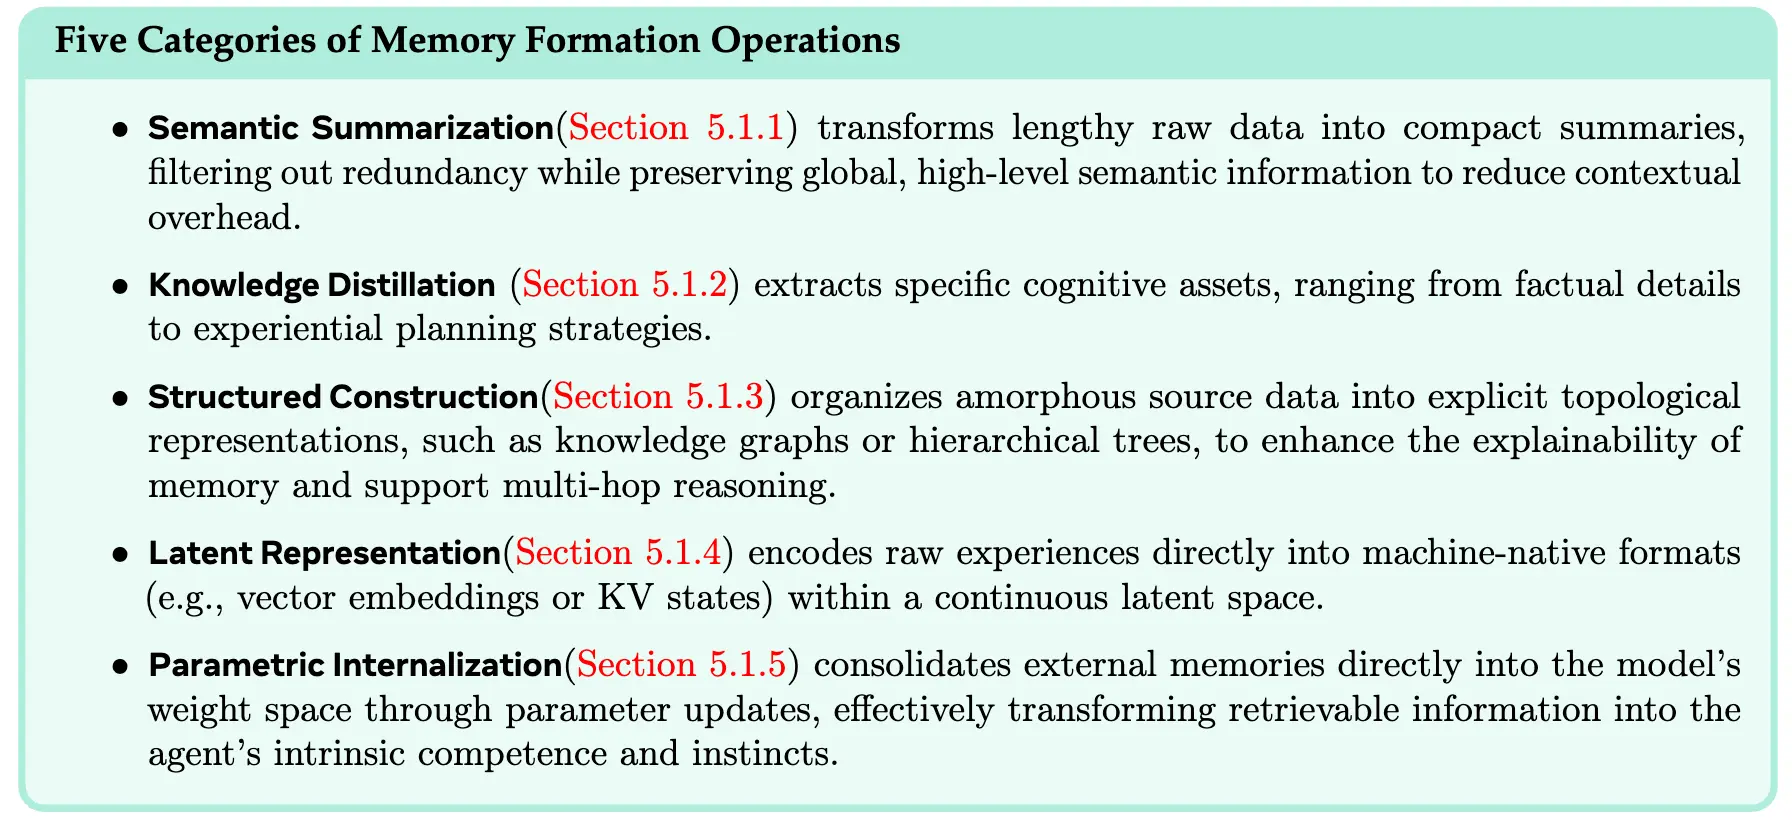
记忆形成侧重于将原始经验转化为信息密集的知识(初步去噪),聚焦于提取记忆以及表示记忆。具体包含了5大类内容。这是区别于传统 LLM memory(如何记得更多)的一个方面。
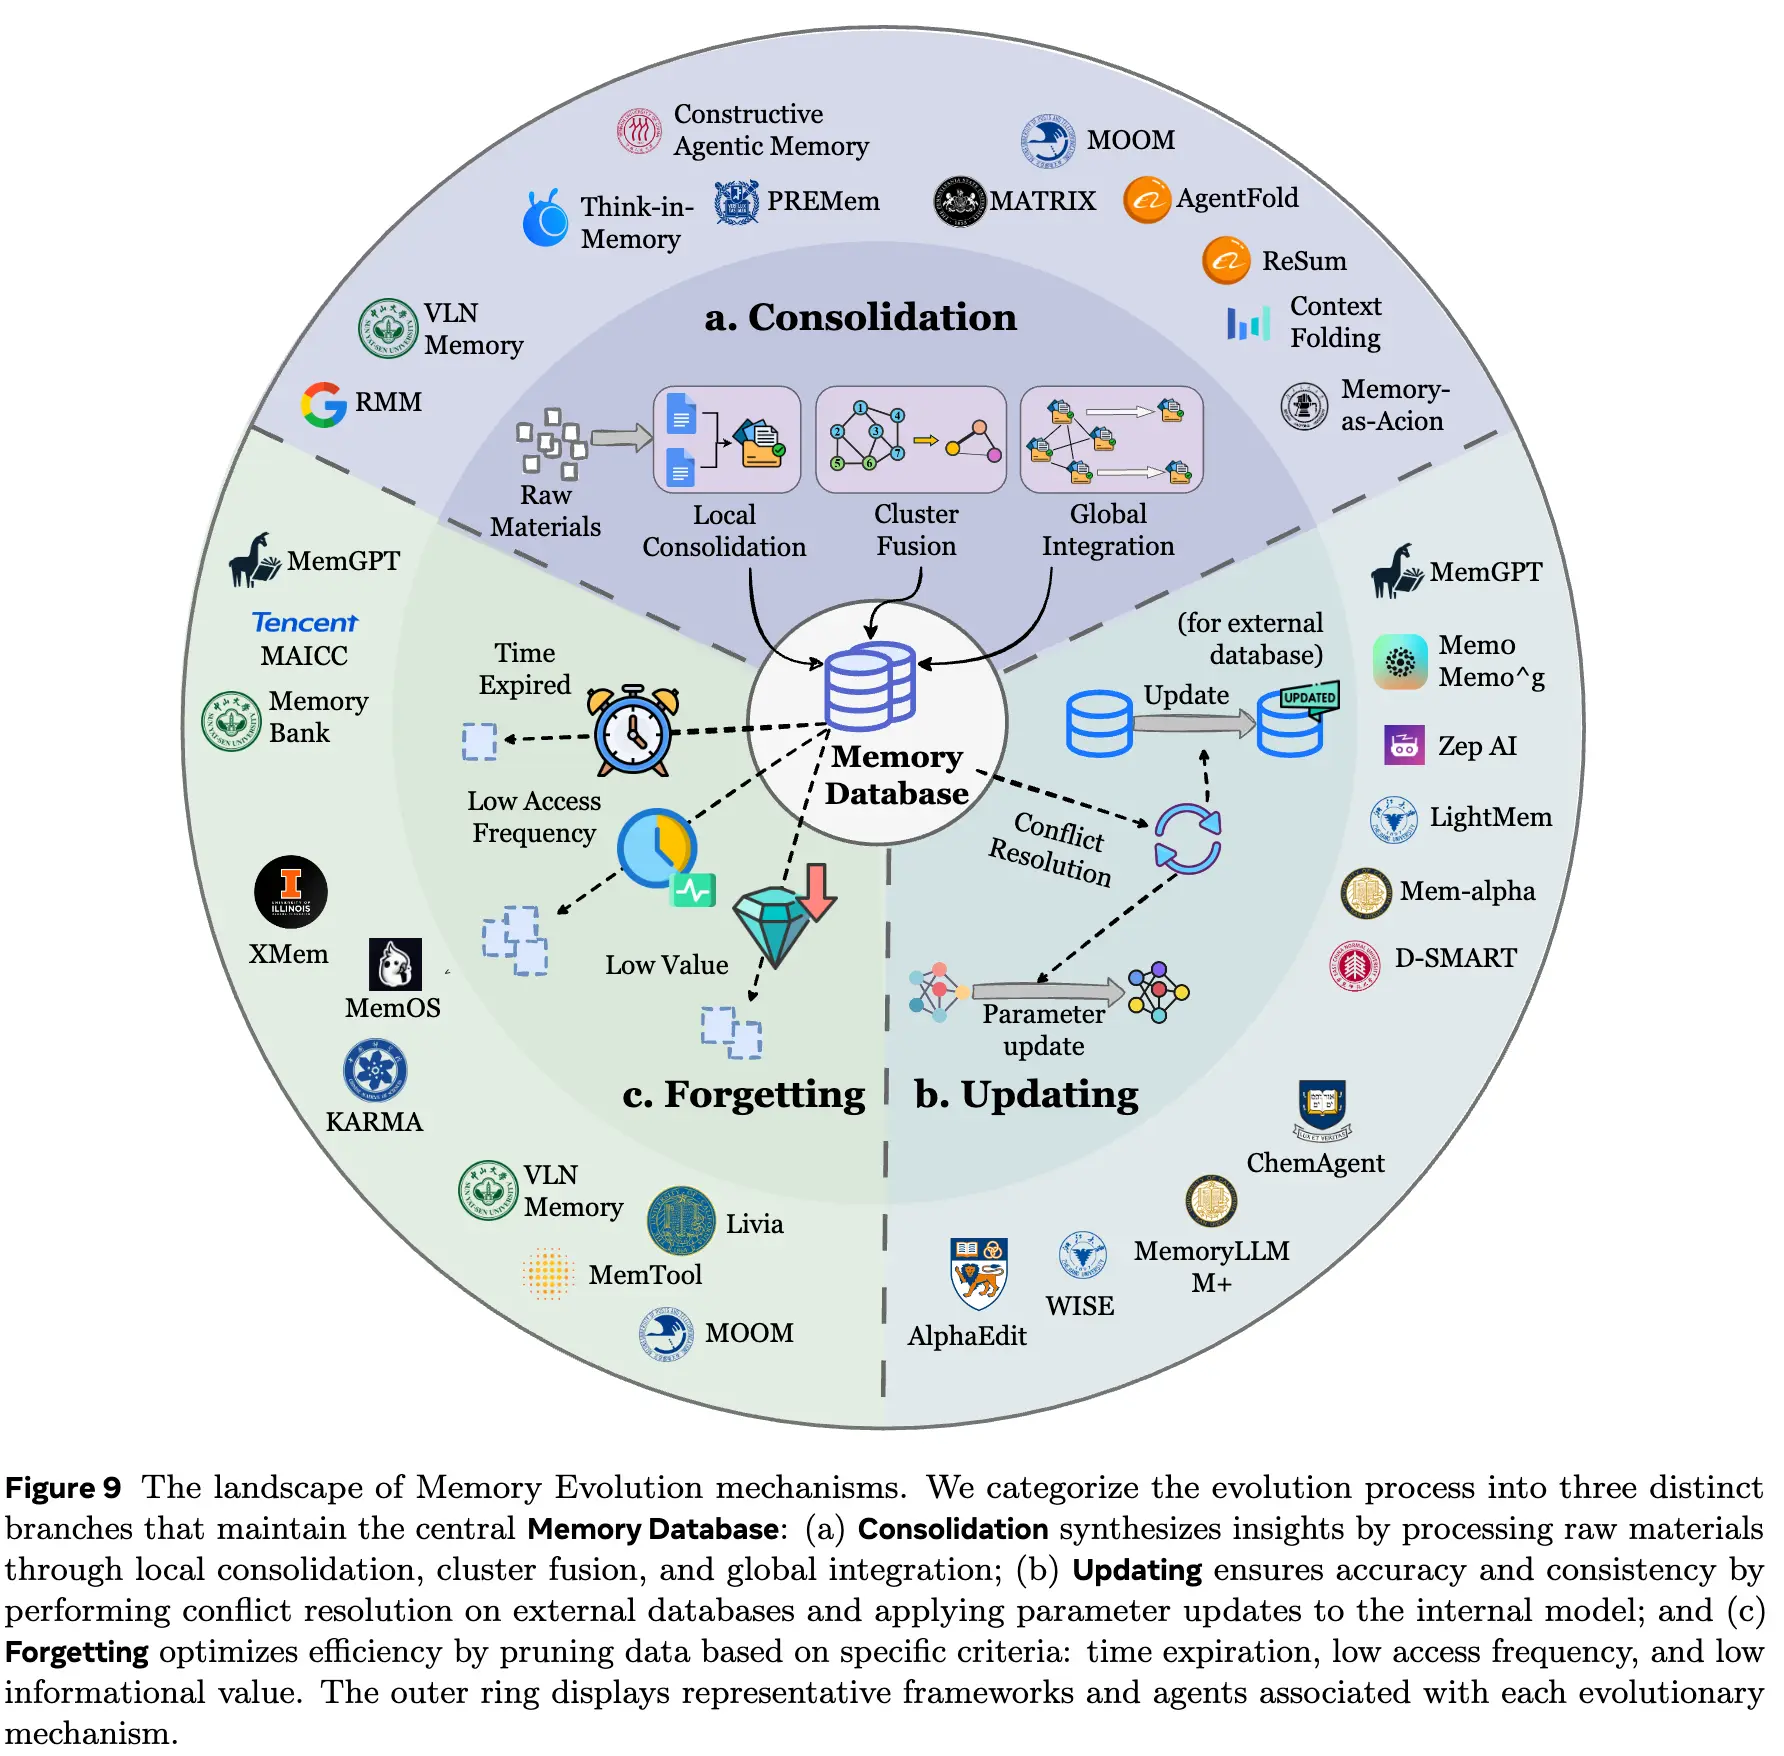
记忆演化关注“记忆与记忆之间”的组织与更新。需要整合新旧记忆,以综合高层次的洞察,解决逻辑冲突,并剔除过时的数据。这也是区别于静态 RAG 的特征。
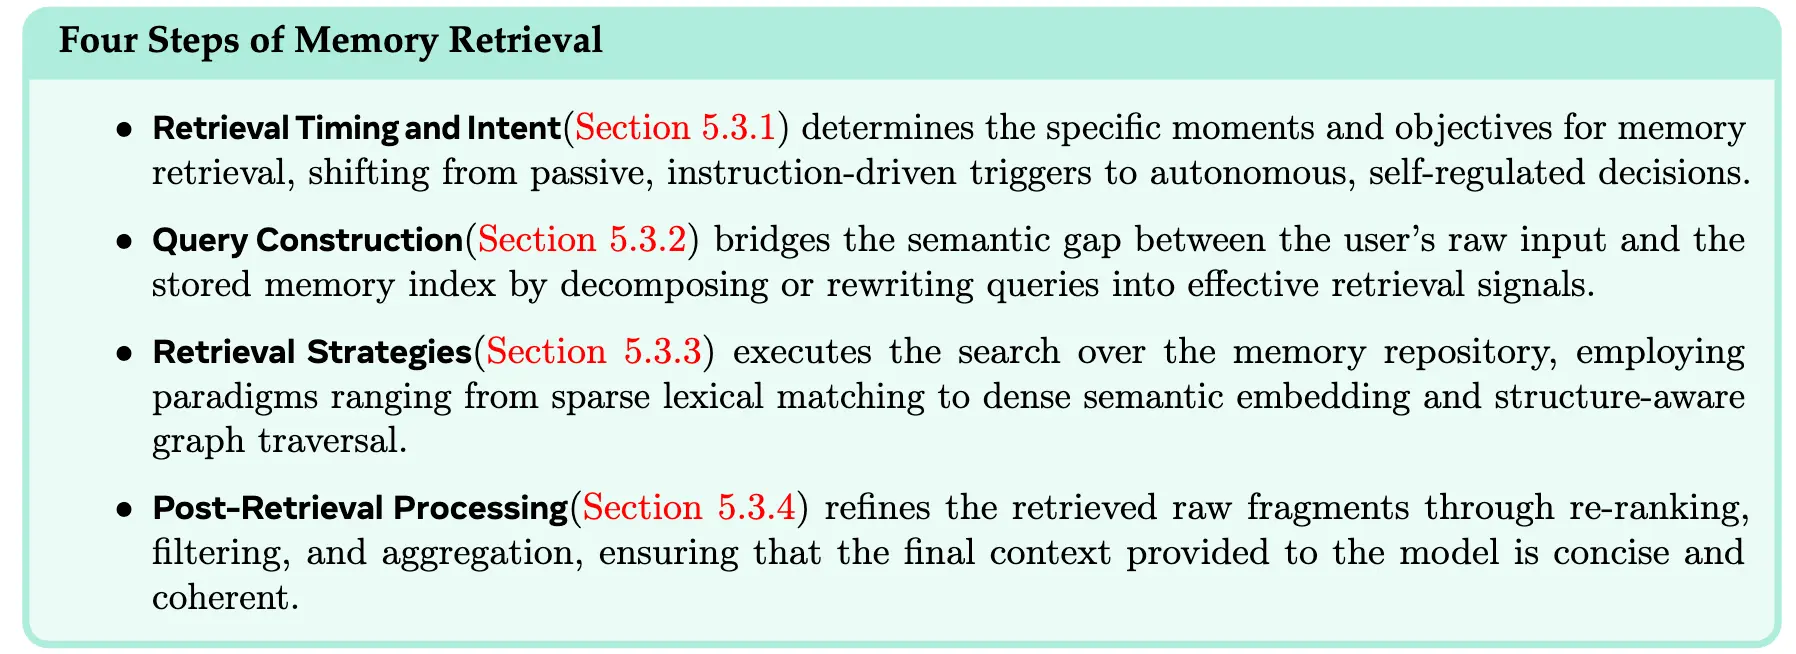
记忆检索关注什么时候去搜、怎么搜、后处理。这是记忆进入到下一次推理时的临门一脚,如果获取、组织都建设很好检索不到那也是差一口气,因此这三者就是一体的。这不仅仅是一个工具调用的事情,还是从静态搜索操作转变为动态认知过程。理想的 agent 会在一个统一的流程中协调上述的组件,使其能够近似地激活类似人类的联想记忆,从而实现高效访问。
资源
我们整理了社区关注的 Memory / Lifelong / Self-Evolving Agents 相关 benchmark,以及现有的记忆开源框架以及产品,提供给读者作为参考。
讨论
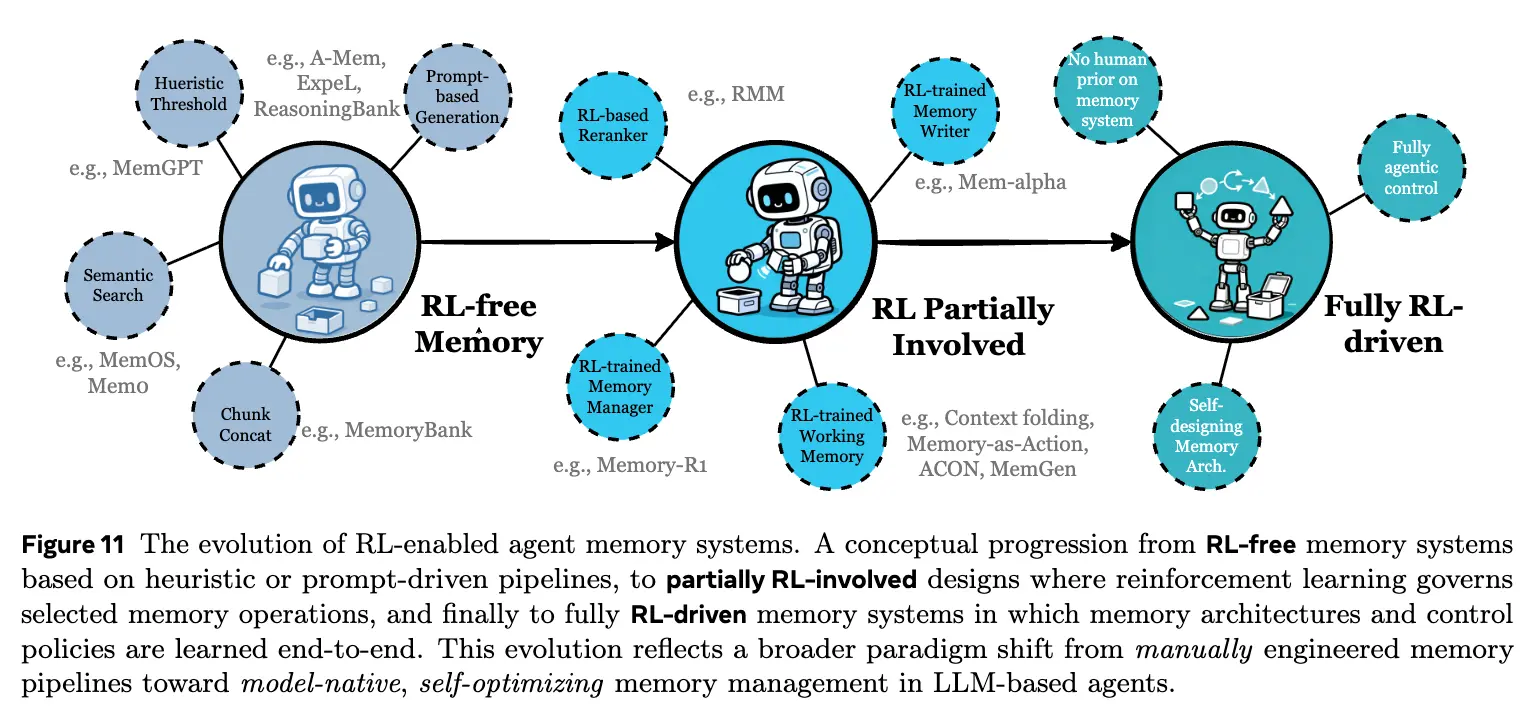
我们在这里列举了一下我们感兴趣的、未来有潜力发展的目标和方向,各个方向都已存在部分工作,供读者参考:
- 生成式记忆:情景自适应、多模态、可学习
- 自动记忆管理:摆脱固定workflow
- RL融合的记忆设计:RL可以用于记忆动态的那些方向,如何逐步去除非必要的先验
- 多模态记忆:从多模态到全模态
- 多智能体共享记忆:如何跨异构通信
- 世界模型:记忆如何辅助进行世界建模
- 可信记忆:记忆本身的安全性、可验证性
- 类人记忆:哪些角度与人类记忆还存在gap
最后
不同于传统的实验室内 level 的合作与沟通,我们四个核心作者完全是网络一线牵:我们在小红书平台上面因为发帖而相识。我们都是 24-25 级的新研究生,有相似的学术背景、年龄、兴趣,一拍即合。Guibin Zhang 是牵头的组织者,展现出了无与伦比的领导力、决断力、深刻洞见,绝对是我认识的同龄人之中的佼佼者;Yuyang Hu 以及 Yanwei Yue 同样是极其优秀的研究者、执行者、思考者,在讨论中有非常密集的思维碰撞以及灵感火花。共同参与工作的合著者、senior phd、老师们都是以非常认真负责、治学严谨的态度来对待这一篇工作。我们希望我们最终的成果能实现我们一开始那看似有些雄心勃勃的目标。
这篇综述从第一次开会到提交前后差不多 2 个月,我们分工明确、交流顺畅、对接密切,高频率迭代。在新时代,跨学校、跨组织、跨机构的合作将会变得越来越频繁与常见,我们相信一致的学术目标和兴趣会是最强的粘合剂,相信真正不朽的学术理想终究跨越大洋、联通世界。