EVPO:基于解释方差的自适应 Critic 策略优化
引言
在大语言模型的后训练阶段,强化学习(RL)已成为提升模型能力的核心范式。一个基本的算法设计选择是:是否使用学习到的 critic(即价值网络)作为策略优化的基线(baseline)?
经典 RL 理论认为,critic 通过提供状态相关的基线来降低策略梯度的方差,这正是 PPO 等 actor-critic 方法的理论基础。然而在实践中,无需 critic 的方法(如 GRPO)凭借其简洁性和有竞争力的表现,获得了广泛采用。这引出了一个核心问题:
在稀疏奖励的 LLM 后训练中,学习到的 critic 究竟何时有益、何时有害?
我们发现,在稀疏奖励设定下,critic 可能注入超过其捕获的状态信号的估计噪声,反而增大而非减小优势估计的方差。通过将基线选择建模为一个 卡尔曼滤波(Kalman Filtering) 问题,我们将 PPO 和 GRPO 统一为卡尔曼增益的两个极端,并证明 解释方差(Explained Variance, EV) 的符号恰好是区分 critic 有益与有害的精确边界。EV 的定义为
我们可以证明,EV 的值与 critic model 的整体质量呈严格的正相关关系:当 critic 给出的预测值与真实 state value 完美吻合时,EV 达到其理论上界(一个由回报固有方差决定的正常数,通常小于 1);随着 critic model 中的噪声越来越大,EV 会逐渐减小;而 则是 critic 相对于常数基线(batch mean)有无提升的临界点——越过这一点之后,使用 critic 反而比 batch mean 更差。
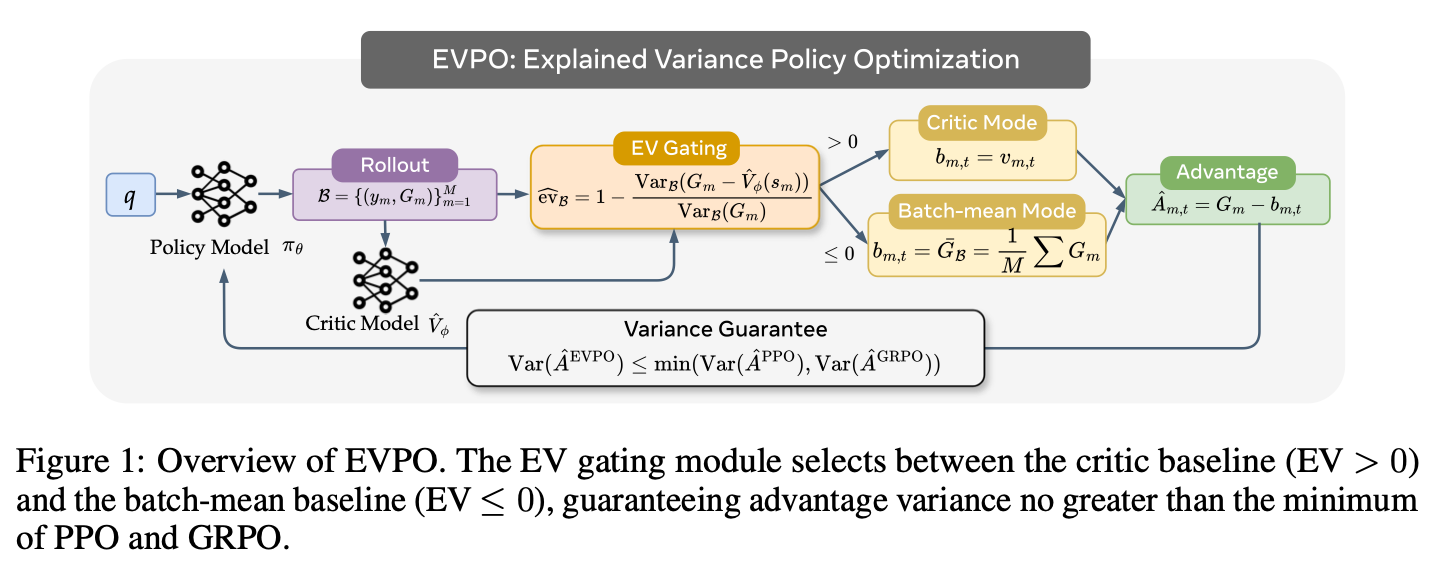
基于这一洞察,我们提出 Explained Variance Policy Optimization(EVPO),一种在每个训练步自适应切换 critic 基线与 batch-mean 基线的轻量级方法,可证明其优势估计方差不超过 PPO 和 GRPO 中的较优者。
核心观察:Critic 并非总是有益的
观察一:噪声 Critic 会损害 Actor
我们在 Sokoban 任务上训练 PPO 策略,并追踪训练过程中的 batch-level EV。如下图所示,在训练初期(约前 150 步),EV 处于较低水平。这是因为此时 critic 几乎是随机初始化的,其预测残差 接近回报本身的方差 ,使得 EV 处于其取值范围的偏低一端,并随之带来这一阶段对应着梯度范数偏高和训练成功率低迷的现象。
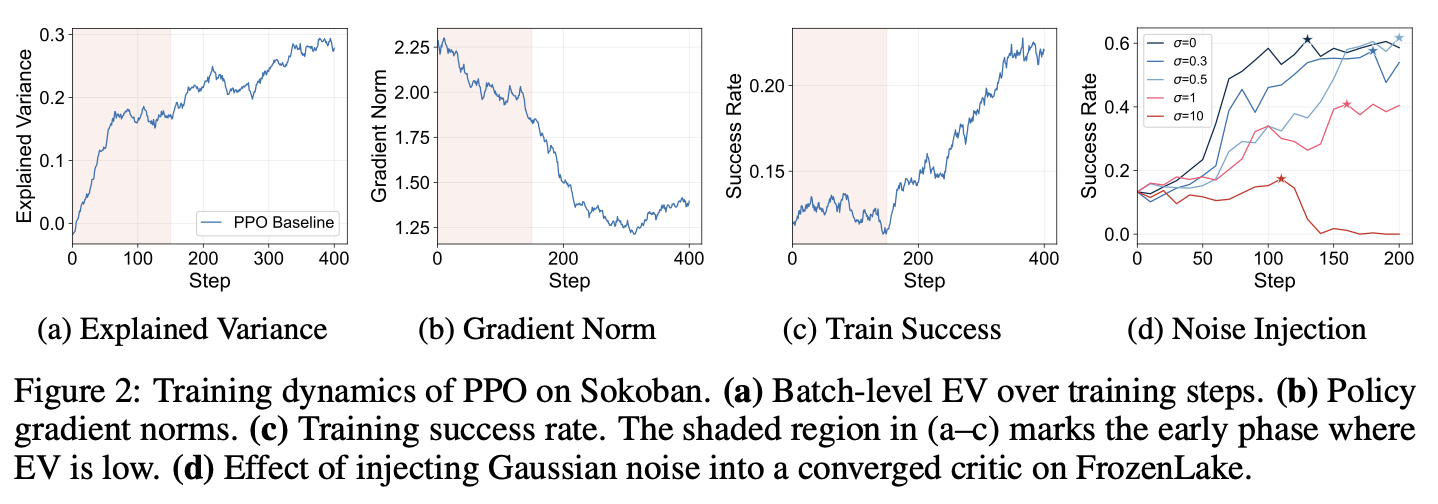
为进一步验证因果性,我们在已收敛的 critic 上注入标准差为 的高斯噪声(上图 (d) 中不同颜色的曲线对应不同的 ,参数化了所注入噪声的强度)。结果表明,随着 增大,EV 被压得越来越低,性能也单调下降;当 EV 被压到足够低时,性能完全崩溃。这确认了 EV 是衡量 critic model 是否可能产生有害影响的可靠指标。
观察二:抑制 Critic 方差有助于 Actor
我们设计了两种干预实验:(i) Cold-start:在训练初期用 batch mean 替代 critic 输出;(ii) Critic Warmup:在 actor 开始训练前先单独预训练 critic。两种方式都带来了更快的收敛和更稳定的训练曲线。
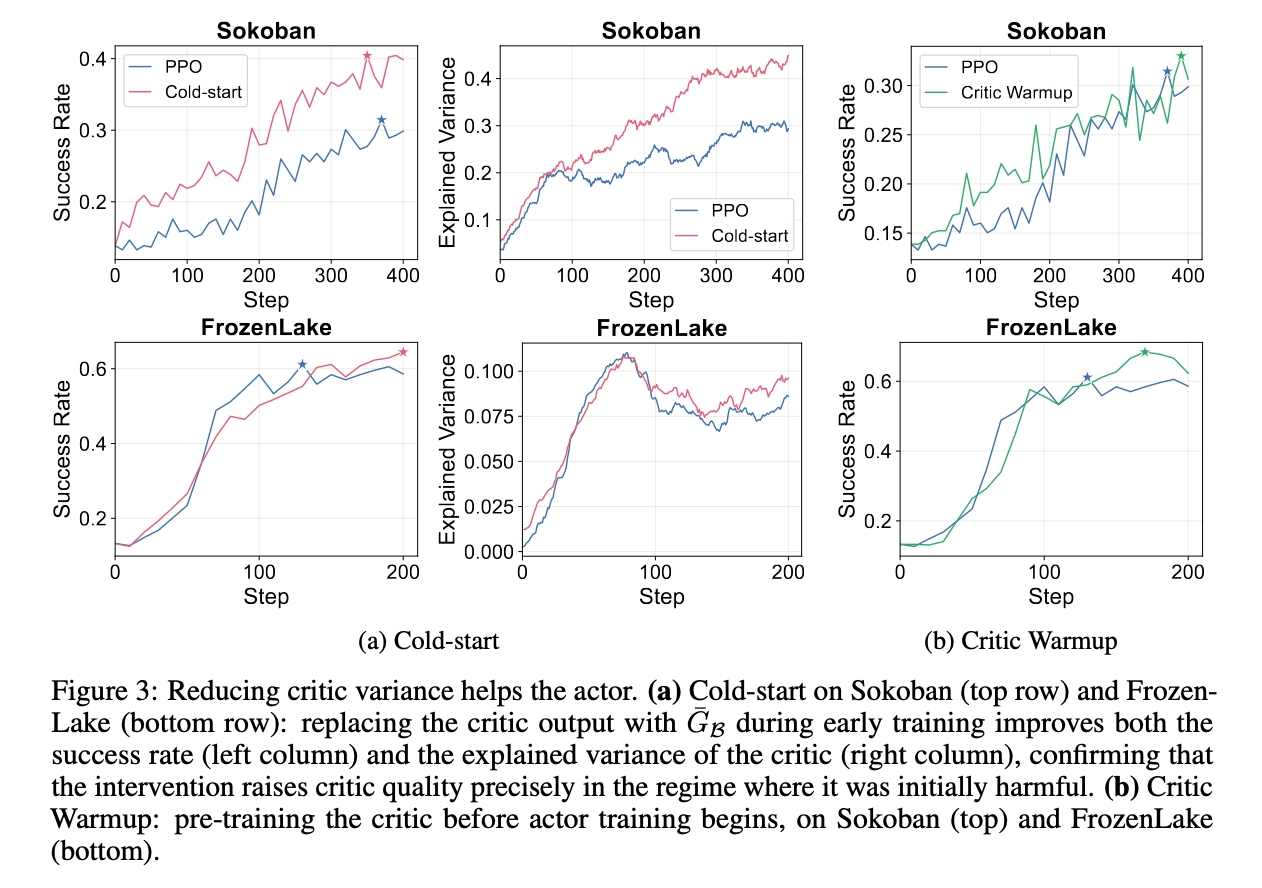
两种干预可以从 EV 的视角得到统一的解释:cold-start 在 critic 尚未成熟时直接用 batch mean 替代,将这一段 EV 较低区间的基线方差直接压到 batch mean 的水平;critic warmup 则通过预训练让 critic 自身的 EV 更早抬升。两者的共同机制都是 提升 EV——这进一步印证了 EV 是判断 critic 是否有效的合适指标。(需要说明的是,图中的 EV 曲线为便于观察,对原始数值做了两步处理:以 0 为下界截断——原始 EV 偶尔会出现极端负值;并取 60 步滑动平均——与训练成功率一样,原始 EV 抖动较大。)
这些观察表明,critic 与 batch-mean 基线的选择不应是先验固定的,而应根据 critic 的实时质量自适应调整。
理论框架:卡尔曼滤波视角
基线选择即状态估计
选择基线本质上是一个 状态估计问题:critic 和 batch mean 都是对真实状态价值 的带噪估计,最优基线应该选择误差更小的那个。这恰好是卡尔曼滤波所解决的问题——最优融合两个带噪估计。
设 critic 的估计误差方差为 ,batch mean 相对于特定状态的误差方差为 ,则最优卡尔曼增益为:
- PPO(,完全信任 critic):基线完全由模型驱动
- GRPO(,不使用 critic):基线完全由数据驱动
两者并非根本不同的算法,而是同一卡尔曼基线选择谱上的两个极端。
EV 的符号标定精确边界
EV 指标(回归分析中的决定系数)直接编码了两个估计器的相对可靠性:
由于分母 始终为正,EV 的符号完全由 决定。这意味着:
- ev > 0 :critic 的估计噪声小于其捕获的状态信号,使用 critic 可以降低方差
- ev 0 :critic 的噪声已超过其信号,应退回 batch mean
Theorem 1(Performance Collapse Boundary) 正式证明了上述等价关系:ev = 0 恰好是分隔 critic 有益区域与有害区域的精确边界。
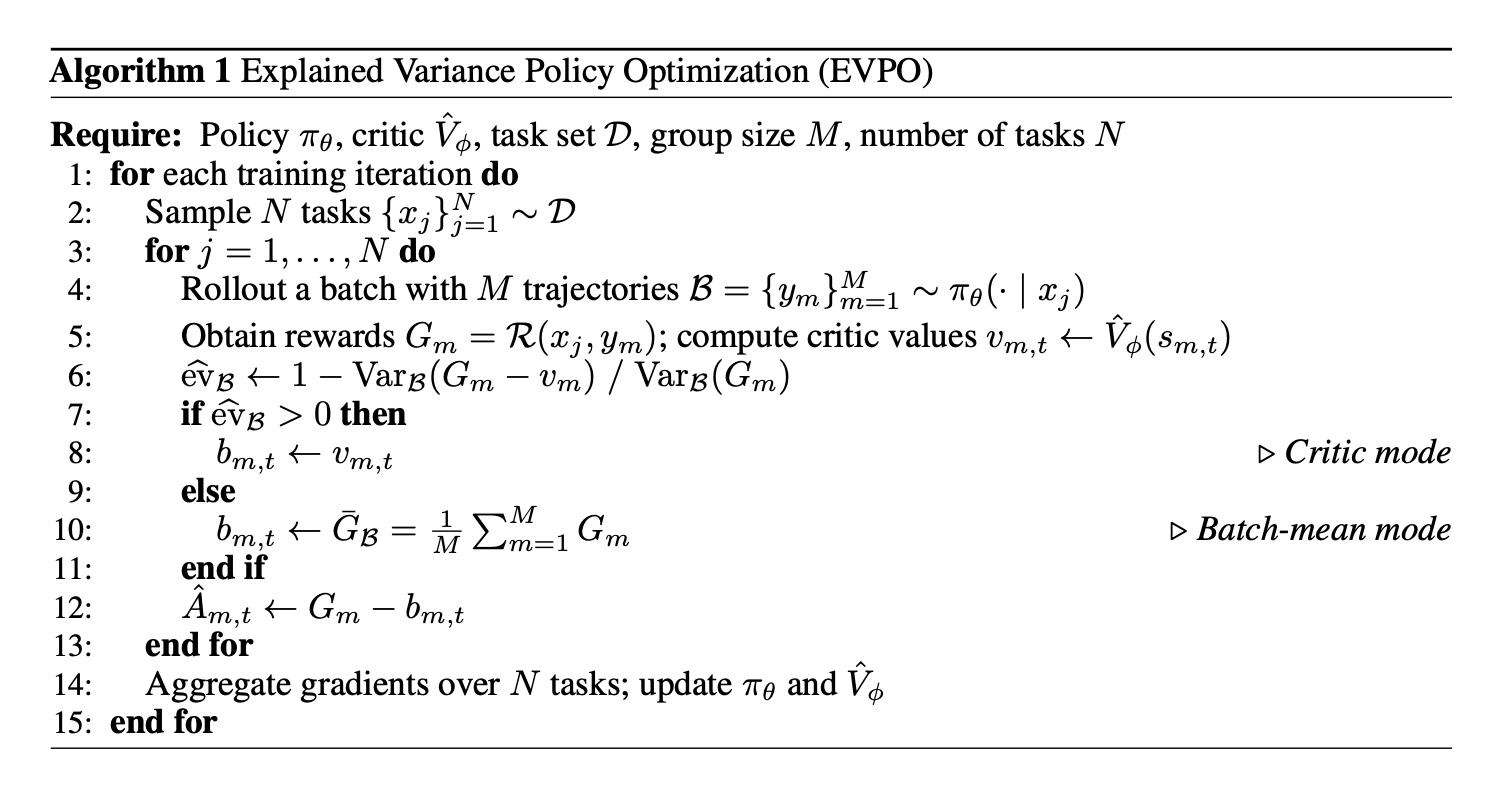
EVPO:通过 EV 门控实现自适应基线选择
算法设计
EVPO 的核心思想极为简洁:在每个训练步,从当前 batch 计算 EV,根据其符号决定使用哪种基线。
其中 batch-level EV 的计算无需额外前向传播,直接从已有的 critic 值和回报中计算:
方差保证
EVPO 通过构造选择方差更低的基线,在每一步保证:
这不超过 或 。累积来看,EVPO 在 critic 冷启动阶段()回退到 batch mean,在 critic 成熟后()充分利用 critic,实现了两全其美。
实验结果
实验设置
我们在四个任务上评估 EVPO,涵盖经典控制(Sokoban、FrozenLake)、交互式决策(WebShop)和数学推理(MATH)。基座模型使用 Qwen2.5-3B-Instruct(MATH 任务使用 Qwen2.5-7B-Instruct),对比方法包括 PPO、StarPO-S、GRPO 和 DAPO。
主要结果
| 方法 | Sokoban | FrozenLake | WebShop | MATH |
|---|---|---|---|---|
| Base LLM | 0.139 | 0.133 | 0.025 | 0.332 |
| PPO | 0.314 | 0.611 | 0.252 | 0.373 |
| StarPO-S | 0.455 | 0.359 | 0.178 | 0.371 |
| GRPO | 0.156 | 0.234 | 0.143 | 0.379 |
| DAPO | 0.162 | 0.207 | 0.127 | 0.385 |
| EVPO (ours) | 0.604 | 0.684 | 0.303 | 0.416 |
EVPO 在所有四个任务上均取得最优表现,且无论哪种固定基线在特定任务上更强,EVPO 都能超越两者。值得注意的是,critic-based 方法(PPO、StarPO-S)在 Sokoban、FrozenLake 和 WebShop 上更强,而 critic-free 方法(GRPO、DAPO)在 MATH 上更具竞争力。EVPO 不依赖于任何单一的有利区域,而是自适应地适应每个任务的 -vs- 平衡。
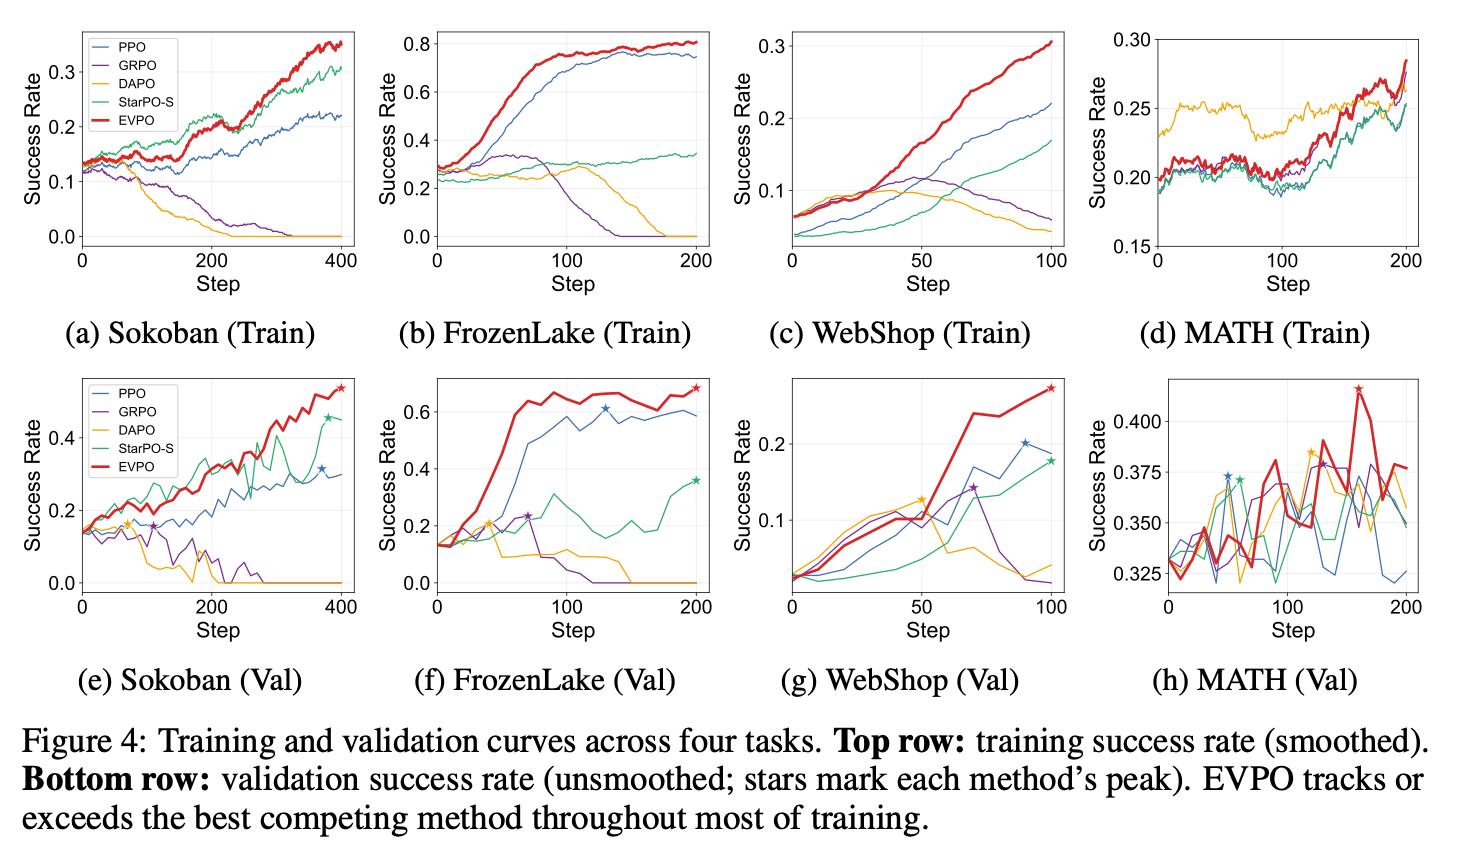
训练和验证曲线进一步表明,EVPO 的优势贯穿整个训练过程,而非仅在收敛时体现。
门控行为分析
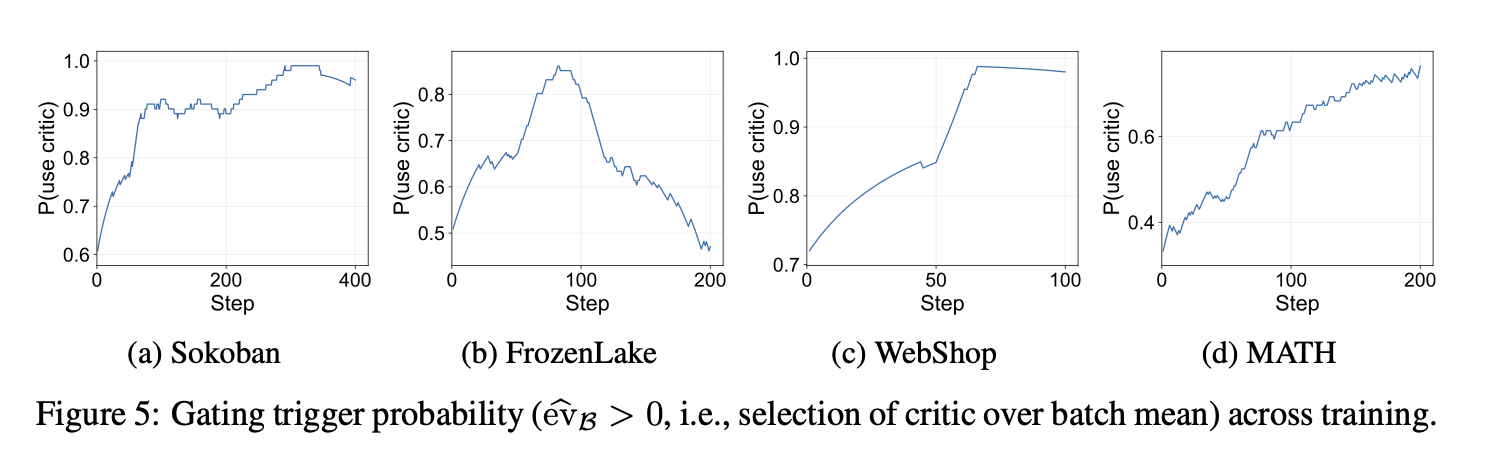
我们追踪了 critic 被选择的概率(即 EV > 0 的频率)。在 Sokoban、WebShop 和 MATH 上,batch-mean 模式在训练早期被频繁触发,随着训练推进逐步减少,反映了 critic 从不成熟到成熟的渐进过程。FrozenLake 上出现了有趣的例外:门控频率在训练中期反转,与训练停滞期吻合,说明自适应门控能够在 critic 质量临时退化时主动回退。
阈值敏感性
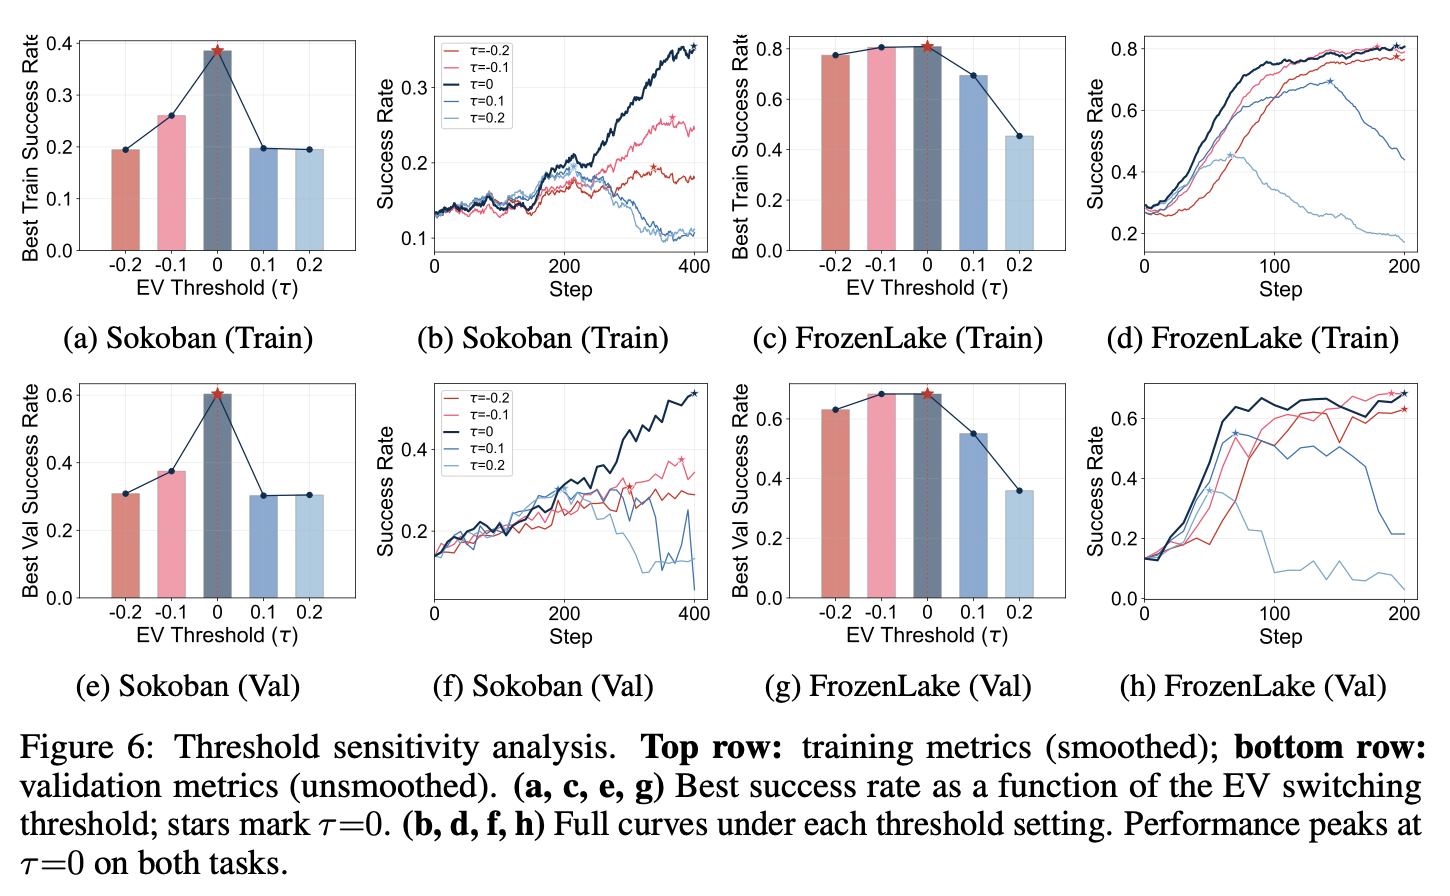
我们扫描了切换阈值 ,发现性能在理论推导的 处达到峰值,并在两个方向上退化——正偏移导致 critic 利用不足(后期缺乏状态相关基线),负偏移导致 critic 过度利用(早期噪声过大)。这验证了理论边界的实际最优性。
结论
EVPO 提出了一种简洁而有理论保证的方法来解决 LLM 后训练中 critic 使用的根本困境。通过卡尔曼滤波的视角,我们揭示了 PPO 和 GRPO 之间的统一关系,并证明 EV 的符号是判断 critic 是否有益的精确边界。EVPO 的自适应切换规则在四个任务上一致优于所有固定基线方法,为 LLM 后训练中的 RL 算法设计提供了新的视角。