AGORA:面向真实职业场景的档案驱动型智能体评测基准
引言
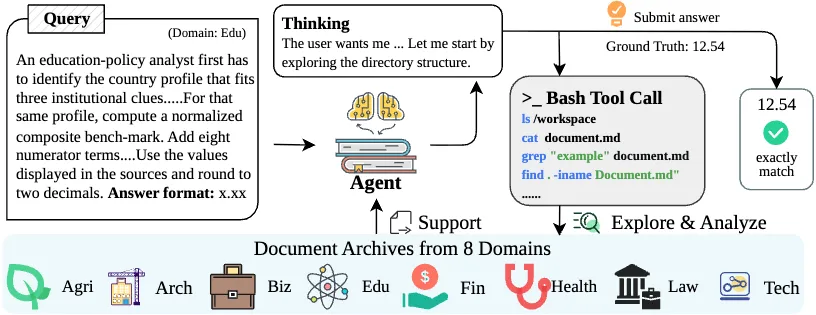 图 1:AGORA 任务设定概览。给定自然语言查询,并配以相应领域的职业文档库,智能体使用 bash 工具浏览文件并执行计算。经过多轮探索与分析后,它提交一个数值答案并与标准答案进行比对验证。
随着大语言模型(Large Language Model,LLM)能力边界的持续拓展,其早已不是单纯的对话机器,而是逐渐演化为能够理解任务意图、调用外部工具、浏览与操作文件,并在复杂数字环境中完成工作的智能体系统。这意味着,人工智能进入真实环境、处理相应工作、为社会创造生产价值,已不再是虚无缥缈的幻想。但我们必须思考一个重要问题:现有智能体能否稳定、可靠地完成真实工作任务,其能力边界究竟在哪里?
现实工作场景通常包含大量结构复杂、内容混杂且来源多样的文档,这使得人们难以高效、准确地从中获取有效信息。近年来,随着智能体能力的飞速提升,其正逐渐展现出处理此类任务的潜力,相关评测基准也在持续增加。然而,这些基准仍存在三个明显的问题:一、网页浏览基准大多运行在开放网络或模拟环境中,而非受限的内部职业文档库中;二、文档问答与表格问答基准通常为阅读理解任务,不要求智能体在文件系统中导航或对异构文档执行多步计算;三、大量基准的语料库来源单一、领域单一,难以覆盖现实世界中各类职业的真实需求。
因此,我们提出 AGORA(Archive-Grounded Office Reasoning Assessment)——一个面向真实办公场景的多领域文档库评测基准,覆盖 8 个常见专业领域,旨在检验大语言模型智能体在内部档案中执行多文档推理的能力。近期,社区也越来越关注智能体的办公表现:Workspace-Bench 通过模拟完整工作区,考察智能体对目录结构、文件依赖、版本谱系以及工作区任务执行过程的理解与处理能力;GDPVal 则面向真实职业中的经济价值任务,评估模型生成报告、文档、表格等专业交付物的质量。与上述工作相比,AGORA 则更加关注真实工作所需的基础能力——跨文档信息检索与计算,考察智能体能否在不同领域的文档库内通过推理排除干扰、定位有效信息并完成严密计算。
| Benchmark | Corpus | #Test | Multi-file | Archive-grounded | Agentic |
|---|---|---|---|---|---|
| HotpotQA | Wikipedia | 7,405 | ✓ | ✓ | ✗ |
| MuSiQue | Wikipedia | 2,459 | ✓ | ✓ | ✗ |
| TAT-QA | Financial reports | 1,669 | ✗ | ✓ | ✗ |
| FinanceBench | U.S. SEC filings | 150 | △ | ✓ | ✗ |
| FRAMES | Wikipedia | 824 | ✓ | ✓ | ✗ |
| OfficeQA Pro | U.S. Treasury bulletins | 133 | ✓ | ✓ | ✓ |
| GAIA | Open Web | 165 | – | ✗ | ✓ |
| BrowseComp | Open Web | 1,266 | – | ✗ | ✓ |
| AGORA (Ours) | Multi-domain office | 362 | ✓ | ✓ | ✓ |
表 1:与代表性的多跳问答、文档问答、RAG 及智能体基准的对比。Multi-file(跨文件):回答一个问题是否可能需要来自多个文件的证据。Archive-grounded(基于固定文档库):推理是否被限定在一个固定语料库内,而非实时网络搜索或开放环境。Agentic(智能体式):作答是否需要主动的文件定位与代码执行。标记说明:✓ = 是,△ = 部分,✗ = 否,– = 不适用。
AGORA 数据集
数据集构成
| Domain | # Docs | # Tokens | # Questions |
|---|---|---|---|
| Agri | 118 | 38M | 71 |
| Arch | 1,005 | 48M | 29 |
| Biz | 358 | 22M | 50 |
| Edu | 152 | 29M | 49 |
| Fin | 5,966 | 117M | 39 |
| Health | 1,233 | 41M | 34 |
| Law | 285 | 30M | 35 |
| Tech | 547 | 47M | 55 |
| Overall | 9,664 | 372M | 362 |
表 2:AGORA 各领域的构成。领域缩写如下:Agri(农业、资源与能源)、Arch(建筑、施工、房地产与设施)、Biz(商业、管理、营销与销售)、Edu(教育、科学与学术)、Fin(金融与经济)、Health(医疗与医学)、Law(法律),以及 Tech(技术、软件与制造)。
AGORA 从真实的工作场景中收集了来自 8 个不同领域的 9,664 份职业文档,总量约 372M token。在此基础之上,我们构造了 362 道自然语言任务,每道任务都需要跨多份文档检索与推理,并且具有唯一、可验证的数值答案。
构建流程
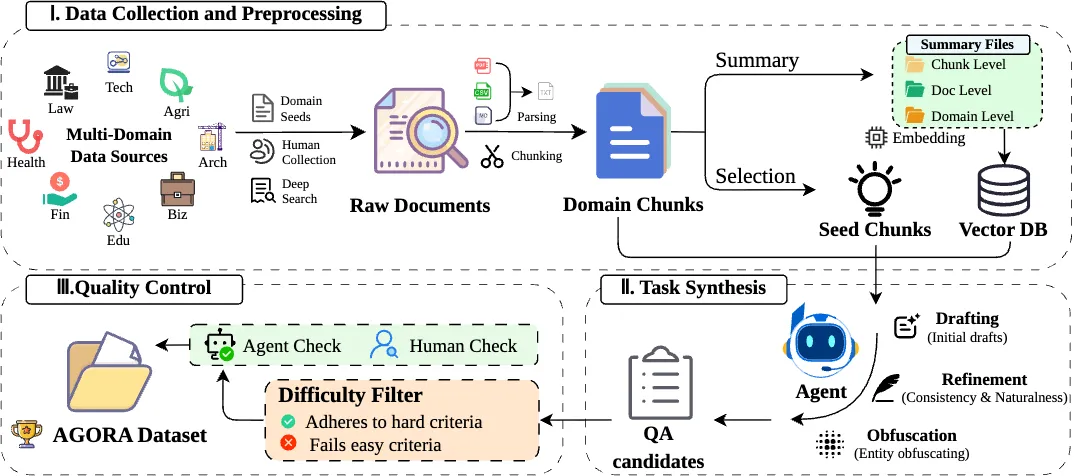 图 2:AGORA 构建流水线概览。阶段一:收集并解析多领域文档,切分为文档切片并索引进向量数据库;阶段二:从种子切片起草任务,并通过精炼与混淆逐步提升题目质量;阶段三:通过难度过滤与多重核查,获得最终任务集合。
我们将 AGORA 的构造流程分为如下三阶段:
- 数据收集与预处理:我们首先调研了官方职业分类体系,从中整合出 8 个主要领域作为“领域种子”;针对每一领域,搜索智能体会检索相关的网络文档并给出候选清单,经人工核验后下载。文档会按格式规则切分并生成三级摘要;再从每个领域中筛选出信息最密集(优先考虑数值、表格和时间序列内容)的 100 个切片作为种子;摘要则编码进向量数据库,供后续检索查询使用。
- 任务合成:在给定种子切片的基础上,智能体会在向量数据库中检索跨文档证据,起草问题,并经过精炼(Refinement,保证一致性、自然性与无歧义)与混淆(Obfuscation,消除题面的答案泄漏和证据泄漏)两阶段强化,来初步保证题目难度和质量。
- 质量控制:首先以闭卷方式用 DeepSeek-V4-Pro 过滤掉仅凭参数化知识即可解出的任务;再由三个模型(GPT-5.5、DeepSeek-V4-Flash 和 DeepSeek-V4-Pro)进行测试,筛除全对的简易题目;随后由 Codex 在“仅问题”与“问题加参考推理链”两种条件下复核题目是否真实可解;最后经过一轮人工核验,得到精选的 362 道任务。
实验评估
实验配置
我们采用 mini-swe-agent 作为智能体框架,设置最高交互轮次 200 轮、时间上限 3,600 秒,对以下模型进行评估:
闭源模型:Gemini-3.1-Pro、Gemini-3.1-Flash-Lite、GPT-5.5
开源模型:DeepSeek-V4-Pro、DeepSeek-V4-Flash、GLM-5.1、Qwen3.5-35B-A3B、Qwen3.5-9B
主要结果
| Model | Agri | Arch | Biz | Edu | Fin | Health | Law | Tech | Overall |
|---|---|---|---|---|---|---|---|---|---|
| Gemini-3.1-Pro | 66.20 | 68.97 | 72.00 | 59.18 | 41.03 | 64.71 | 51.43 | 49.09 | 59.39 |
| GPT-5.5 | 60.56 | 58.62 | 38.00 | 48.98 | 53.85 | 52.94 | 62.86 | 61.82 | 54.70 |
| GLM-5.1 | 59.15 | 58.62 | 38.00 | 34.69 | 56.41 | 50.00 | 51.43 | 52.73 | 50.00 |
| DeepSeek-V4-Pro | 43.66 | 55.17 | 42.00 | 38.78 | 46.15 | 50.00 | 51.43 | 47.27 | 45.86 |
| DeepSeek-V4-Flash | 45.07 | 41.38 | 34.00 | 46.94 | 38.46 | 44.12 | 31.43 | 36.36 | 40.06 |
| Qwen3.5-35B-A3B | 7.04 | 6.90 | 12.00 | 12.24 | 2.56 | 17.65 | 17.14 | 16.36 | 11.33 |
| Gemini-3.1-Flash-Lite | 4.23 | 6.90 | 2.00 | 10.20 | 5.13 | 5.88 | 2.86 | 12.73 | 6.35 |
| Qwen3.5-9B | 2.82 | 0.00 | 8.00 | 2.04 | 0.00 | 0.00 | 5.71 | 3.64 | 3.04 |
表 3:AGORA 上各领域与整体的准确率(%)。模型按整体准确率排序。每列中的最佳结果以加粗表示,次佳以下划线表示。领域缩写沿用表 2。
核心发现
发现一:多文档 QA 对智能体构成显著挑战,且模型性能发生断层
在测试中没有任何模型的准确率超过 60%,即使是最强的 Gemini-3.1-Pro 也只有 59.39% 的 pass@1 准确率,这表明工作多文档 QA 对于智能体仍构成显著挑战。并且八个模型的性能发生了断层,分为了两档:五个前沿模型处于 40–60% 区间,而其余三个则落在 3%~11%,远低于上一档。两档之间 28.73 个百分点的差距超过了任一档内部的最大差值。
发现二:模型能力存在领域依赖性
整体准确率会从两个方面掩盖模型表现的领域依赖性。其一,没有任何模型能在所有领域都保持领先:整体领先的 Gemini-3.1-Pro 在金融领域仍跌至 41.03%,GPT-5.5 在商业领域也降到 38.00%。其二,各领域的排名与整体排名并不一致:Gemini-3.1-Pro 在八个领域中有五个位居第一,却在金融领域仅列第四,落后于 GLM-5.1、GPT-5.5 和 DeepSeek-V4-Pro;而 GPT-5.5 则在法律和技术领域领先。可见,整体表现优异并不意味着模型在每个领域都同样可靠。
深入分析
跨领域性能分析
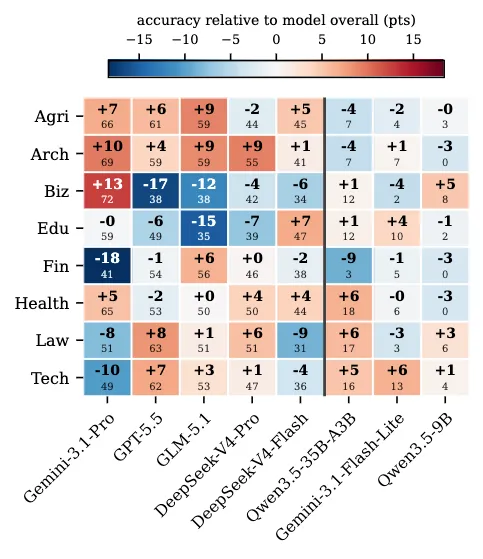 图 3:AGORA 各模型分领域准确率相对其整体准确率的偏差。每个单元格显示带符号的残差(大字)与原始准确率(小字);红色表示高于该模型的平均水平,蓝色表示低于平均水平。竖线将前沿模型层与接近最低水平的模型分隔开。
智能体的多文档推理能力是否能跨领域迁移?并不能。
图 3 的残差表明:难度在很大程度上是“模型—领域”二者共同决定的,而非由领域自身单独决定。例如商业是 Gemini-3.1-Pro 表现最好的领域,却是 GPT-5.5 表现最差的领域,这一影响足以重排榜单:DeepSeek-V4-Pro 整体上落后 GPT-5.5 8.8 个百分点,却在商业领域反超对方。而且,这种领域间的不平衡并不会随模型规模的增大而减弱。在前沿模型中,表现最强的 Gemini-3.1-Pro 反而最不均衡:它整体领先,但领域间差距也最大,最好与最差领域相差达 30.97 个百分点。可见,整体实力与领域均衡是两个相对独立的维度,前者的亮眼表现可能掩盖后者的不足。但反过来,领域差距小也不代表均衡——小模型的领域差距之所以小,只是因为它们在所有领域的准确率都普遍偏低。
错误类型分析
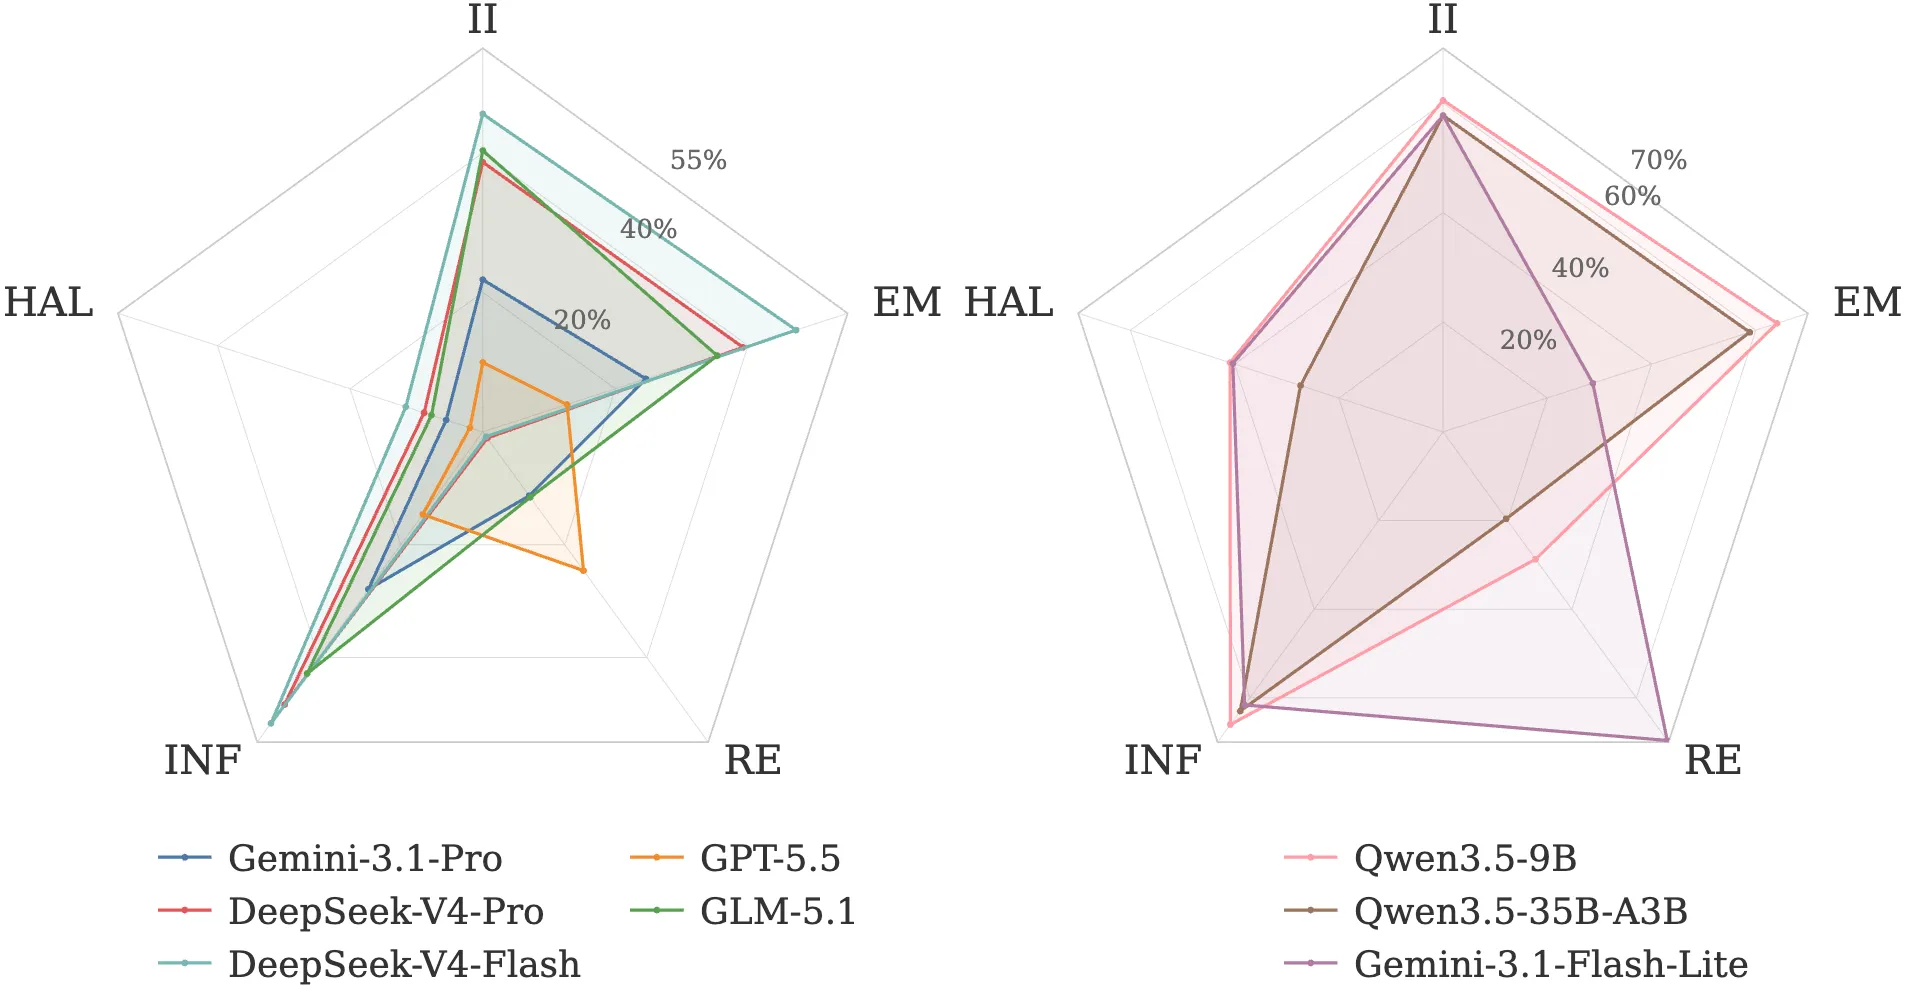 图 4:五类失败模式的占比,以每一类所涉及的问题数占 AGORA 全部 362 道问题的比例表示。前沿模型(左,ymax = 55%)与较低层模型(右,ymax = 70%)采用不同刻度。失败模式缩写为:II(检查不完整)、EM(证据查找错误)、RE(资源耗尽)、INF(指令未遵循)、HAL(幻觉)。
我们对每一条错误轨迹进行标注,并将标注结果归并为五个类别。从中我们发现了三个规律:
- 几乎所有模型的错误都集中在三类与证据相关的失败(II、EM、INF),表明解题瓶颈在于证据的定位与运用。
- 资源耗尽因模型而异:这是 GPT-5.5 最主要的失败原因,占比达 24.59%;DeepSeek-V4 系列几乎不受此影响(≤1.10%);而 Gemini-3.1-Flash-Lite 的资源耗尽比例则高达 69.61%。
- 前沿模型幻觉占比始终低于 12%,而小模型幻觉却升至约 40%,表明这两个层级之间的差距源于是否严格遵循证据作答,而非推理能力的深浅。
交互轮次分布
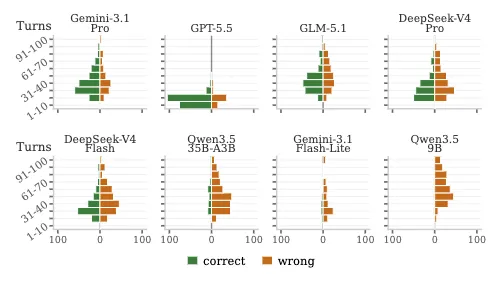 图 5:各模型在 AGORA 上的交互轮次分布。每个 episode(任务交互过程)按智能体给出最终
<answer> 标签时所处的轮次分层,并按结果(正确/错误)划分;括号内的数字表示已提交答案的 episode 数。横轴截断于 100,因为更长的 episode 较为罕见。
在所有模型上,正确结果都集中于中低轮次,而耗到预算尾部的 episode 大多是错的。这一现象表明,冗长的探索轨迹更多反映的是智能体迷失了方向、陷入重复且低效的探索,而非正在逐步逼近正确答案。智能体若未能在早期解决问题,通常也难以通过延长搜索来挽回。
结论
我们提出了 AGORA,一个面向智能体办公文档推理的跨领域测试基准。它包含 362 个可验证的数值型问题,覆盖 8 个不同领域的 9,664 份文档,总计约 3.72 亿 token。AGORA 由一套智能体驱动的流水线构建而成,该流水线融合了跨文档任务合成、防泄漏混淆,以及结合人工核验的难度过滤。AGORA 同时强调三个方面:基于固定职业文档库作答、智能体的自主探索,以及跨领域覆盖。在对八个模型的评测中,我们发现这一任务远未被攻克:即便最强的模型也仅达到 59.4% 的准确率;逐领域分析更揭示出单一来源的基准无法暴露的系统性盲点与排名反转。我们希望 AGORA 能成为新一代文档推理智能体的一个严格、可复现的试验平台。